När en PDF inte bäddar in ett teckensnitt renderar HotPDF-komponenten den texten med ett installerat Windows-teckensnitt valt av HPDFMapBaseFontToSystem: den avkodar /BaseFont-namnet, klipper av stiländelsen, provar flera stavningar tills GDI bekräftar att familjen är installerad, mäter saknade standard 14-bredder från metriskt kompatibla teckensnitt och konverterar enbyte-koder till Unicode före ritning. Varje steg finns för att den naiva versionen misslyckades på riktiga filer. Sidrenderaren RenderLoadedPageToBitmap hanterar inbäddade program bra; detta är historien om de teckensnitt som inte finns i filen alls
Varför ritar GDI tyst fel typsnitt för ett icke-inbäddat teckensnitt?
GDI rapporterar aldrig ett saknat teckensnitt: ge CreateFontIndirect ett familjenamn den inte känner och den väljer tyst en ersättare, ofta en annan serif utan fet vikt. Den tidiga renderaren skickade PDF-namnet nästan ordagrant, så TimesNewRoman,Bold, TimesNewRomanPS-BoldMT och SegoeUI-Semibold matchade ingenting och kom ut i vad GDI än valde. Namn kan vara värre än så. ISO 32000-1 §7.3.5 låter ett namn skriva vilken byte som helst som #xx, och CJK-producenter stavar rutinmässigt fontnamn som escapad UTF-8 eller äldre kodsidebyte; före v2.766.69 blev själva escape-sekvenserna familjenamnet. HPDFMapBaseFontToSystem avkodar nu escape-sekvenserna först, returnerar en giltig UTF-8-byttesekvens som sina tecken och läser övriga höga byte i systemets kodsidan
Att klippa av stilen är där heuristiken biter. Ett kommatecken avslutar alltid familjen (Arial,Bold ger Arial), men ett bindestreck gör det bara när ordet efter det är en stil: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra eller Condensed. Regeln håller MS-Mincho intakt medan Calibri-Light blir Calibri. HotPDF provar sedan stavningar av familjen, följt av stavningar av familjen med suffixen PSMT, MT eller PS avlägsnad. Sedan v2.768.18 täcker stavningarna varje val av mellanrum på de ställen ett ord kan börja: före en versal som följer en gemen (MyriadPro blir Myriad Pro), vid den sista versalen i en följd som en gemen följer (UIGothic), och efter ett inledande MS (MSPGothic), från den helt mellanrumssatta formen ner till namnet som skrivet; efter fyra sådana ställen provas bara den helt mellanrumssatta och det sammanfogade namnet. Mellanrum kan inte appliceras blint, för Windows håller vissa ord sammanfogade: SimSun är installerat under exakt den stavningen, medan MicrosoftYaHei, MicrosoftJhengHei och MSPGothic hör till Microsoft YaHei, Microsoft JhengHei och MS PGothic. Före v2.768.18 satte mapparen ett mellanslag framför varje inre versal, så MicrosoftYaHei söktes som Microsoft Ya Hei och hittades aldrig. En kandidat räknas som installerad när CreateFontIndirect följt av GetTextFace returnerar det begärda namnet eller, sedan v2.768.18, när det valda teckensnittets name-tabell listar det som familj, fullständig eller typografisk familj i vilket språk som helst; svaret cachas per namn, så dokument med många icke installerade teckensnitt frågar inte Windows om varje namn på varje sida
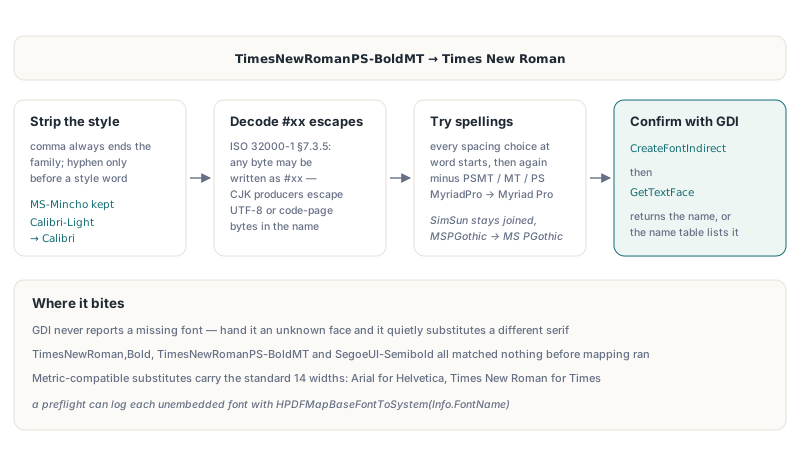
Eftersom mappningsfunktionen är publik i uniten HPDFRenderFontMetrics kan en preflight-rapport visa vilket installerat teckensnitt varje icke-inbäddat font renderas med, via den fontuppräkning THotPDF redan exponerar för inlästa dokument:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Hur mäter HotPDF standard 14-teckensnitt som saknar /Widths?
HotPDF mäter de saknade advance-värdena på det installerade teckensnittet med samma metriker, för ISO 32000-1 §9.6.2.2 tillåter standard 14-teckensnitten att utelämna /Widths och biblioteket levereras utan AFM-tabeller. Arial bär Helvetica-metriker, Times New Roman bär Times och Courier New bär Courier, så HPDFMeasureBaseFontWidths skapar den matchande fonten med lfHeight = -1000 och anropar GetCharWidth32W; vid den höjden är resultatet redan i de 1/1000 em-enheter PDF-bredder använder. Renderaren förvandlar först varje kod till Unicode genom /Encoding, /BaseEncoding och /Differences, med StandardEncoding som standard. SVG-export och textextraktion träffar en fälla till: ett standard Type 1-teckensnitt utan någon /Encoding alls gav en avkodare utan kodningsinformation, SVG-export registrerade den aldrig, och varje mätt bredd förblev oanvänd. Att tillhandahålla den underförstådda StandardEncodingen fixade det, förutsatt att den markeras som en fördefinierad kodning; routas den ner i CMap-namnvägen avkods varje kod som 0 och varje bredd följer efter
Bold, italic och en off-by-one i fontdeskriptorns flaggor
/Flags-posten i en fontdeskriptor numrerar sina bitar från 1, inte 0, så ForceBold är bit 19 ($40000) och Italic är bit 7 ($40), enligt ISO 32000-1 tabell 123. Den gamla koden testade $20000, som är bit 18, SmallCap. Misstaget överlevde från v2.345.0 till v2.766.53 eftersom /FontDescriptor nästan alltid är en indirekt referens och fontbyggaren bara läste direkta objekt, så hela flagggrenen kördes aldrig, och samma blindhet ignorerade /Widths 12 0 R och satte upp text med en fallback-advance på 500 enheter. När v2.766.53 började lösa indirekta referenser genom renderaren måste biten rättas i samma ändring, annars skulle varje small-caps-font plötsligt ha renderats fet:
const
  // ISO 32000-1 tabell 123 räknar bitpositioner från 1
  FD_ITALIC     = $00040;  // bit 7
  FD_SMALLCAP   = $20000;  // bit 18, ingen vikt
  FD_FORCEBOLD  = $40000;  // bit 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;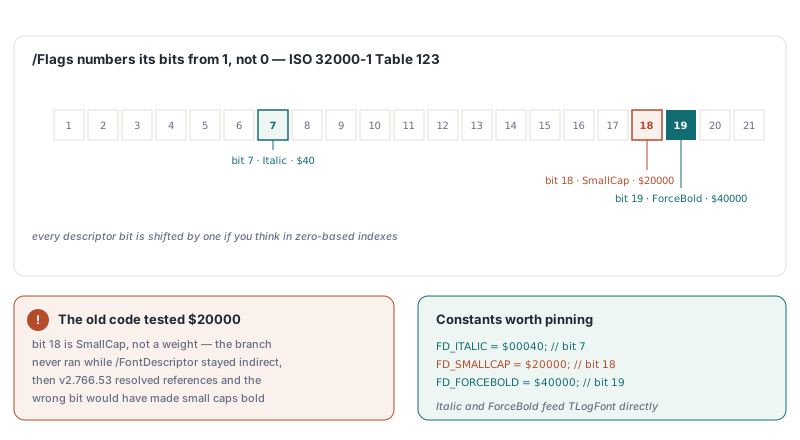
Varför får CJK-teckensnitt med en UCS2-CMap fel bredder?
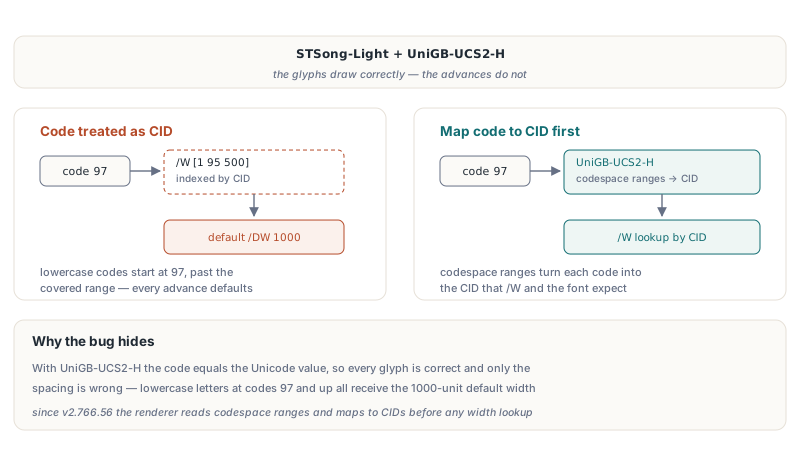
CJK-text med en fördefinierad UCS2-CMap ritar rätt glyfer men fel mellanrum när en renderare behandlar koden som CID, eftersom /W indexeras med CID, inte med teckenkod. Med STSong-Light och UniGB-UCS2-H råkar koden vara lika med Unicode-värdet, så GDI ritar rätt tecken och buggen gömmer sig i advance-värdena: gemena bokstäver anländer som koder 97 och uppåt, hamnar utanför en /W-post som [1 95 500] och får alla standardbredden /DW på 1000. Sedan v2.766.56 läser HotPDF-renderaren koder genom CMap:ens codespace-intervall (ISO 32000-1 §9.7.6.2) och mappar dem till CID:er innan bredderna slås upp. Bara de inbyggda UCS2- och UTF16-tabellerna och inbäddade CMap-strömmar används; en identitetsapproximation för något som GBK-EUC-H skulle bara låtsas stödjas medan den producerade fel utdata, så renderaren låtsas inte
Varför förvandlas diakritiska tecken till frågetecken på kinesiskt Windows?
Enbyte-koder får aldrig nå GDI:s ANSI-("A"-)funktioner, för GetGlyphOutlineA och GetGlyphIndicesA tolkar byte i systemets kodsidan medan TextOutA använder det valda teckensnittets teckenuppsättning. På ett kinesiskt system blev Arial-byten $A9 (upphovsrättstecknet i Windows-1252) en GBK-leadbyte och renderades som "?", en fälla som den unhintade konturvägen tillagd i v2.766.83 stegade rakt in i. v2.767.3 frågar den realiserade fonten om dess teckenuppsättning med GetTextCharset, konverterar den till en kodsidan genom TranslateCharsetInfo, kör byten genom MultiByteToWideChar och anropar W-funktionerna; symbolteckensnitt använder U+F000 plus koden i stället. Kodningar som inte stämmer med Windows-1252 — /Differences, StandardEncoding, MacRomanEncoding — mappas till Unicode innan något systemteckensnitt ser dem
Vilka är gränserna för att rita med systemteckensnitt?
Rendering med systemteckensnitt är en approximation, och HotPDF-komponenten är ärlig om var den stannar. Före v2.768.18 jämförde installationskontrollen bara namnet GetTextFace returnerar, och på lokaliserat Windows rapporterar den funktionen familjenamnet på systemspråket, så Microsoft YaHei på kinesiskt Windows eller Yu Mincho på japanskt Windows bedömdes saknas och ritades med en GDI-ersättare; sedan v2.768.18 slås också en font som kommer tillbaka under annat namn upp i teckensnittets name-tabell, och sådana teckensnitt hittas. Metrisk kompatibilitet garanteras bara för Helvetica-, Times- och Courier-familjerna; Symbol mappas till Symbol och ZapfDingbats till Wingdings, vilket är en nödutgång snarare än en matchning. Preflighten ovan ser också bara teckensnitt i varje sidas /Resources-ordbok, inte de som refereras inifrån formulär-XObjects. När en kod fortfarande inte kan ritas rapporterar spårningen av olösta glyfer vid ritning det, vilket är en bättre signal än att ögonmäta miniatyrer
Den varaktiga fixen sitter på författarsidan. HotPDF själv skriver med FontEmbedding satt till True som standard och byter till ett inbäddat Arial även när koden anropar SetFont med Helvetica, och inbäddad text går genom renderaren för inbäddade fontglyfer i stället för något av gisslandet ovan. En billig vakt för inkommande filer är att varna före rendering när en mappad familj inte finns i listan över skärmteckensnitt:
// VCL: Screen.Fonts listar installerade familjenamn (Forms-uniten)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
För hela komponenten, inklusive sidrendering, textextraktion och fontsubsetting på skrivsidan, se produktsidan för HotPDF Delphi PDF component