PDF Library for Delphi kan slå ihop bilder inuti en PDF som ser likadana ut men inte är byteidentiska, via DeduplicateSimilarImages. Exakt avdublettering slår bara ihop bilder vars ordlistor och kodade nyttolaster matchar; den här jämför istället hur bilderna faktiskt ser ut, med hjälp av en perceptuell hash plus två pixelfeltrösklar, och dirigerar om varje referens till ett enda kanoniskt objekt
De filer där detta lönar sig är de som växte av misstag. En skannad batch där varje sida bär samma logotyp omkodad av en annan skanner. En rapport sammansatt av källor som var och en bäddade in samma diagram i en något annorlunda JPEG-kvalitet. En katalog vars miniatyrer regenererades av två verktyg. I varje fall innehåller filen många kopior av en bild, och exakt avdublettering kan inte röra någon av dem
Vad "tillräckligt lika" måste betyda
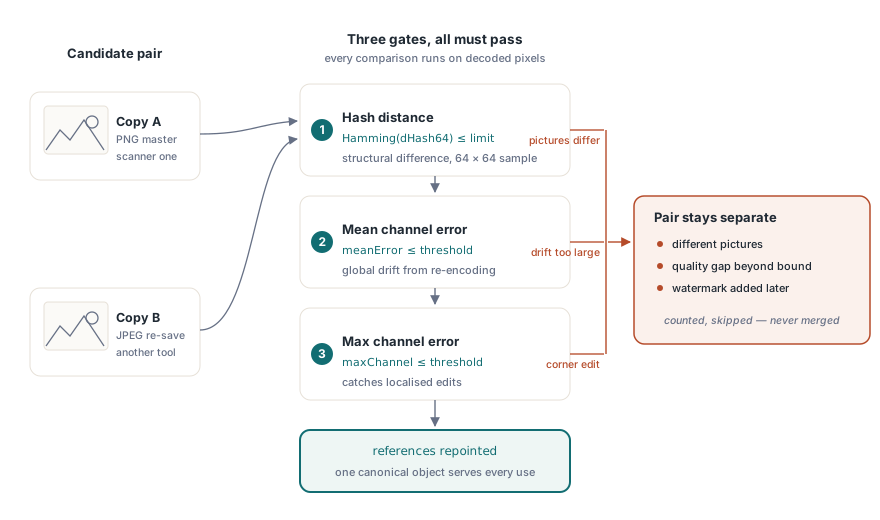
Tre trösklar måste alla uppfyllas innan två bilder slås ihop, och var och en fångar en annan typ av skillnad. Det perceptuella hashavståndet begränsar strukturell skillnad: en 64-bitars differenshash beräknas från ett 64 gånger 64-sampel av den avkodade bilden, och det tillåtna Hamming-avståndet går från 0 till 7. Medelkanalfelet begränsar övergripande avdrift, vilket är vad omkodning ger. Det maximala enkelkanalsfelet begränsar lokaliserad skillnad, vilket är vad en liten redigering ger
Att kräva alla tre är det som gör sammanslagningen försvarbar. En bild som skiljer sig genom en vattenstämpel i ett hörn har ett lågt medelfel och ett högt maxfel, så maxfelsgrinden avvisar den. En bild som har omkomprimerats har ett litet fel överallt, så den godkänns. Det är exakt den distinktion en storleksoptimerare behöver dra
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Hashavstånd 2, medelfel 2, enkelkanalsfel 4.
    // Alternativ kan begära en testkörning så att inget ändras
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
Semantisk identitet kommer före visuell likhet
Innan några pixlar jämförs måste kandidatbilder överensstämma semantiskt. Biblioteket bygger en stabil signatur från hela bildordlistan exklusive /Length, /Filter och /DecodeParms, så dimensioner, färgrymd, bitdjup, masker, /Decode-arrayen, interpolering, medlemskap i valfritt innehåll och metadata måste alla matcha
Denna ordning förhindrar en hel klass av felaktiga sammanslagningar. Två bilder kan se identiska ut i ett 64 gånger 64-sampel och bete sig olika på sidan: en med /Interpolate sant och en utan kommer att jämnas ut olika vid skalning, och en som tillhör en grupp för valfritt innehåll kommer att försvinna när det lagret döljs. Att slå ihop över dessa gränser ger ett dokument som är mindre och fel
Bara indirekta Image XObjects skannas. Inline-bilder är en annan konstruktion med en annan ekonomi, och bilder som inte kan avkodas hoppas konservativt över och räknas snarare än slås ihop på tro — inga pixelbevis, ingen sammanslagning
Hur sökningen förblir billig
Att jämföra varje bild mot varje annan bild är kvadratiskt, vilket är oacceptabelt på ett dokument som innehåller tusentals bilder. Hashen delas därför upp i åtta 8-bitars band med ett ordnat index över vart och ett
Lådprincipen gör resten: om två hashar skiljer sig med som mest 7 bitar måste de överensstämma exakt på minst ett av de åtta banden. Att slå upp kandidater band för band hittar därför varje tillåten matchning utan en uttömmande parvis skanning, och den publicerade gränsen på 7 finns just för att garantin bara håller upp till det avståndet
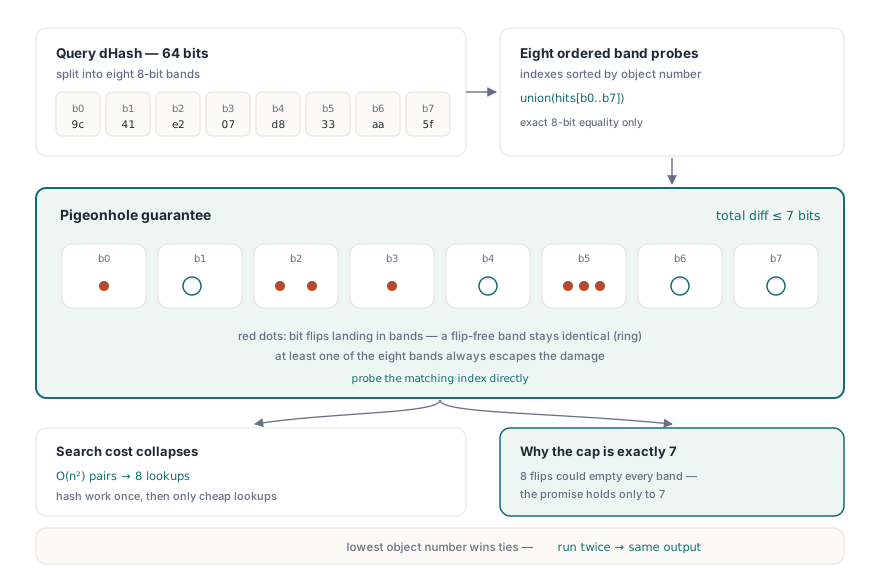
Kandidater och bandträffar ordnas deterministiskt efter objektnummer och generation, och det lägsta objektnumret blir kanoniskt. Det gör utdatan reproducerbar: att köra optimeraren två gånger på samma indata ger samma kanoniska val, vilket spelar roll när resultatet jämförs eller signeras
Testkörningar och ärlig rapportering
Eftersom detta är en förlustbehäftad optimering i den mening att de sammanslagna bilderna inte var identiska, är det förnuftiga arbetsflödet att titta innan du hoppar. Testkörningsalternativet rapporterar vad som skulle slås ihop och hur mycket nyttolast som skulle återvinnas utan att ändra objektgrafen, så ett batchjobb kan logga effekten och en människa kan godkänna trösklarna en gång snarare än per fil
Två ärlighetsanmärkningar i rapporteringen förtjänar att nämnas. Den återvinningsbara siffran uppskattar bara den kodade nyttolasten för duplicerade strömmar; den räknar inte in overhead för ordlistor, indirekta objekt och korsreferenser, så den faktiska filstorleksminskningen är något större än rapporterat snarare än mindre. Och rapporten exponerar det maximalt accepterade felet och jämförelsearbetsbelastningen, så du kan se hur nära sammanslagningarna kom dina trösklar
Det fasta 64 gånger 64-samplingsrutnätet är en avsiktlig approximation, och det har en konsekvens värd att ange rakt av: en skillnad mindre än en samplingscell kan förbli oupptäckt även vid en nolltröskel. Ett enda ändrat ord på en skannad sida kanske inte överlever den samplingen. När bevis på bytenivå krävs, använd istället den exakta avdubbleringsvägen — den slår bara ihop genuint identiska resurser och gör ingen visuell bedömning alls
Var det hör hemma i en storleksreduceringspipeline
Ordna passeringarna efter risk. Kör exakt resursavdublettering först, eftersom den är förlustfri och gratis. Sedan delmängdsbildning av typsnitt, vilket också är förlustfritt och vanligtvis den enskilt största vinsten på textintensiva dokument, som täcks i optimering av PDF-filstorlek och delmängdsbildning av typsnitt. Sedan bildomkomprimering eller nedsampling om målmediet tillåter det. Perceptuell avdublettering hör hemma efter dessa, eftersom det är det enda steget vars resultat beror på en bedömning
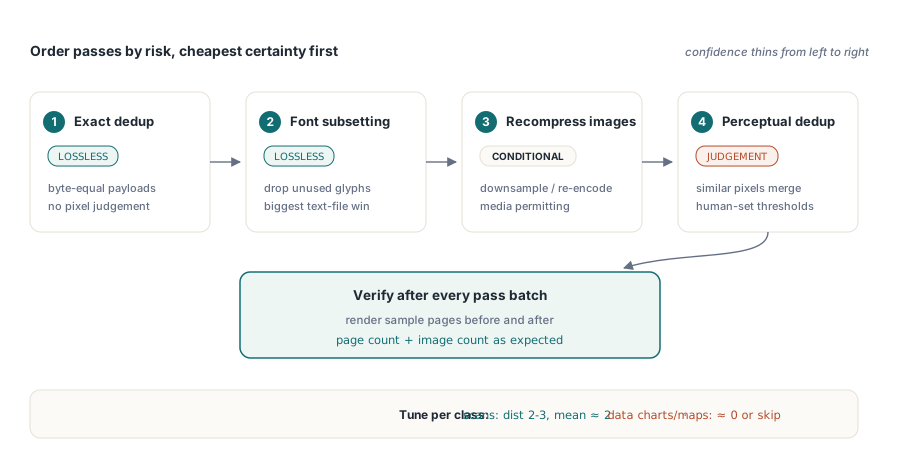
Välj trösklar efter dokumentklass snarare än globalt. För skannade batcher där varje sida bär samma brevhuvud slår ett hashavstånd på 2 till 3 med ett medelfel runt 2 ihop brevhuvudet tillförlitligt. För dokument där bilder bär data — diagram, kartor, medicinska bilder — använd noll eller nästan-noll-trösklar, eller hoppa över passeringen helt, eftersom två diagram som skiljer sig med en plottad punkt är två olika diagram oavsett hur lika de ser ut vid 64 gånger 64
Efter optimering, verifiera. Rendera ett urval av sidor före och efter och jämför dem, och kontrollera att sidantalet och bildantalet ändrades som du förväntade dig. Inspektionsvägen för vad ett dokument faktiskt innehåller beskrivs i granskning av PDF-filstorlek per kategori, vilket också är det snabbaste sättet att ta reda på om bilder är ditt problem över huvud taget
Perceptuell avdublettering, exakt resursavdublettering och storleksgranskningen körs på samma objektgraf för Delphi, C++Builder och Free Pascal; den fullständiga funktionslistan finns på sidan för PDF Library for Delphi