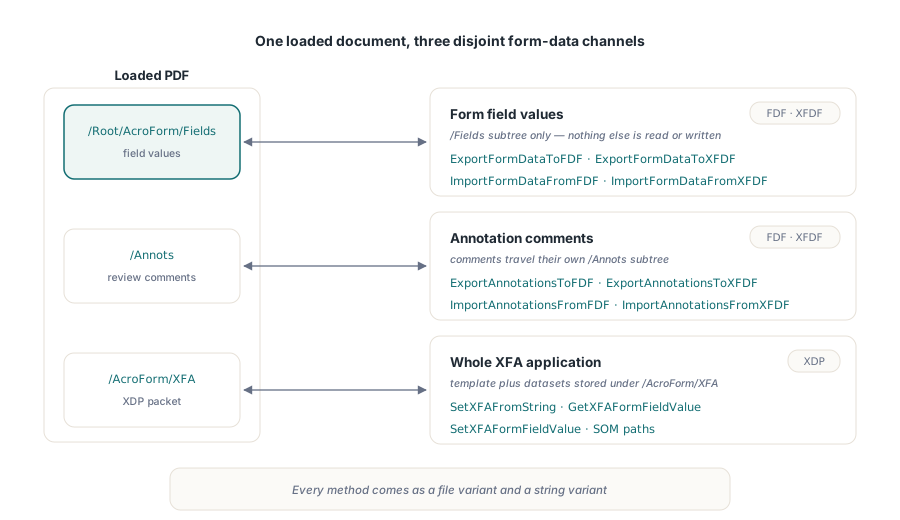
losLab PDF Library flyttar formulärdata in i och ut ur en PDF på tre olika sätt: FDF och XFDF för fältvärden i AcroForm, samma två format för granskningskommentarer, och ett helt XFA XDP-paket som skrivs rakt in i formuläret. ExportFormDataToXFDF, ImportFormDataFromXFDF, ImportAnnotationsFromFDF, ExportAnnotationsToXFDF och SetXFAFromString är ingångspunkterna, och var och en av dem har en filvariant och en strängvariant
Anledningen till att det finns så många metoder är att PDF-formulärdata inte är en enda sak. Ett ifyllt AcroForm har fältvärden, det kan dessutom bära granskningskommentarer, och ett äldre XFA-formulär bäddar in en hel XML-applikationsbeskrivning som inte har något med någotdera att göra. losLab PDF Library håller de tre angelägenheterna på separata API:er med flit, eftersom en sammanslagning skulle tvinga på minst två av dem fel datamodell. Att avgöra vilken familj du behöver är det första designvalet, och det avgörs oftast i samma stund som du vet vad det mottagande systemet på andra sidan faktiskt konsumerar
Vad är skillnaden mellan formulärdata i FDF, XFDF och XFA?
FDF och XFDF bär samma information i två olika syntaxer, och XFA är en värld för sig. FDF är ett miniatyrdokument i PDF-syntax (ISO 32000-2 §12.7.8): en /Fields-array av << /T (name) /V (value) >>-ordböcker, med strängar escapade precis som literala strängar escapas inuti en PDF. XFDF är XML-formen av samma data (ISO 19444), ett <fields>-träd som Acrobat och de flesta formulärbackender läser och skriver inbyggt. XFA är ingetdera: det är en XML Forms Architecture-mall plus dess data, lagrad som ett XML Data Package (XDP) som PDF:en refererar till från /AcroForm/XFA. Välj FDF eller XFDF när du utbyter fältvärden, och ta till XFA endast när du underhåller ett dokument som från början författats som ett XFA-formulär
Inom FDF och XFDF drar losLab PDF Library en andra gräns: fältvärden kontra granskningskommentarer. Formulärdatafamiljen (ExportFormDataToFDF, ImportFormDataFromFDF, ExportFormDataToXFDF, ImportFormDataFromXFDF) läser och skriver delträdet /Fields och rör inget annat. Annoteringsfamiljen (ExportAnnotationsToFDF, ImportAnnotationsFromFDF, ExportAnnotationsToXFDF, ImportAnnotationsFromXFDF) läser och skriver istället delträdet /Annots, vilket är vad Acrobat menar med Export Comments. De två överlappar aldrig, så en export av fältvärden sveper inte med sig lösa granskningsanteckningar, och en import av kommentarer stör inte de värden en användare redan skrivit in. Vad en widget gör när den klickas eller räknas om är åter en tredje sak, som täcks i följeslagstexten om interaktiva formuläråtgärder och JavaScript
Hur fyller du ett PDF-formulär från FDF eller XFDF i Delphi?
Läs in dokumentet, anropa en importmetod och spara. ImportFormDataFromXFDF och ImportFormDataFromFDF tolkar var för sig den inkommande formulärdatan, matchar varje post mot ett AcroForm-fält via dess fullständigt kvalificerade namn, sätter värdet och returnerar antalet fält som faktiskt uppdaterats. Båda metoderna uppdaterar bara fält som redan finns i mål-PDF:en; ingen av dem uppfinner ett fält för ett namn som formuläret inte definierar, vilket hindrar en förlupen eller fientlig datafil från att tyst svälla ditt formulär
var
  Lib: TPDFlib;
  FieldsSet: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('application-blank.pdf', '');
    // XFDF framställd av ett ärendehanteringssystem, redan UTF-8 på disk
    FieldsSet := Lib.ImportFormDataFromXFDF('applicant-1042.xfdf');
    if FieldsSet > 0 then
      Lib.SaveToFile('application-filled.pdf');
  finally
    Lib.Free;
  end;
end;
Två detaljer avgör om icke-trivial data överlever resan. Den första är escaping: FDF lagrar värden som literala PDF-strängar, så ett värde som innehåller en parentes, ett omvänt snedstreck eller en icke-skrivbar byte anländer inlindat i den oktala escaping som definieras i ISO 32000-2 §7.3.4.2, och losLab PDF Library inverterar den escapingen vid import så att parenteser och snedstreck kommer tillbaka som de literala tecken användaren skrev. Den andra är teckenkodning: de filbaserade metoderna skriver och läser XFDF och FDF som UTF-8, vilket är vad XFDF-deklarationen lovar och vad varje icke-ASCII-fältvärde (ett namn med accenter, en valutasymbol, en CJK-adress) behöver för att göra rundturen utan att korrumperas. Om du bygger XFDF:en själv, deklarera UTF-8 och skriv UTF-8, så kommer importen att hålla med dig
Hierarkiska fält, flervalslistor och rik text
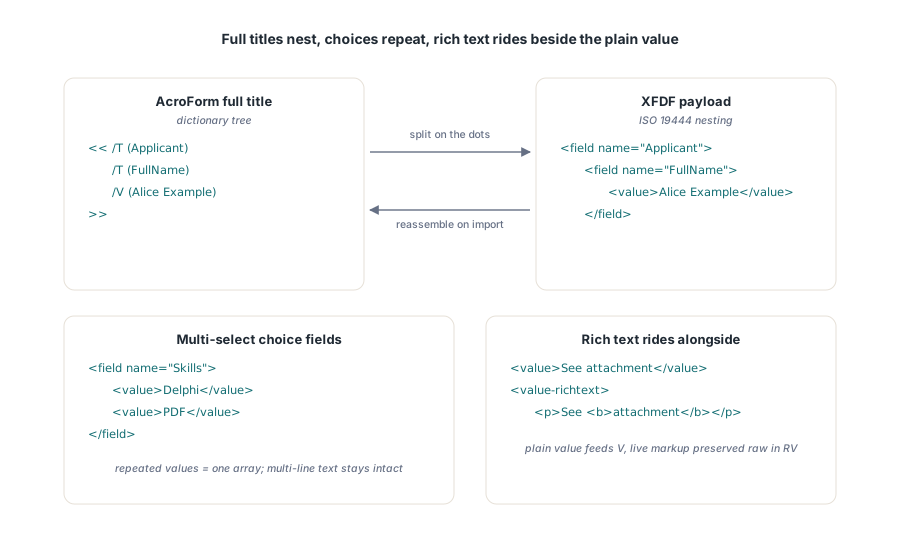
Hierarkiska fältnamn är det första stället där en naiv exportör går sönder. AcroForm adresserar ett nästlat fält med en punktad fullständig titel som Applicant.FullName, men XFDF lägger inte den punktade strängen i ett enda namnattribut; ISO 19444 nästlar den, som <field name="Applicant"><field name="FullName">. losLab PDF Library delar upp den punktade titeln i nästlade <field>-element vid export och sätter ihop de nästlade elementen till den fullständiga titeln igen vid import, så att de två riktningarna förblir symmetriska. Vid export hoppar den också över icke-terminala föräldrafält, eftersom en föräldranod i ett AcroForm bara bär namngivningsnivån och inte har något eget värde; att avge den skulle ge ett tomt <value></value> som inte motsvarar det riktiga formuläret. Flervalslistor är den andra fällan: ett valfält kan hålla flera valda värden samtidigt, vilket XFDF uttrycker som upprepade <value>-element och FDF uttrycker som en /V-array, och losLab PDF Library delar bara upp ett fält i flera värden när det verkligen är en flervalslista, så att ett vanligt flerradigt textfält behåller sina radbrytningar istället för att splittras i påhittade värden
Rik text är den tredje, och den som folk oftast får om bakfoten. Ett fält med formatering lagrar sin markup i posten RV som ett XHTML-delträd, och XFDF bär den i <value-richtext>. losLab PDF Library skriver det delträdet som ett levande XML-fragment istället för att escapa det, så att ett nedströmsverktyg läser riktig rik text istället för en sträng av synliga taggar; vid import bevarar den det råa RV-delträdet och tillämpar ändå den enkla <value> på V. Där ett fält erbjuder båda vinner det enkla värdet för V och den rika texten åker med bredvid i RV, vilket är den interoperabilitetsregel som hindrar en import av rik text från att tyst skriva om ett värde ett annat verktyg redan satt. När din rika text finns för att förmedla dokumentstruktur till hjälpmedelsteknik, behandla den på samma sätt som du skulle behandla läsordningen som diskuteras i texten om taggad PDF och tillgänglighetsstruktur
var
  Lib: TPDFlib;
const
  XFDF =
    '<?xml version="1.0" encoding="UTF-8"?>' +
    '<xfdf xmlns="http://ns.adobe.com/xfdf/" xml:space="preserve">' +
    '<fields>' +
    '  <field name="Applicant">' +
    '    <field name="FullName"><value>Alice Example</value></field>' +
    '  </field>' +
    '  <field name="Skills">' +
    '    <value>Delphi</value><value>PDF</value>' +
    '  </field>' +
    '  <field name="Notes">' +
    '    <value>See attachment</value>' +
    '    <value-richtext><body><p>See <b>attachment</b></p></body></value-richtext>' +
    '  </field>' +
    '</fields></xfdf>';
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('intake.pdf', '');
    // Applicant.FullName sätts ihop igen; Skills fyller arrayerna /V + /I;
    // Notes får V från <value> och RV från <value-richtext>
    Lib.ImportFormDataFromXFDFString(XFDF);
    Lib.SaveToFile('intake-filled.pdf');
  finally
    Lib.Free;
  end;
end;
Hur gör du en rundtur med granskningskommentarer som FDF eller XFDF?
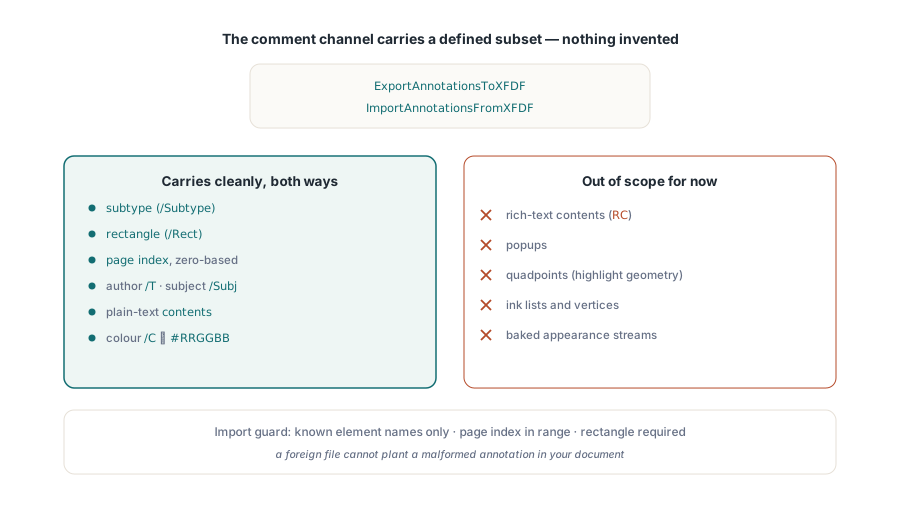
Kommentarer färdas på annoteringsfamiljen, och den delmängd som stöds är medvetet liten. ExportAnnotationsToXFDF och ImportAnnotationsFromXFDF, med sina FDF-motsvarigheter, bär textbaserad markup med de fält som faktiskt klarar rundturen rent: annoteringens subtyp, dess rektangel, dess 0-baserade sidindex, författaren i T, ämnet i Subj, den enkla Contents, och färgen, som mappar PDF:ens /C-DeviceRGB-trippel till och från ett XFDF-attribut på formen #RRGGBB. Importen accepterar endast kända elementnamn och hoppar över varje post vars sida ligger utanför intervallet eller vars rektangel saknas, så en handredigerad eller främmande XFDF kan inte släppa in en felformad annotering i dokumentet. Vad delmängden ännu inte bär är värt att säga rakt ut: innehåll i rik text (RC), popup-fönster, quadpoints, ritlistor, hörnpunkter och färdigbakade utseendeströmmar ligger utanför omfånget tills vidare, så överstrykningsgeometri och egna stämpelutseenden överlever inte den här vägen. För att bekräfta vad som faktiskt landat, gå igenom sidans annoteringar eller det bredare elementträdet som täcks i textsökning och uppräkning av sidelement
var
  Src, Dest: TPDFlib;
  Xfdf: WideString;
begin
  Src := TPDFlib.Create;
  Dest := TPDFlib.Create;
  try
    Src.LoadFromFile('reviewed.pdf', '');
    Xfdf := Src.ExportAnnotationsToXFDFString;   // endast delmängden <annots>

    Dest.LoadFromFile('clean-copy.pdf', '');     // sidorna måste stämma per index
    Dest.ImportAnnotationsFromXFDFString(Xfdf);
    Dest.SaveToFile('clean-copy-commented.pdf');
  finally
    Dest.Free;
    Src.Free;
  end;
end;
Att skriva ett fullständigt XFA XDP-paket med SetXFAFromString
XFA är avvikaren, och SetXFAFromString är hur du skriver hela saken på en gång. Metoden tar ett komplett XML Data Package, dokumentet <xdp:xdp> med sina template- och datasets-paket, och lagrar det som den ström som refereras från /AcroForm/XFA. losLab PDF Library skapar AcroForm-behållaren vid behov när dokumentet saknar en, så du behöver inte lägga till ett slit-och-släng-fält bara för att ge XFA:n någonstans att hänga, och den kastar bort eventuellt tolkat XFA-tillstånd den höll så att en senare läsning speglar paketet du just skrev istället för en inaktuell cache. Eftersom ett XFA-paket är XML och inte nödvändigtvis UTF-8 upptäcker biblioteket en UTF-16-byteordningsmarkör och avkodar paketet korrekt före tolkning, vilket spelar roll för paket framställda av verktyg som har UTF-16 som standard
När paketet väl är på plats adresserar GetXFAFormFieldValue och SetXFAFormFieldValue enskilda fält genom deras sökväg i Scripting Object Model. losLab PDF Library accepterar standardrötterna för SOM såväl som nakna relativa sökvägar, så form1.FullName, $data.form1.FullName och xfa.datasets.data.form1.FullName löses alla upp till samma datanod, och mallsidan accepterar $template och xfa.template på samma sätt. Den toleransen spelar roll när SOM-sökvägarna genereras av ett annat system som alltid avger den fullständigt kvalificerade formen
var
  Lib: TPDFlib;
const
  Xdp =
    '<?xml version="1.0" encoding="UTF-8"?>' +
    '<xdp:xdp xmlns:xdp="http://ns.adobe.com/xdp/">' +
    '  <template xmlns="http://www.xfa.org/schema/xfa-template/3.3/">' +
    '    <subform name="form1">' +
    '      <field name="FullName"><ui><textEdit/></ui></field>' +
    '    </subform>' +
    '  </template>' +
    '  <xfa:datasets xmlns:xfa="http://www.xfa.org/schema/xfa-data/1.0/">' +
    '    <xfa:data><form1><FullName>Alice Example</FullName></form1></xfa:data>' +
    '  </xfa:datasets>' +
    '</xdp:xdp>';
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetXFAFromString(Xdp, 0);      // skapar AcroForm-behållaren om ingen finns
    // läs tillbaka genom data-DOM:en med en SOM-sökväg
    if Lib.GetXFAFormFieldValue('form1.FullName') = 'Alice Example' then
      Lib.SetXFAFormFieldValue('form1.FullName', 'Bob Example');
    Lib.SaveToFile('xfa-packet.pdf');
  finally
    Lib.Free;
  end;
end;
Den ärliga sammanfattningen är att fältvärden klarar rundturen fullt ut genom FDF och XFDF, inklusive hierarki, flerval och rik text; granskningskommentarer klarar rundturen som en definierad delmängd av textmarkup med tydliga luckor; och XFA skrivs och läses som ett helt paket med SOM-åtkomst per fält ovanpå. Matcha formatet mot konsumenten, deklarera UTF-8 för allt du bygger för hand, och kom ihåg att importmetoderna aldrig rör annat än fält och annoteringar som redan passar dokumentet. Metoderna för formulärdata, annoteringar och XFA som beskrivs här är en del av losLab PDF Library för Delphi och C++Builder, vars referens bär den fullständiga parameterlistan för varje export- och importingång