Tabela sadrži kolonu sa imenima kupaca. Neka su na kineskom, neka na ćirilici, nekoliko nosi nemačke umlaute ili francuski akcenat. Izvezete je u CSV i otvorite rezultat, i svaki znak je netaknut. Izvezete istu radnu svesku u RTF za šablon za spajanje pošte (mail-merge), otvorite je u programu za obradu teksta, i imena van ASCII skupa su se srušila u redove punih znakova pitanja. Podaci se nikada nisu promenili. Ono što se promenilo je ugovor o kodiranju formata u koji ste zapisivali, a svaka izvozna putanja nosi drugačiji
Ovo je zamka koja uhvati biblioteku koja na površini izgleda potpuno svesna Unicode-a. Tekst ćelije se interno čuva kao WideString, tako da model nikada ne gubi znak. Gubitak se dešava na granici, u pisaču koji mora da serijalizuje taj tekst u format sa sopstvenim pravilima o tome koji bajtovi su legalni i kako se mora kodirati sve što je van legalnog opsega. Uradite jednog pisača ispravno i i dalje možete isporučiti drugog koji unakazi isti tekst. Popravka nije globalni prekidač. To je odvojena, ispravna odluka na svakoj putanji
RTF je po dizajnu bezbedan 7-bitni format
Rich Text Format prethodi Unicode-u i specifikovan je tako da preživi prenose koji propuštaju samo štampani ASCII. RTF dokument deklariše kodnu stranu u svom zaglavlju, a svaki znak koji pisac ne može da predstavi na toj kodnoj strani mora biti emitovan kao eskejp umesto sirovog bajta. Relevantni eskejp je \u, koji nosi potpisanu 16-bitnu kodnu jedinicu praćenu ASCII rezervnim znakom za čitače previše stare da bi uopšte razumeli eskejp
HotXLS zapisuje RTF na ovaj način. Zaglavlje dokumenta se otvara deklarisanjem kodne strane, u obliku \ansi\ansicpg1252\uc1, a pisac u jedinici lxRTF prolazi kroz svaki string emitujući svaki znak iznad običnog ASCII-ja kao eskejp \u, tako da tok bajtova ostaje 7-bitno čist bez obzira na to šta deklarisana kodna strana može da sadrži. Kodna tačka poput U+4E2D postaje doslovna sekvenca \u20013?, a ne sirovi bajt koji bi pregledač zatim pokušao da protumači kroz bilo koju kodnu stranu za koju je pretpostavio da se koristi. Bez te discipline, sve van deklarisane kodne strane nema legalnu bajtovsku reprezentaciju, a pisac koji emituje sirovu vrednost proizvodi znakove pitanja kojima je ovaj članak počeo
Detalj koji treba imati na umu je da deklarisana kodna strana i eskejpovi predstavljaju dve polovine jednog ugovora. Samo deklarisanje kodne strane ne pomaže tekstu koji leži van nje. Emitovanje eskejpova bez deklarisane kodne strane ostavlja rezervne znakove nejasnim. Oboje mora biti ispravno istovremeno, zbog čega pisac koji rukuje samo jednim od njih i dalje otkazuje na prvoj višejezičnoj radnoj svesci
HTML eskejpovanje je više od uglastih zagrada
HTML izvoz proizvodi dokument sa više listova čiji navigacioni okviri nose imena listova kao vidljiv tekst. Ta imena su stringovi koje kontroliše autor i koji mogu sadržati bilo koji znak, uključujući one značajne za markup. List doslovno nazvan Q1 & Q2 <draft> mora do stranice stići kao eskejpovani entiteti, inače će uglaste zagrade otvoriti fantomsku oznaku, a ampersand će početi referencu entiteta koja nikada nije bila nameravana. Ovo je obično HTML eskejpovanje, i preskakanje na oznaci okvira je vrsta propusta koja prolazi svaki test izgrađen od imena listova samo sa ASCII znakovima
Pitanje kodiranja se nalazi jedan sloj ispod toga. Kada znakovi van ASCII-ja upadnu u kontekst koji nije garantovano poslužen kao UTF-8, bezbedna reprezentacija je numerička referenca znaka, pa se U+00E9 piše kao é umesto kao sirovi bajt čije značenje zavisi od charseta odgovora. Ogledalski obrnuto ovo pravilo važi na ulazu. Radna sveska pročitana iz XLSX-a nosi deljene stringove u kojima znak može već biti sačuvan kao numerički XML entitet, a taj entitet mora biti dekodiran u jedan ceo znak pre nego što uđe u model ćelije. Dekodujte ga nepažljivo, razbijajući kodnu tačku na odvojene bajtove, i jedan znak se ponovo pojavi kao dva komada nerazumljivog teksta koje kasniji izvoz ne može da popravi
XLSX kontejner je ZIP, a ZIP ima sopstveno kodiranje imena
XLSX fajl je ZIP arhiva, a arhiva čuva ime za svakog člana koga sadrži. ZIP je dovoljno star da njegova originalna specifikacija nije rekla ništa o kodiranju tih imena, pa čitač koji ne pronađe signal pretpostavlja lokalnu kodnu stranu arhive. Ta pretpostavka je pogrešna u trenutku kada ime člana sadrži znak van ASCII-ja, što se dešava sa lokalizovanim imenima delova radnog lista i sa ugrađenim medijima čija imena fajlova nose akcente ili nelatinično pismo
Popravka je jedan jedini bit. Bit opšte namene 11 u svakom lokalnom zaglavlju fajla deklariše da je ime člana kodirano kao UTF-8. HotXLS proverava tačno taj bit kada čita arhivu, testirajući zastavice opšte namene naspram maske $0800, a čitač ili pisac koji ga ignoriše pogrešno će pročitati ime koje je ispravna implementacija sačuvala kao UTF-8. Bit je jeftin za postavljanje i jeftin za poštovanje, i predstavlja celu razliku između imena člana koje preživi put tamo i nazad i onog koje stigne oštećeno pre nego što je sadržaj radne sveske uopšte analiziran
Pretvaranje veličine slova i skeniranje brojeva kriju istu opasnost
Izračunavanje formula je mesto gde Unicode bezbednost prestaje da bude o serijalizaciji i postaje o poređenju. Funkcija SEARCH ne razlikuje velika i mala slova, što znači da mora da pretvori veličinu slova pre nego što potraži podniz. Pogrešan način pretvaranja je kroz ANSI kodnu stranu, jer pretvaranje teksta van ASCII-ja u velika slova na taj način usmerava znakove kroz usku kodnu stranu i kvari sve van nje. Ispravan način je pretvaranje širokih stringova, koje čuva ceo UTF-16 opseg. HotXLS pretvara pomoću WideUpperCase upravo iz tog razloga, tako da pretraga akcentovanog ili nelatiničnog teksta pronalazi iste znakove koji su joj dati, a ne aproksimaciju oštećenu kodnom stranom
Tokenizator formula nosi srodnu obavezu koja nema nikakve veze sa slovima, a svu vezu sa tim gde se token završava. Naučna notacija poput 1E3 ili 2.5E-3 je jedan numerički literal, a skener mora da prepozna E, opcioni znak, i cifre koje slede kao deo broja, umesto da razbije unos na ime praćeno odvojenim brojem. Skener koji ovo loše obrađuje pretvara potpuno validnu konstantu u grešku parsiranja ili, gore, u tiho pogrešan izraz. Ovo spada u istu raspravu jer se oba slučaja tiču čitača koji donosi ispravnu odluku na nivou znaka: jedna o tome kako pretvoriti znak radi poređenja, druga o tome da li znak nastavlja tekući token
Izgradnja i izvoz višejezične radne sveske
Javni API ne traži od vas da razmišljate ni o čemu od ovoga. Izgradite radnu svesku od vrednosti ćelija tipa WideString i pozovete ulaznu tačku izvoza koju želite. Odluke o kodiranju se dešavaju unutar svakog pisca. Primer ispod puni list tekstom na nekoliko pisama, a zatim iz iste radne sveske zapisuje i RTF fajl i HTML fajl, tako da obe putanje rade nad identičnim ulazom
uses
  lxHandle;

procedure ExportMultilingualWorkbook;
var
  Book: IXLSWorkbook;
  Sheet: IXLSWorksheet;
begin
  Book := TXLSWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Customers');

    Sheet.Cells[1, 1].Value := 'Name';
    Sheet.Cells[1, 2].Value := 'City';

    // Tekst ćelije se čuva kao WideString, tako da svako pismo preživi model.
    Sheet.Cells[2, 1].Value := '王伟';          // kineski
    Sheet.Cells[2, 2].Value := '北京';
    Sheet.Cells[3, 1].Value := 'Müller';        // nemački umlaut
    Sheet.Cells[3, 2].Value := 'Köln';
    Sheet.Cells[4, 1].Value := 'Иванов';        // ćirilica
    Sheet.Cells[4, 2].Value := 'Москва';
    Sheet.Cells[5, 1].Value := 'Désirée';       // francuski akcenti
    Sheet.Cells[5, 2].Value := 'Montréal';

    // RTF: pisac lxRTF deklariše kodnu stranu i emituje svaki
    // znak van ASCII-ja kao eskejp \u, čime fajl ostaje 7-bitno čist.
    Book.SaveAsRTF('Customers.rtf');

    // HTML: imena listova su HTML-eskejpovana, a tekst van ASCII-ja se zapisuje
    // tako da ne zavisi od pretpostavljenog charseta odgovora.
    Book.SaveAsHTML('Customers.html');
  finally
    Book := nil;
  end;
end;
Oba poziva vraćaju status tipa Integer, i oba obrađuju isti tekst u memoriji. Ništa u kodu koji poziva ne deklariše kodnu stranu niti eskejpuje znak, jer odgovornost leži na piscu koji poznaje sopstveni format. SaveAsCSV na nivou radne sveske prati isti oblik ako vam treba razgraničeni izvoz iz istog izvora
// Ista radna sveska, treća izvozna putanja sa sopstvenim pravilima kodiranja.
Book.SaveAsCSV('Customers.csv');
Unicode bezbednost je po putanji, ne po biblioteci
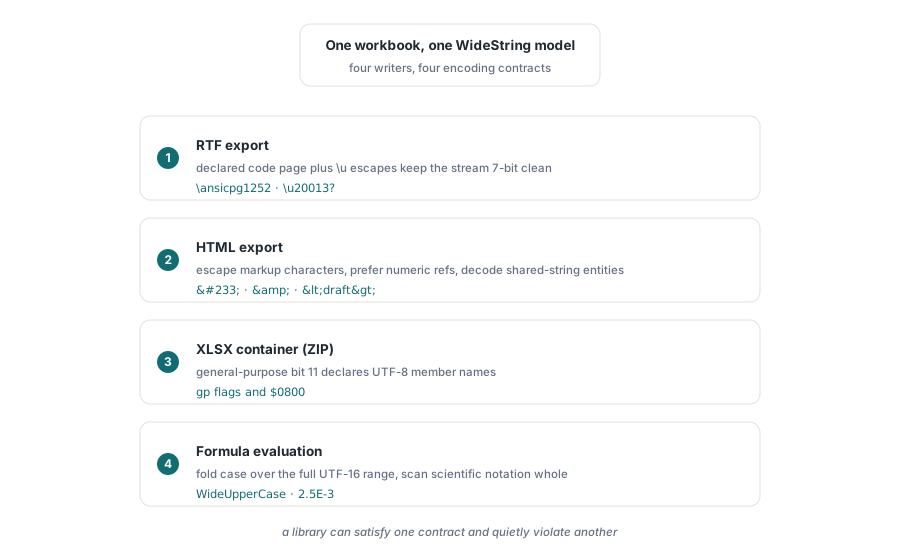
Pouka koju vredi poneti je da ne postoji jedno jedino mesto na kome treba biti bezbedan za Unicode. RTF-u treba deklarisana kodna strana plus eskejpovi \u. HTML-u treba eskejpovanje entiteta za znakove značajne za markup i numeričke reference tamo gde charset nije garantovan, plus ispravno dekodiranje entiteta koji stižu u deljenim stringovima. ZIP kontejneru treba postavljen bit opšte namene 11 kako bi se ime člana u UTF-8 čitalo kao UTF-8. Izračunavanju formula treba pretvaranje veličine slova širokih stringova i tokenizator koji drži naučnu notaciju u jednom komadu. Svako od ovoga je drugačiji ugovor, a biblioteka može zadovoljiti jedan dok tiho krši drugi. To je razlog zbog kog alat koji ispravno uradi CSV vam ipak može uručiti RTF pun znakova pitanja
Ako se vaši izvozi oslanjaju na razgraničene formate, kompromisi među njima su pokriveni u našem vodiču kroz izvoz CSV, TSV i HTML, a kada je izvor skup rezultata umesto ručno građenog lista, obrasci u izvozu baze podataka za Delphi izveštaje prirodno se uklapaju sa pravilima kodiranja opisanim ovde. Sve ovo je deo HotXLS Delphi Component-a za Delphi i C++Builder, uz API-je za čitanje, formule, i formatiranje pokrivene na drugim mestima na ovom blogu