HotXLS, izvorna Excel biblioteka za Delphi i C++Builder, analizira XLSX radne listove na više niti kroz trofazno učitavanje: XML radnog lista dekomprimuje se serijski, analizira paralelno, a mali delovi se nakon toga čitaju serijski. Prvo izdanje te funkcije donelo je ubrzanje od samo 12–25%, jer je zadano zaključavanje upravitelja memorije u Delphiju serijalizovalo radne niti. Smanjenjem alokacija na hrpi sa približno 20 na 9.1 po ćeliji podiglo je paralelno ubrzanje na ×1.90 na osam niti. Ovaj članak prolazi kroz merenja, pogrešne smerove i dva ispravka koja su stvarno uspela
Kako HotXLS paralelno analizira XLSX radne listove?
HotXLS deli poziv Open na tri faze, a samo se srednja izvršava na radnim nitima (worker threads). Razlog je ZIP kontejner: ZIP arhiva je jedan zajednički ulazni tok sa jednim inflate mašinom stanja, a ta mašina stanja ne mogu da čitaju dve niti istovremeno. Zamotavanje u blokadu (lock) bilo bi besmisleno, jer je inflate po svojoj prirodi serijski po stavci, pa bi blokada samo reprodukovala serijsko izvršavanje uz dodatne troškove. Faza A stoga dekomprimuje XML svakog lista u sopstveni TMemoryStream dok je još uvek jednonitna; u našoj testnoj datoteci to je trajalo oko 4 ms za osam delova lista, pa to uopšte nije usko grlo. Faza B pokreće ParseWorksheetXml za svaki list na skupu radnih niti (worker pool), gde se nalazi gotovo svo vreme učitavanja. Faza C se serijski vraća na ZIP radi manjih delova: komentara, crteža, grafikona i tabela
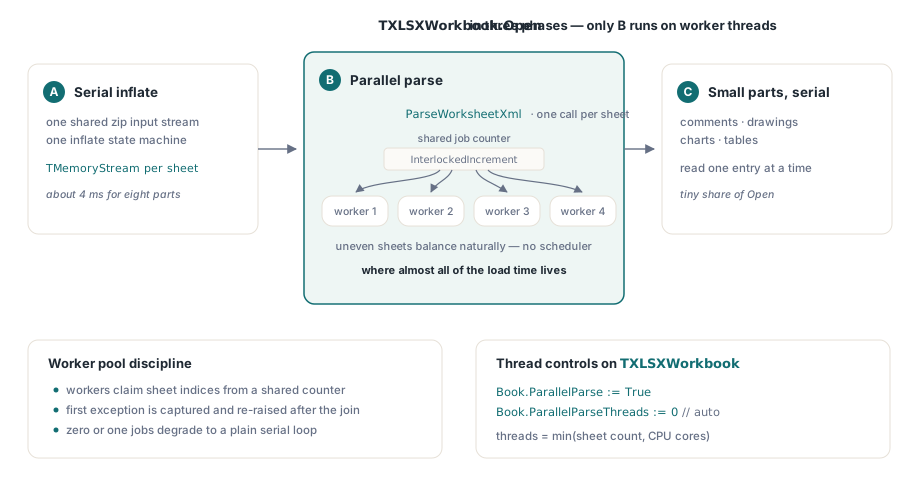
Sam skup radnih niti namerno je jednostavan. Radnici povlače indekse poslova iz zajedničkog brojača pomoću InterlockedIncrement, tako da se listovi nejednake veličine prirodno uravnotežuju bez ikakvog raspoređivača. Broj niti je min(broj listova, procesorske jezgre), prva iznimka radne niti hvata se sa AcquireExceptionObject i ponovo pokreće na glavnoj niti nakon spajanja (join), a dispečer se degradira na običnu serijsku petlju kada ima nula ili jedan posao. Dva svojstva klase TXLSXWorkbook upravljaju ovom funkcijom: ParallelParse otvara skup niti, a ParallelParseThreads ograničava broj niti, pri čemu 0 označava automatski odabir. Radne sveske sa više listova su oblik koji ima najviše koristi, uključujući i one koje proizvedete dupliranjem šablona lista desetinama puta
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // uključi paralelni worker pool
    Book.ParallelParseThreads := 0;  // 0 = auto: min(sheets, CPU cores)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... čitaj ćelije kao obično; radna sveska je u potpunosti materijalizovana ...
  finally
    Book.Free;
  end;
end;
Zašto dodavanje niti usporava XLSX analiziranje u Delphiju?
Zato što zadani upravitelj memorije u Delphiju štiti svoju hrpu (heap) globalnom blokadom, a analiziranje listova je gusto ispunjeno alokacijama: ćelije, varijante i široki nizovi znakova (WideStrings) broje se u milionima. Svaka radna nit koja dodirne hrpu čeka u redu za tu blokadu, pa se niti koje u izvornom kodu izgledaju nezavisno u praksi izvršavaju gotovo jedna po jedna. Naš prvi test učinio je to bolno konkretnim. Na radnoj svesci sa 8 listova i 5000 redova puta 4 kolone po listu, izmereno na procesoru i5-11600K (6 jezgri, 12 niti) pod Win64, paralelni Open poboljšao se za samo 12–25% u poređenju sa planiranom procenom od najmanje 40%. Ispitivanje broja niti kroz 2, 3, 4, 6 i 8 niti proizvelo je ravnu krivulju, a u kasnijim merenjima konfiguracija sa 2 niti bila je zapravo 26% sporija od serijske, što je klasični potpis dveju niti koje se naizmenično bore za blokadu
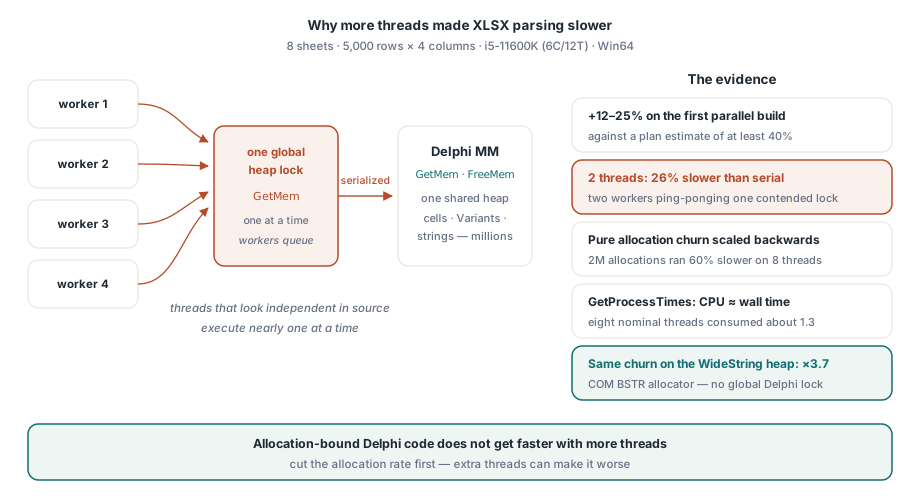
Tri merenja potvrdila su dijagnozu, a svako od njih preokrenulo je prethodnu intuiciju. Prvo, sićušna datoteka (8 listova od po 1 reda) otvorila se za 1.2 ms, dokazujući da analiziranje čini praktički 100% vremena Open i da nema skrivenih fiksnih troškova. Drugo, mikrotest čistog kruženja alokacija pokazao je da upravitelj memorije Delphija skalira unazad: isti ukupni volumen od 2 miliona alokacija objekata i AnsiStringova radio je 60% sporije na 8 niti nego na jednoj, dok je isto kruženje na WideString hrpi, koja koristi COM BSTR alokator umesto Delphi MM-a, skaliralo na ×3.7. To što HotXLS posvuda koristi WideString pokazalo se kao istorijska slučajnost koja radi u našu korist. Treće, GetProcessTimes pokazao je da je tokom paralelnog poziva Open procesorsko vreme bilo približno oznaci stvarnog vremena: osam nominalnih niti trošilo je oko 1.3 procesorske niti. Radne niti nisu se vrtele u prazno; spavale su u stazi sukoba upravitelja memorije, blokirane umesto zaposlene
Praktična pouka se generalizuje i van proračunskih tabela. Ako radno opterećenje Delphija intenzivno alocira memoriju, povećanje broja niti ne pomaže sve dok se stopa alokacija ne smanji, a lako može pogoršati stvari. Pre ovog ispravka, korisnicima koji su podešavali ParallelParseThreads govorili smo poštenu istinu: na datotekama sa gustim alokacijama, više niti nije donosilo gotovo ništa
Odakle dolazi 20 alokacija na hrpi po ćeliji?
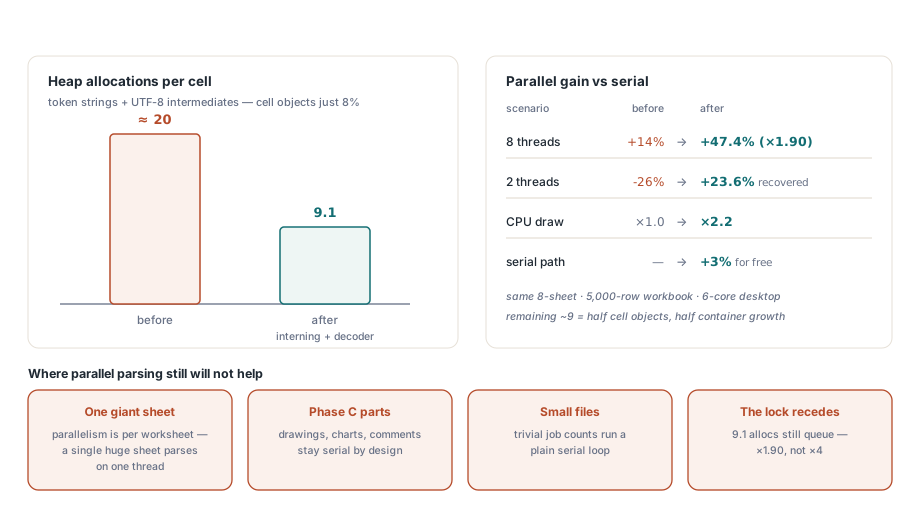
Brojački omotač (counting wrapper) instalisan pomoću SetMemoryManager precizno je odgovorio na to pitanje: oko 20 alokacija Delphi MM-a po ćeliji, od kojih je 2.87 miliona bilo od 32 bajta ili manje. Krivac uopšte nisu bili objekti ćelija. TXMLScaner.GetTokenValue stvarao je novi AnsiString pri svakom pozivu, a poziva se otprilike 15–20 puta po ćeliji: po jednom za nazive elemenata, nazive atributa, vrednosti atributa i tekstualni sadržaj. Povrh toga, RTL-ova funkcija UTF8ToWideString proizvodila je privremeni UnicodeString kao međuproizvod za svaku pretvorbu. Objekti ćelija činili su samo 160 hiljada alokacija, oko 8% ukupnog broja, što je odmah uništilo naš prvobitni plan: nameravali smo da izgradimo skup objekata ćelija (pool), a brojevi su rekli da se to nikada ne bi isplatilo
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // promet malih objekata koji nas zanima
  Result := OldMM.GetMem(Size);
end;

// instaliraj pre Open, obnovi posle
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Tu desetominutnu dijagnostiku vredi ukrasti za bilo koje ispitivanje performansi u Delphiju. Brojanje alokacija po veličinskim razredima gotovo ništa ne košta da se napravi, a pokazuje odakle pritisak na menadžer memorije zaista potiče, što su u našem slučaju bile dve navike na nivou RTL-a unutar XML skenera, a ne bilo šta u modelu objekata. Profajleri su neprestano pokazivali na parser u celini; omotač je pokazao na dve konkretne linije
Ispravak: interniranje tokena i UTF-8 dekoder bez međukoraka
Dvije ciljane promene u XML čitaču uklonile su više od polovine alokacija po ćeliji bez menjanja strukture parsera. Prva je interniranje naziva elemenata. XML radnog lista beskonačno ponavlja mali skup reči: row, c, v, r, t, s i nekoliko naziva atributa. InternTokenName održava predmemoriju od 64 mesta za prethodno viđene nazive i upoređuje međuspremnik skenera sa predmemoriranim unosom pomoću TokenEqualsAnsi, što je direktna usporedba bajtova koja ne alocira ništa. U slučaju podudaranja, vraća predmemorirani AnsiString, i ovdete tipa važan: AnsiString koristi brojanje referenci (reference counted), pa vraćanje predmemorirane instance košta jedno povećanje broja referenci i nula prometa na hrpi. WideString nema brojanje referenci i svako dodeljivanje prolazi kroz SysAllocString, pa interniranje WideStringova ne bi uštedelo ništa. Interniranje se isplati raditi samo na tipu niza koji koristi brojanje referenci
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // refcount++ only, no allocation
  else
  begin
    Result := GetTokenValue;        // materialize once, then cache
    FInternNames[Slot] := Result;
  end;
end;
Druga promena odnosi se na tekst ćelija. Stara staza gradila je AnsiString token, predavala ga funkciji UTF8ToWideString koja je gradila privremeni UnicodeString, koji se konačno pretvarao u WideString koji ćelija sprema: dvije alokacije Delphi MM-a po tekstualnom tokenu pre one prave. Zamena, XmlUtf8ToWide(TokenPtr, TokenLen), je UTF-8 dekoder napisan u čistom Pascalu koji radi u dva prolaza i čita direktno iz skenerovog međuspremnika: prvi prolaz meri dužinu UTF-16, a drugi dekodira u WideString alociran samo jednom. Neto trošak po tekstualnom tokenu: jedna COM alokacija, nula alokacija Delphi MM-a. Jedna semantička napomena za oprezne: na neispravnim UTF-8 sekvencama novi dekoder propušta bajtove umesto zamene znakovima zamene kao što to radi RTL, što utiče samo na degradaciju oštećenih datoteka; na ispravnom unosu izlaz je identičan u bajt. XML entiteti znakova nikada ne dolaze do dekodera jer ih je skener već razrešio u UTF-8 u međuspremniku tokena
Šta smo time dobili, i gde paralelno analiziranje i dalje neće pomoći
Dva ispravka smanjila su alokacije po ćeliji sa oko 20 na 9.1, a paralelni brojevi pomaknuli su se onako kako je teorija predviđala. Na istom testu sa 8 listova i 5000 redova te na istom 6C12T stroju, poboljšanje sa 8 niti skočilo je sa 14% na 47.4%, što je ×1.90 ubrzanje u odnosu na serijsko. Slučaj sa 2 niti prešao je sa 26% sporijeg na 23.6% brži, a izmereno iskorišćenje procesora poraslo je sa ×1.0 na ×2.2. Serijska staza postala je oko 3% brža kao bonus, budući da manje alokacija pomaže i jednoj niti. Preostalih ~9 alokacija po ćeliji otprilike su pola objekti ćelija, a pola amortizovani rast spremnika; izmerili smo ih, procenili da su povrati sve manji i zaustavili se, pri čemu je MM omotač spreman za ponovno uzorkovanje prema mjestu poziva ako buduće opterećenje opravda još jednu rundu
Granice vredi navesti jednako jasno kao i pobede. HotXLS se paralelizuje na nivou radnog lista, tako da se radna sveska koja je jedan golemi list analizira na jednoj niti bez obzira na to šta kaže ParallelParseThreads; za taj oblik, strujni direktni čitač je bolji alat, jer uopšte izbegava materijalizaciju radne sveske. Datoteke čije vreme odlazi na delove Faze C — crteže, grafikone i komentare — vide manje koristi jer ta faza po dizajnu ostaje serijska. Male datoteke uopšte ne vredi paralelizovati, zbog čega dispečer tiho pokreće serijski rad za zanemarljiv broj poslova. Gornja granica upravitelja memorije nije nestala, samo se povukla: pri 9.1 alokacija po ćeliji, globalna blokada i dalje opterećuje radne niti, zbog čega osam niti daje ×1.90 umesto ×4. Za širi skup alata za smanjenje vremena učitavanja i spremanja, uključujući stilove, poolove i skupne povratne pozive redova, pogledajte naš vodič za performanse velikih radnih sveski u Delphiju
Paralelno analiziranje XLSX-a, svojstva ParallelParse i ParallelParseThreads te XML čitač sa niskim brojem alokacija opisan ovde dolaze kao standardni delovi komponente HotXLS Delphi Excel Component, koja izvorno čita i piše XLS, XLSX i ODS iz Delphija i C++Builder bez ikakve automatizacije Excela