V celico natipkajte =NORM.DIST(115,100,15,TRUE) in Excel brez ceremonije vrne 0,8413447. Klic je videti kot iskanje po tabeli. Ni. Za tem enim številom stoji kumulativna normalna porazdelitev, integral brez zaključene oblike, za funkcijama CHISQ.INV.RT in BETA.DIST pa posebne funkcije, ki jih mora skrbna knjižnica ovrednotiti, ne pa na roko približati. Komponenta za preglednice, ki trdi, da je združljiva z Excelom, mora te vrednosti reproducirati do zadnje števke, ki jo Excel prikaže, kar pomeni reproducirati numerične metode in ne le imena funkcij
HotXLS izvaja več kot petdeset teh statističnih funkcij, delo, zaradi katerega so pravilne, pa je iz vrstice s formulo skoraj povsem nevidno. To je sprehod skozi to, kako jih pogon računa: skupno jedro posebnih funkcij, odločitve o vejah, ki ohranjajo aritmetiko stabilno, in en hrošč pri inverzni normalni porazdelitvi, ki se je dolgo skrival v repu, ker se običajni primer pokvarjene vrstice nikoli ni dotaknil
En klic v delovnem listu, petdeset porazdelitev za njim
Funkcije pokrivajo družine, po katerih poseže statistični delovni zvezek. Tu je normalna družina, NORM.DIST in NORM.S.DIST s svojimi inverzi; družina game in hi-kvadrata, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; družina bete, BETA.DIST in BETA.INV; vzorčne porazdelitve T.DIST, T.DIST.2T, F.DIST in F.INV; diskretni par BINOM.DIST in POISSON.DIST; ter pomočniki za sklepanje, kot sta CONFIDENCE.T in CONFIDENCE.NORM. S klicateljevega sedeža je vsaka od njih ena sama formula. Vhode nastavite v celicah, delovni zvezek prosite za ovrednotenje in preberete rezultat
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // opazovanje
  sh.Range['A2', 'A2'].Value := 100;   // povprečje
  sh.Range['A3', 'A3'].Value := 15;    // standardni odklon

  // Razčlenjevalnik formul XLS uporablja ';' kot ločilo argumentov.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Metoda Calculate na delovnem zvezku priložnostno formulo prevede in ovrednoti proti živemu listu ter vrne Variant. Ena podrobnost ljudi spotakne že prvič: razčlenjevalnik formul za metodo Calculate jemlje podpičje kot ločilo argumentov, zato se piše =SUM(A1;B1) in ne =SUM(A1,B1). Shranjene formule celic ohranijo vejico po Excelovem standardu. Isti ocenjevalnik razpošlje vsako spodnjo statistično funkcijo, zato ko ena od teh deluje v metodi Calculate, ostale sledijo po isti poti
Dve funkciji, na katerih je zgrajeno vse drugo
Večina kumulativnih porazdelitev v tej množici se ne izračuna s seštevanjem ali integriranjem lastnih definicij. Izračunajo se iz dveh posebnih funkcij: regularizirane spodnje nepopolne game, pisane P(a, x), in regularizirane nepopolne bete, pisane Ix(a, b). Znotraj sta to pomočnika, na katera se opirajo razpošiljevalniki, veriga pa je kratka. Kumulativna funkcija hi-kvadrata je kumulativna funkcija game z obliko df/2 in merilom 2. Kumulativna funkcija game je neposredno P(a, x). Kumulativne funkcije t, F in binomske porazdelitve so vse vrednosti regularizirane nepopolne bete pri pravih argumentih. Poissonova kumulativna funkcija je zgornja nepopolna gama Q. Dobro izvedite funkciji game in bete in ducat porazdelitev njuno natančnost podeduje zastonj
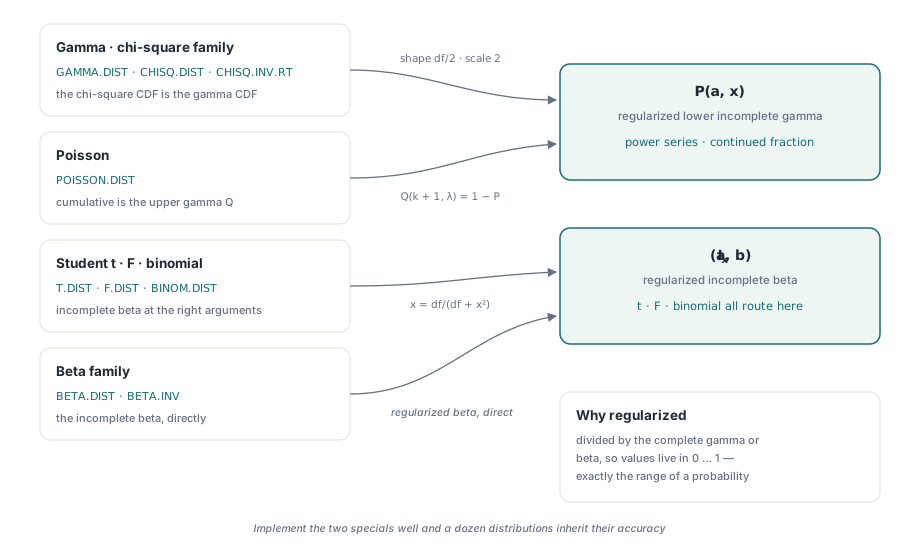
Beseda »regularizirana« je bistvo vsega. Surova nepopolna gama raste kot fakulteta, surovi integral bete pa lahko podleti ali prekorači obseg krepko preden to stori odgovor. Regularizirani obliki sta deljeni s popolno gamo ali beto, zato živita v celoti na intervalu od nič do ena, kar je natanko obseg, ki ga zaseda verjetnost. Prav ta normalizacija omogoča, da isti postopek streže hi-kvadratu z dvema prostostnima stopnjama in tistemu z dvesto, ne da bi vmesni členi ušli z roba dvojne natančnosti. Pojasnjuje tudi, zakaj kumulativne funkcije ne izračunate s seštevanjem dolgega repa členov gostote: vsak člen nosi svojo zaokrožitveno napako, napake se med potekom vrste kopičijo, regularizirana posebna funkcija pa se vsoti povsem izogne, saj namesto tega ovrednoti hitro konvergentno vrsto ali verižni ulomek
Vrsta pod diagonalo, verižni ulomek nad njo
Postopek za nepopolno gamo se odloči enkrat, preden karkoli izračuna: x primerja z a + 1. Ta meja ni poljubna. Potenčna vrsta za P(a, x) konvergira hitro, kadar je x majhen glede na a, in počasi, sčasoma neuporabno, kadar je x velik. Verižni ulomek ima nasprotno naravo. Zato pogon uporabi potenčno vrsto za x pod a + 1 in Lentzov verižni ulomek za x pri a + 1 ali nad njim, pri čemer se od vsake veje zahteva le delo, v katerem je dobra
Verižni ulomek potrebuje eno varovalo. Lentzova metoda deluje tako, da nosi tekoči števec in imenovalec ter imenovalec na vsakem koraku obrne, in če se katerikoli približa nič, obračanje eksplodira. Popravek je drobcen prag: kadar koli vmesni člen po velikosti pade pod približno 1e-30, se pripne na 1e-30, kar rekurenco ohrani končno, ne da bi zmotilo konvergirano vrednost. Isto pripenjanje se iz istega razloga pojavi v verižnem ulomku nepopolne bete. Gre za majhno konstanto, ki opravlja nosilno delo, torej za razliko med stabilnim ovrednotenjem in deljenjem z nečim, kar je od nič nerazločljivo
Zgornji rep, Q(a, x), je preprosto 1 minus P(a, x), in tako se izračuna kumulativna veja Poissonove porazdelitve: verjetnost največ k dogodkov s povprečjem λ je Q(k + 1, λ). Usmeritev tega skozi zgornjo nepopolno gamo namesto seštevanja k + 1 Poissonovih členov je znova odločitev, da se ovrednoti en konvergenten izraz namesto kopičenja mnogih majhnih
Diskretne mase brez prekoračitve pri fakultetah
Diskretne porazdelitve prinašajo drugačno nevarnost. Binomska verjetnostna masa vključuje binomski koeficient, koeficient za dvainpetdeset nad šestindvajset pa je ogromno celo število. Če ga oblikujete neposredno, števec prekorači obseg dvojne natančnosti še pred deljenjem, ki bi ga vrnilo v razumno verjetnost. Pogon ga nikoli ne oblikuje. Fakultete izračuna v logaritemskem prostoru prek funkcije log-gama, logaritme sešteva in odšteva, vmes vloži logaritma verjetnosti uspeha in neuspeha ter eksponira en sam krat čisto na koncu
// Binomska verjetnostna masa, v celoti ovrednotena v logaritemskem prostoru.
// LnGammaF(n+1) je ln(n!); tri log-fakultete tvorijo ln(C(n,k)),
// celoten eksponent pa je zgrajen pred enim samim klicem Exp.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
Sama funkcija log-gama je Lanczosov približek, natančen po celotni pozitivni osi in poceni za izračun. Ker je vsaka velika količina do končnega klica Exp zadržana kot svoj logaritem, je največje število, ki ga postopek sploh kdaj uresniči, verjetnost sama, ta pa je največ ena. Poissonova masna funkcija sledi istemu receptu, pri čemer en sam člen log-game nadomesti fakulteto v imenovalcu. Zaključene oblike so posebej obravnavane na robovih, kjer je p natanko nič ali ena, tako da koda nikoli ne pokliče Ln(0). HotXLS vrne 0,2460938 za BINOM.DIST(5,10,0.5,FALSE) in 0,6766764 za kumulativno POISSON.DIST(2,2,TRUE), kar se ujema z Excelom skozi vse števke, ki jih ta izpiše
Inverzi z oklepanjem krivulje naprej
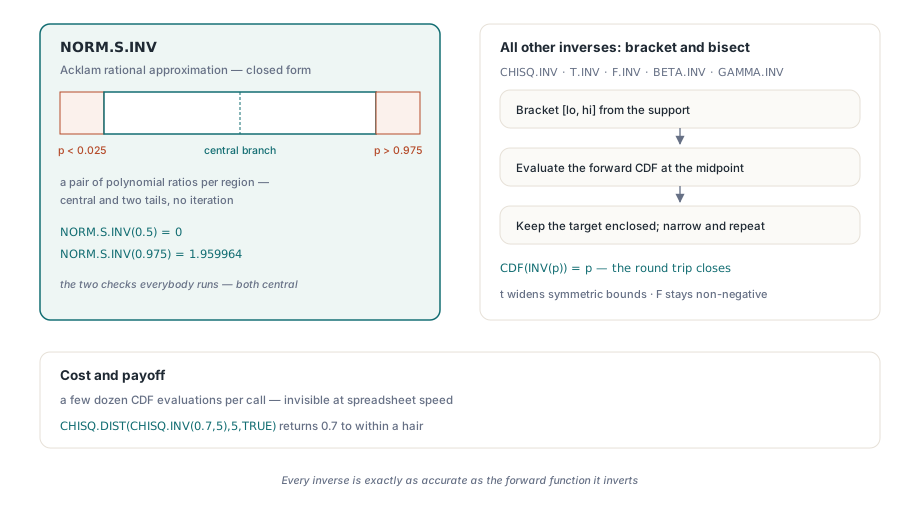
Inverzna porazdelitvena funkcija sprašuje nasprotno: dana je verjetnost, poišči vrednost, katere kumulativna funkcija ji je enaka. Le en inverz v tej množici ima hitro neposredno formulo. NORM.S.INV, inverz standardne normalne porazdelitve, uporablja Acklamov racionalni približek, par polinomskih razmerij, natančnih približno do natančnosti dvojne števke po celotnem obsegu, razdeljenih na osrednje območje in dva repa. Gre za ovrednotenje v zaključeni obliki brez ponavljanja
Drugi inverzi take formule nimajo, zato jih pogon obrne numerično. Odgovor oklepa s spodnjo in zgornjo mejo, izbrano iz nosilca porazdelitve, nato pa razpolavlja: ovrednoti kumulativno funkcijo naprej na sredini, premakne tisto mejo, ki ciljno verjetnost ohrani zaprto, in ponavlja, dokler interval ni ozek. Pri inverzih game in hi-kvadrata se oklepaj začne pri nič in radodarni zgornji oceni, zgrajeni iz oblike in merila, pri čemer se zgornja meja podvoji, če verjetnost še ni zaprta. Inverz t oklepa simetrični meji, ki se širita navzven; inverz F razpolavlja na nenegativnem intervalu. Cena je nekaj deset ovrednotenj kumulativne funkcije na klic, kar je pri hitrosti preglednice nevidno, korist pa je, da je vsak inverz natanko tako natančen kot funkcija naprej, ki jo obrne. Zato izlet tja in nazaj, kot je CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE), vrne 0,7 na las natančno
Desetiški logaritem, ki se je skrival v repu
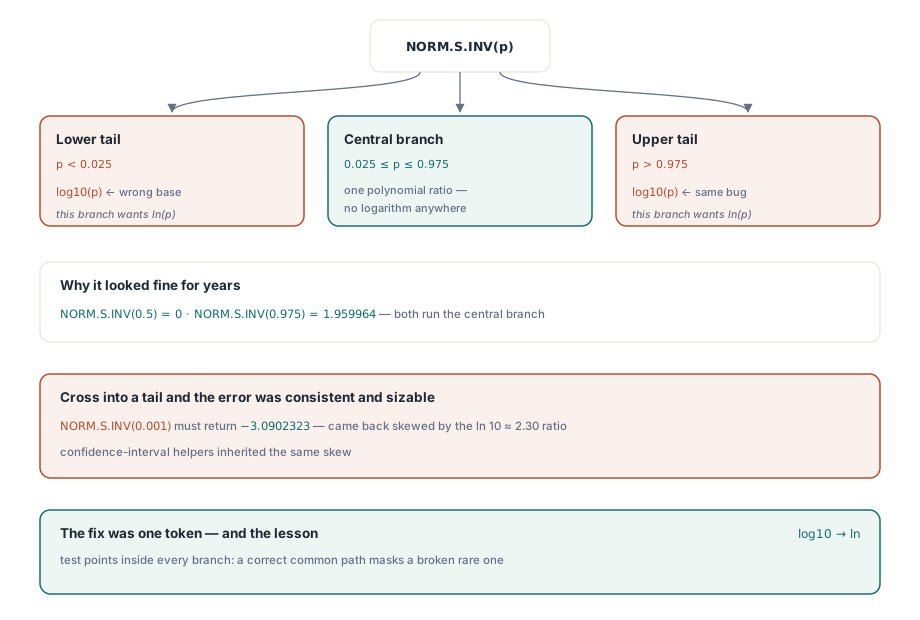
Tu je hrošč, ki ga je vredno povedati, ker je tiste vrste, ki preživi dolgo. Acklamov postopek za inverzno normalno porazdelitev ima tri veje. Široka osrednja veja, ki se uporabi vselej, ko verjetnost leži med približno 0,025 in 0,975, vhod požene skozi polinomsko razmerje, v katerem ni nikjer nobenega logaritma. Vsaka od repnih vej, za zelo majhne ali zelo velike verjetnosti, pa najprej vzame logaritem vhoda, ker se rep obnaša kot koren iz minus naravnega logaritma p
Zgodnja različica repne veje je vzela desetiški logaritem tam, kamor je sodil naravni. Razlikujeta se za konstanten faktor približno 2,30, zato so bili rezultati v repu napačni za dosleden, občuten razmik. In vendar je bila funkcija videti dobro pri vsakem površnem preverjanju, ker površna preverjanja živijo v sredini. NORM.S.INV(0.5) je nič, NORM.S.INV(0.975) je učbeniških 1,959964, oba pa tečeta skozi osrednji polinom, ki logaritma sploh nikoli ne pokliče. Napaka se je pokazala šele, ko je verjetnost prestopila v rep, denimo NORM.S.INV(0.001), ki mora vrniti -3,0902323, vrnil pa se je zamaknjen za razmerje med naravnim in desetiškim logaritmom. Vsaka funkcija, ki je v svojem repu odvisna od inverzne normalne porazdelitve, vključno s pomočniki za intervale zaupanja, je podedovala isti zamik. Nauk je vsakdanji in drag: funkcija z vejno strukturo potrebuje testne točke znotraj vsake veje, ker bo pravilna pogosta pot brez pomisleka zakrila pokvarjeno redko. Popravek je bila sprememba enega samega simbola iz desetiškega v naravni logaritem, vrednosti v repu pa so se prilepile Excelovim
Predznak x odloči, kateri rep dobi porazdelitev t
Kumulativna funkcija Studentovega t nosi tankočutnost, ki jo je zlahka obrniti narobe. Njena vrednost izhaja iz regularizirane nepopolne bete, ovrednotene pri df / (df + x²), vendar je ta vrednost bete verjetnost v repu onkraj velikosti x, ne pa kumulativna verjetnost do x. Simetrična oblika porazdelitve t pomeni, da je pretvorba odvisna od tega, na kateri strani ničle leži x
// Kumulativna funkcija Studentovega t. ib je regularizirana nepopolna beta pri df/(df+x*x),
// ki meri simetrični rep. Kumulativna vrednost je odvisna od
// predznaka x; vrnitev nepretvorjenega ib da napačen rep.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // nad povprečjem: ena minus polovica repa
else if x < 0 then
  result := 0.5 * ib            // pod povprečjem: polovica repa
else
  result := 0.5;                // natanko na povprečju
Za x nad ničlo je kumulativna verjetnost ena minus polovica simetričnega repa; za x pod ničlo je polovica tega repa; pri ničli je natanko ena polovica. Vrnite vrednost bete neposredno in poročate o napačni strani porazdelitve, zgrešeni za celotno telo krivulje pri vsakem neničelnem x. Različici z desnim repom in z dvema repoma gradita na isti veji, zaradi česar se T.DIST.2T(1,1) vrne kot 0,5 in T.DIST(1,1,TRUE) kot 0,75, inverz T.INV pa razpolavlja proti tej popravljeni kumulativni funkciji, tako da se krog sklene
Nič od tega ni vidno iz celice, in to je tudi namen. Napišete formulo in preberete število, ki se ujema z Excelom. Če pogon razširjate z lastno logiko, je mehanika registriranja funkcije opisana v našem sprehodu skozi pogon formul in prilagojene funkcije, način, kako formule sežejo čez liste in poimenovana območja, pa v članku o definiranih imenih in formulah med listi. Vse to je vključeno v komponenti HotXLS Delphi spreadsheet component za Delphi in C++Builder, skupaj z vmesniki za branje, pisanje, grafikone in oblikovanje, ki jih pokrivamo drugod na tem blogu