PDFium Component kontroluje ekvivalenciu metadát PDF/A Info na XMP cez TPdf.InspectPdfAMetadata a opravuje ju cez TPdf.NormalizePdfAMetadata. ISO 19005-1 (v znení opravy Cor.1) vyžaduje, aby každý z ôsmich mapovaných Info záznamov, od Title po ModDate, niesol tú istú hodnotu ako jeho XMP vlastnosť, nie len aby existoval; kontrola číta správny RDF tvar, páruje namespace podľa URI a porovnáva dátumy ako okamihy
Bug report, ktorý túto konverzáciu obyčajne otvára, pôsobí neškodne. Document management systém pečiatkuje nové /ModDate do Info slovníka pri každej inkrementálnej uložke, XMP packet necháva pokoji a o pol roka audit archívu označí tisíce súborov ako nekonformné. Obe dátumy tam sú. Len prestali sedieť pri prvej úprave a presence kontrola si to nikdy nevšimla. Rovnako zlyhajú úpravy Title cez API iba-Info a reťazec Author ako Finance; Controlling, ktorý nejaký nástroj rozdelil na dve položky dc:creator
Prečo PDF/A odmieta metadáta, ktoré existujú na oboch miestach?
PDF/A ich odmieta, pretože ISO 19005-1 §6.7.3 je pravidlo o hodnote, nie o prítomnosti: Tabuľka 1 mapuje ôsem Info kľúčov na XMP vlastnosti a hneď ako Info kľúč existuje, mapovaná XMP vlastnosť musí držať ekvivalentnú hodnotu. Bajtovo-úrovňový skener popísaný v PDF/A preflight validácii s PDFium Component len potvrdí, že xmp:CreateDate a xmp:ModifyDate existujú (pvaiMissingXmpDates). Od v3.72.0 navyše TPdf.ValidatePdfA púšťa úplné porovnanie hodnôt a pridáva pvaiInfoXmpValueMismatch do sady issue, keď XMP packet existuje, ale nesúhlasí s Info (packet, ktorý sa nedá sparsovať, počíta ako nesúhlasiaci). Chýbajúci packet zostáva hlásený ako pvaiMissingXmpMetadata, takže tie dva issue nikdy nepočítajú dvakrát ten istý defekt
Aký RDF tvar potrebuje každá mapovaná XMP vlastnosť?
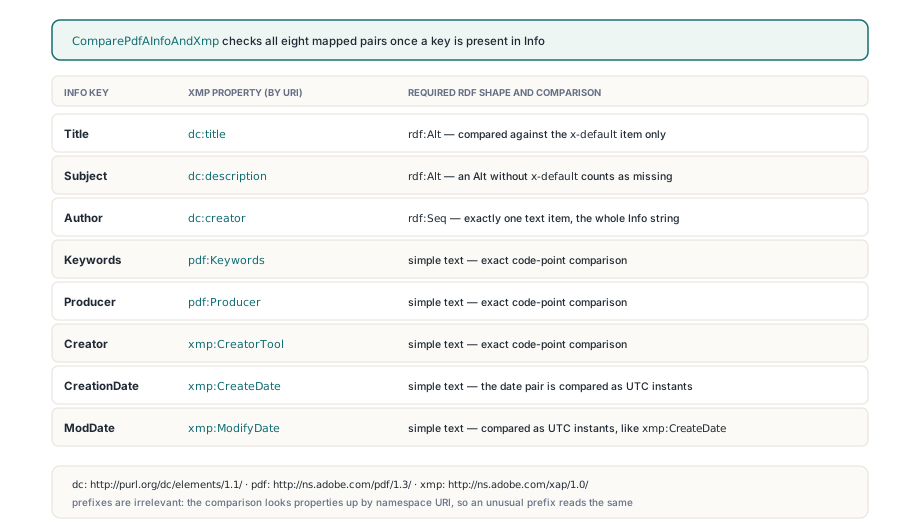
Každé z ôsmich mapovaní má pevný XMP typ a správna hodnota v nesprávnom kontajneri stále zlyhá. ComparePdfAInfoAndXmp v FPdfPdfa.pas vyhľadáva vlastnosti podľa namespace URI, takže packet, ktorý viaže http://purl.org/dc/elements/1.1/ na nezvyčajný prefix, číta sa presne tak ako jeden používajúci dc. Vyžadované tvary sú:
- Title →
dc:titlea Subject →dc:description: jazyková alternativardf:Alt, porovnávaná výhradne proti svojej položkex-default(language tag sa páruje case-insensitive); Alt bezx-defaultpočíta ako chýbajúci - Author →
dc:creator:rdf:Seqs presne jednou textovou položkou držiacou celý Info reťazec, takže zoznam autorov oddelený bodkočiarkami zostáva jediným záznamom - Keywords →
pdf:Keywordsa Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/): jednoduché textové vlastnosti - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/): jednoduché textové vlastnosti
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Textové hodnoty sa porovnávajú ako presné postupnosti Unicode code pointov, bez trimovania, foldovania veľkosti písmen či normalizácie. Medzera na konci, alebo predkomponované é na jednej strane a dekomponované e plus kombinujúci akcent na druhej, je reálny mismatch. Strana Info vždy pochádza z vlastného dekódovania textu PDFDocEncoding a UTF-16 v PDFium cez FPDF_GetMetaText, čo bráni knižnici reimplementovať dekódovanie reťazcov a pokaziť to jemne; strana XMP je len taká čistá, ako bajty, ktoré ju vytvorili, a preto tu záleží aj na codepage pascoch, ktoré korumpujú XMP metadáta pod Free Pascalom
Kedy sú PDF dátum a XMP dátum rovnaké?
PDF dátum a XMP dátum sú rovnaké, keď popisujú ten istý okamih na sekundu presne, s tou istou znalosťou časového pásma na oboch stranách. Oba parsery akceptujú legálne zníženú presnosť, takže D:2026 aj 2026 znamenajú 1. január 2026, 00:00:00. Keď obe hodnoty nesú pásmo, konvertujú sa na UTC pred porovnaním: D:20260827093659+08'00' sa rovná 2026-08-27T01:36:59Z. Keď ani jedna pásmo nesie, porovnávajú sa lokálne komponenty tak, ako sú napísané. Keď len jedna strana má pásmo, výsledkom je pamsValueMismatch, pretože vymyslieť offset by bolo hádanie. Nenulová zlomková sekunda ako .250 v XMP tiež vnúti mismatch, keďže PDF dátum ju nedokáže vyjadriť a potiché zaokrúhľenie by schovalo reálny nesúhlas; .000 sa akceptuje. Neparsovateľné hodnoty sa hlásia oddelene ako pamsInvalidInfoDate alebo pamsInvalidXmpDate
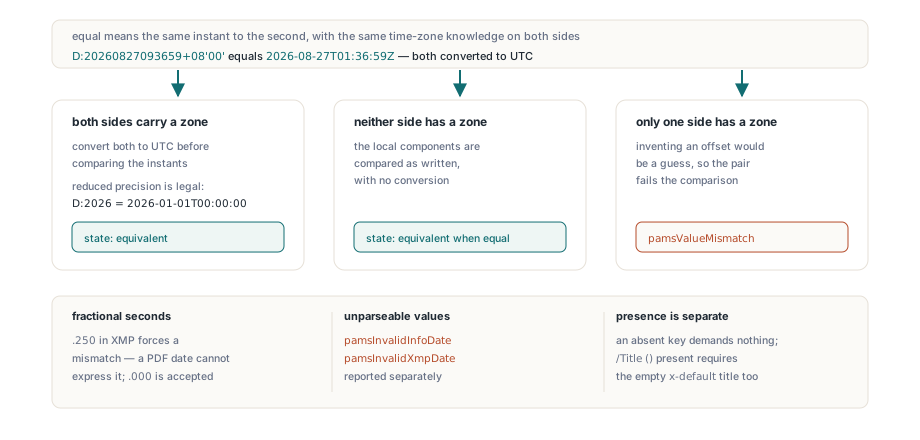
Prítomnosť má vlastné pravidlo. TPdfAMetadataValues.Present je sada plnená prechádzaním slovníka /Info aktívneho traileru a drží „kľúč chýba“ odlišne od „kľúč existuje s prázdnym reťazcom“. Chýbajúci kľúč dáva pamsNotRequired a nič nepožaduje po XMP; /Title () existuje, takže XMP packet musí niesť aj prázdny titulok x-default
Ako prezriete Info a XMP metadáta pred uložením?
TPdf.InspectPdfAMetadata vracia TPdfAMetadataReport s jednou TPdfAMetadataComparison na pole, každá drží Info hodnotu, XMP hodnotu a TPdfAMetadataState, takže zlyhanie sa dá vysvetliť bez reverzného inžinierstva jediného validačného flagu. MismatchFields zhrnie zlyhávajúcu sadu, HasXmpPacket povedia, či sa packet našiel, a XmpParseError vozí hlásenie parsera, keď packet existuje, ale nedá sa čítať
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
Čo mení NormalizePdfAMetadata a čo odmieta?
TPdf.NormalizePdfAMetadata berie Info slovník ako zdroj pravdy a prepisuje len XMP vlastnosti, ktorých pole pristalo v MismatchFields; všetko ostatné v packete prežije. Title a Subject sa zapisujú do položky x-default, kým ostatné jazykové alternatívy zostávajú nedotknuté, Author sa stane jedno-položkovým rdf:Seq, neznáme namespace a nesúvisiace vlastnosti sa zachovajú a XMP vlastnosti pre chýbajúce Info kľúče sa nechajú pokoji. Dátum Info s pásmom sa zapisuje ako kanonický UTC XMP dátum s príponou Z; ten bez pásma si drží lokálne komponenty. File overload ukladá cez dočasný súbor a atomickú náhradu a samotná XMP aktualizácia sa pripája ako inkrementálna aktualizácia
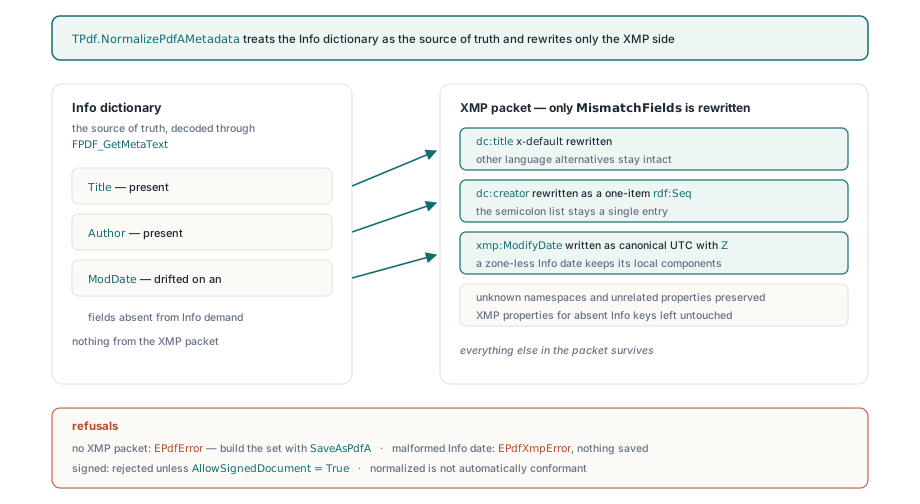
Odmietnutia sú zámerné. Bez XMP packetu metóda vyhodí EPdfError, pretože stavba kompletnej PDF/A identifikácie a sady metadát je práca SaveAsPdfA, pokrytej v vytváraní PDF/A archivačných súborov s PDFium Component. Zdeformovaný Info dátum vyhodí EPdfXmpError namiesto zápisu vierohodne vyzerajúcej zlej hodnoty a nič sa neuloží. Podpísané dokumenty sa odmietajú, pokiaľ volajúci nepošle AllowSignedDocument = True. Ekvivalencia je jedna z pravidiel ISO 19005-1 tiež, takže normalizovaný súbor nie je automaticky konformný
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // už konzistentné, nechajte súbor pokoji
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // zdeformovaný Info dátum alebo nečitateľný packet
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
Pustenie porovnania na vlastnom XMP packete
ComparePdfAInfoAndXmp a SynchronizePdfAInfoToXmp sú holé funkcie v FPdfPdfa, ktoré pracujú na TPdfXmpPacket bez načítaného dokumentu, čo sedí unit testom a pipeline skladajúcim XMP zo šablóny. Jedna pasca je Present: record inicializovaný s Default(TPdfAMetadataValues) má prázdnu sadu, každé pole potom hlási pamsNotRequired a porovnanie prejde prázdne, nech ste vyplnili akékoľvek hodnoty
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present rozhoduje, ktoré polia sú povinné; samotné hodnoty sa ignorujú
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate je teraz 2026-08-27T01:36:59Z, dc:creator jedno-položkový rdf:Seq
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Ak váš pipeline archivuje dokumenty, ktoré iné systémy neustále upravujú, spárujte nočný prechod InspectPdfAMetadata s NormalizePdfAMetadata pre súbory, ktoré odchýlia, a nechajte ValidatePdfA ako bránu skôr, než čokoľvek odíde do dlhodobého úložiska. Typovaný report, opravná cesta a zvyšok PDF/A náradia vozí PDFium Component for Delphi and C++Builder