PDFium Component vo verzii 3.117.0 prepojí tabuľku, ktorá sa láme cez hranicu stránky, keď buď oba fragmenty siahajú na okraje stránky, alebo pod prvým fragmentom a nad druhým nie je žiadny telový text, pričom running headers a footers sa ignorujú. ExtractDocumentTables aplikuje tento content-aware test ako alternatívu k staršiemu testu okrajov stránky, odmietne fragment na ďalšej strane, ktorého prvý riadok je jediná bunka cez celú šírku, a jeden riadok, ktorý pretečie na nasledujúcu stránku, si ponechá ako súčasť jeho continuation reťaze
Článok o detekcii a extrakcii tabuliek predstavil continuation ako štyri prísne brány a „siahá na okraj stránky“ bral ako jednu z nich. Ten opis bol presný pre vydanie, ktoré pokrýval, a zároveň bol nesprávny pre väčšinu tabuliek, ktoré ľudia komponentu naozaj podsúvajú. Tento článok je oprava: ktoré dokumenty margin test nezvládne, čo ho nahradilo a dva okrajové prípady, ktoré oprava priniesla so sebou
Prečo margin test zlyháva na Word exportoch?
Test okrajov stránky zlyháva preto, že textový procesor prestane rozkladať riadky na spodnom okraji, nie na okraji papiera. S defaultným ContinuationMargin 36 bodov pôvodné pravidlo vyžadovalo, aby spodný okraj skoršieho fragmentu ležal do 36 bodov od spodku stránky a horný okraj neskoršieho fragmentu do 36 bodov od vrchu stránky. Dokument exportovaný z Wordu s jeho defaultnými jednopalcovými okrajmi umiestni posledný riadok aspoň 72 bodov nad spodok stránky, ďalej, ak je prítomná päta, takže tá podmienka nikdy neplatila. Každá dlhá tabuľka v takom dokumente sa vrátila ako samostatné fragmenty s ContinuationGroup na nule a volajúci bol späť pri ručnom zliepaní. Test stále dáva zmysel pre to, na čo bol navrhnutý: reporty generované layout engineami, ktoré vyplnia stránku po pevný content box a ďalšiu stránku začnú na vrchu. Nie je to zlé pravidlo, je to neúplné pravidlo, a preto ho verzia 3.117.0 ponechala a pridala druhú cestu namiesto toho, aby ho nahradila
Čo namiesto toho kontroluje content-aware test?
Content-aware test kontroluje, či priestor medzi oboma fragmentmi zaberá niečo iné než tabuľka, pričom používa word boxy jednotlivých stránok a nie geometriu stránky. Kým ExtractDocumentTables prechádza dokument, zaznamenáva pre každú stránku najnižší spodný okraj slova, ktorého vrch leží nad pätovou zónou, a najvyšší horný okraj slova, ktorého spodok leží pod hlavičkovou zónou. Obe zóny sú hlboké ContinuationMargin bodov, takže tá istá voľba teraz slúži dvojako: ako vôľa k okraju stránky aj ako výška running header a footer zón. Dvojica fragmentov prejde, keď spodný okraj skoršieho leží na alebo pod najnižším telovým textom svojej stránky a horný okraj neskoršieho leží na alebo nad najvyšším telovým textom nasledujúcej stránky, každý v rámci AlignmentTolerance. Ľudsky povedané: tabuľka bola posledná vec na strane N a prvá vec na strane N+1, a číslo stránky alebo názov dokumentu v okrajovej zóne sa nepočíta. To vylúčenie nie je svojvoľné. ISO 32000-1 §14.8.2.2 klasifikuje running headers a footers ako pagination artefakty, teda obsah, ktorý existuje kvôli zlomu stránky a nie napriek nemu, a tá istá myšlienka, ktorá nechá tagovaný reader preskočiť ich, dovoľuje tabuľke pokračovať cez ne. Článok o marked content pokrýva, ako tagované súbory tie artefakty deklarujú explicitne; tu sa klasifikácia odvodzuje z pozície, pretože väčšina exportovaných tabuliek nenesie žiadne tagy
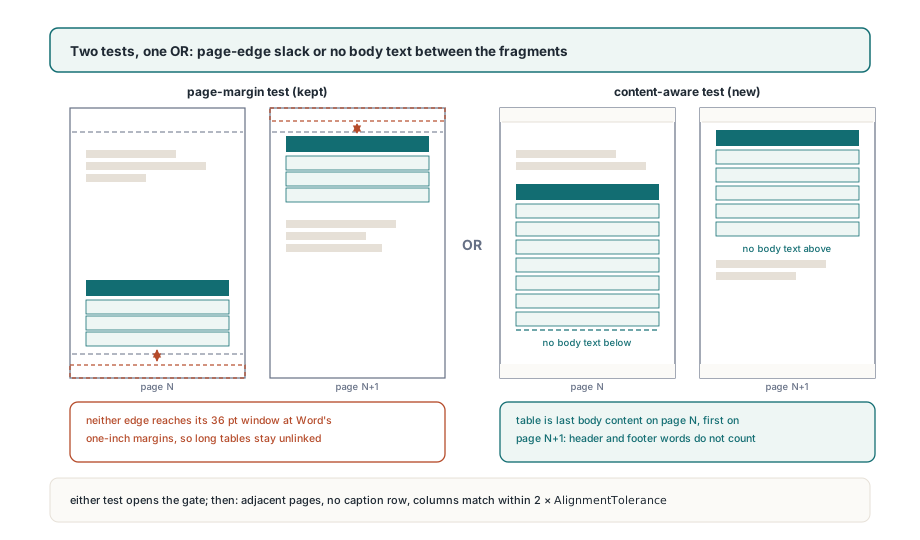
Oba testy sa kombinujú cez OR. Report z layout enginea, ktorého tabuľky siahajú na okraj papiera, prejde prvým; Word export, ktorého tabuľky sa zastavia na okraji, prejde druhým; dokument, ktorý spĺňa oboje, prejde dvakrát. Až keď jeden z nich uspeje, bežia ostatné brány, a to v pevnom poradí: čísla stránok musia byť susedné, neskorší fragment nesmie začínať riadkom popisku a hranice stĺpcov sa musia zhodovať v rámci dvojnásobku AlignmentTolerance, čo je pri defaultoch 6 bodov. Enumerácia je TPdfTableContinuation s hodnotami ptcNone, ptcStart, ptcMiddle a ptcEnd. Fragment, ktorý bol označený ako ptcEnd a potom sa prepojí na ďalšiu stránku, sa povýši na ptcMiddle, takže trojstranová tabuľka sa číta ako start, middle, end v poradí stránok. Čísla skupín začínajú na 1 a 0 znamená neprepojené, a ToJson emituje tie isté informácie ako členy continuation a continuationGroup, čo je forma, ktorú uprednostnite, ak zliepanie robí downstream služba
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // default; uvedené pre názornosť
    Options.ContinuationMargin := 54;        // dvojriadková päta, hlboká ~50 pt

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Ako riadok popisku zabráni zliatiu dvoch tabuliek?
Fragment na ďalšej strane, ktorého prvý riadok je jedna bunka cez všetky stĺpce, sa berie ako nová tabuľka, nikdy ako zvyšok predchádzajúcej. Toto pravidlo existuje preto, že content-aware test sám o sebe prepája až príliš ochotne. Prípad, ktorý to odhalil, bol formulár v štýle výpisu: tabuľka skončí blízko spodku strany 1, druhá tabuľka s rovnakými šírkami stĺpcov začína blízko vrchu strany 2, medzi nimi sedí len päta a stĺpce sedia do bodky. Pod margin testom sa tieto dve nikdy nestretli, pretože ani jedna nesiahala na okraj; pod content testom sa prepojili okamžite a formulár so sekciami sa stal jednou nesúvislou mriežkou. Čo ich oddeľuje, je vidieť v štruktúre buniek. Druhá tabuľka začína sekciovým popiskom ako „RECIPIENT INFORMATION“ rozloženým ako jedna zlúčená bunka cez celú šírku, a skutočný continuation to nikdy nerobí, pretože popisok patrí tabuľke, ktorá sa už začala na predchádzajúcej strane. TableStartsWithCaptionRow kóduje presne toto: fragment má aspoň dva stĺpce a obsahuje bunku s RowIndex = 0, ColumnIndex = 0 a ColumnSpan = ColumnCount. Kontrola beží len na neskoršom fragmente, takže tabuľka, ktorej vlastný riadok popisku sedí na jej prvej strane, je nedotknutá; popisok je na strane N a prezerá sa len fragment zo strany N+1
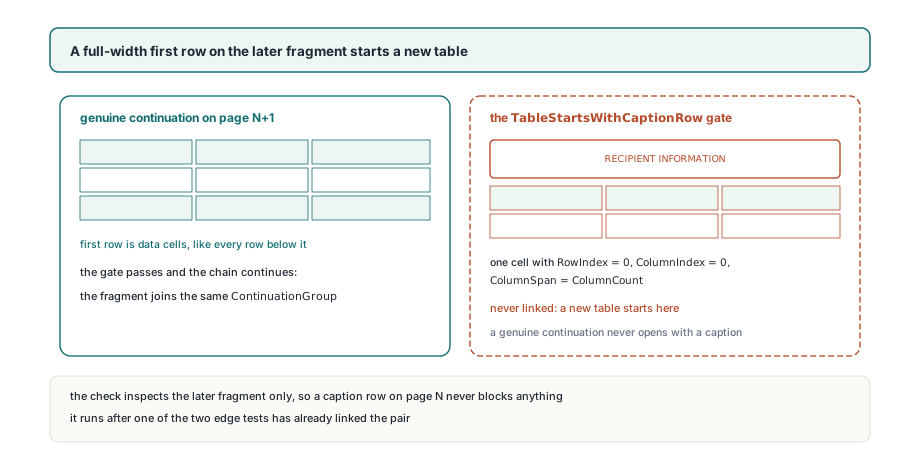
Porovnanie stĺpcov, ktoré nasleduje, TablesHaveMatchingColumns, je prísnejšie než „rovnaký počet stĺpcov“. Prestavia hraničné pozície každého fragmentu z obdĺžnikov buniek, interpoluje hranice, ktoré zlúčené bunky skrývajú, a dvojicu odmietne, keď sa ktorákoľvek hranica posunie viac než o toleranciu. Dve štvorsúpcové tabuľky s odlišnými proporciami tak zostanú oddelené, aj keď všetko ostatné sedí
Čo sa stane s jedným riadkom, ktorý pretečie na ďalšiu stránku?
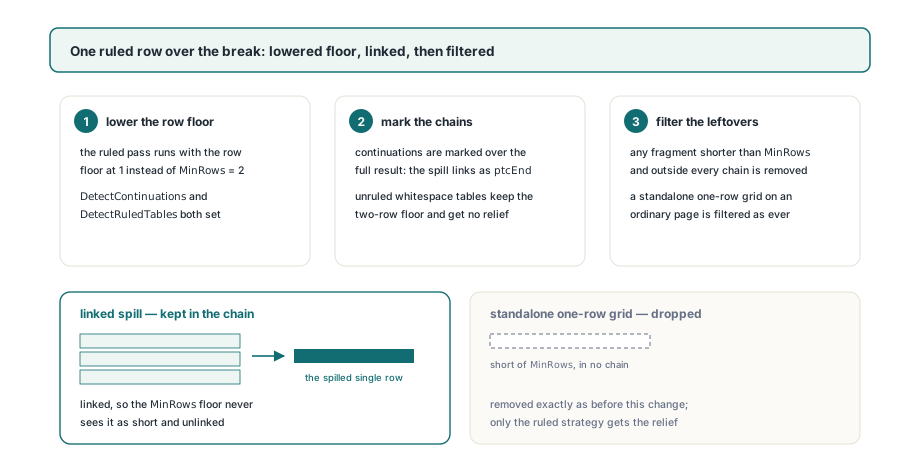
Ohraničená mriežka, ktorá prenesie jeden riadok na nasledujúcu stránku, sa teraz detekuje a prepojí, za predpokladu, že skončí v continuation reťazi; sama o sebe sa zahodí. Defaultné MinRows 2 existuje preto, aby sa zblúdilá dvojica čiar nehlásila ako tabuľka, ale posledný riadok vytlačený cez zlom je skutočný riadok, ktorý tvrdá hranica 2 ticho zahodila, a zvyšok tabuľky vyzeral kompletný, hoci nebol. Dokumentový sken to rieši v troch krokoch. Keď sú nastavené DetectContinuations aj DetectRuledTables, per-page prechod spustí ruled detektor s dočasne zníženou hranicou riadkov na 1, a preto ExtractTables teraz prijíma MinRows 1 pre ohraničené mriežky, kým whitespace detekcia si drží internú hranicu 2. Continuations sa označia na celom výsledku. Potom sa odstráni každá tabuľka, ktorá je kratšia než volajúcim zadané MinRows a nie je súčasťou žiadnej reťaze. Jednoriadkový fragment prežije len preto, že bol prepojený, a jednoriadková mriežka v strede inak obyčajnej stránky sa vyfiltruje presne ako predtým
// Poskladaj každú reťaz do jedného CSV a zahoď zopakované riadky hlavičky
// na continuation fragmentoch
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // hlavička zopakovaná textovým procesorom
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
Dva detaily v tej rutine sú zámerné. Jednoriadkový presah sa nikdy neodstráni, pretože ho stráži guard na RowCount, a textový procesor, ktorý opakuje riadok hlavičky na každej stránke, produkuje fragment, ktorého prvý riadok je hlavička znova, takže zahodenie nultého riadka na middle a end fragmentoch je správne pre ten prípad a nesprávne pre generátor, ktorý hlavičky neopakuje. Skontrolujte jeden dokument, kým tú rutinu pustíte na celý priečinok
Kde pravidlá stále končia
Content-aware test je len taký dobrý, ako textová vrstva, ktorú číta. Na skenovanej strane bez jediného znaku textu spadnú zaznamenané extrémy telového textu na hranice stránky, podmienka „nič medzi“ je splnená vakuózne a zostanú len brány riadku popisku a stĺpcov; ohraničená mriežka na takej strane sa stále nájde ako prázdna kostra, takže reťaz sa môže prepojiť správne, ale o okolitom texte sa v skutočnosti nič neoverilo. Ak na tom záleží, najprv pridajte textovú vrstvu. Päty vykreslené ako obrázky a nie ako text sú pre band logiku neviditeľné a z toho istého dôvodu neškodné
Zóny sú jedno číslo. Päta hlbšia než ContinuationMargin nechá svoje spodné riadky vnútri telovej zóny, čím skorší fragment vyzerá, akoby za ním nasledoval text, a prepojenie sa zablokuje; zvýšte tú voľbu na skutočnú hĺbku zóny, ako to robí prvý príklad. Zvýšte ju príliš a krátky záverečný odsek blízko spodku stránky sa vsunie do zóny a ignoruje sa, čím sa tabuľka prepojí s čímkoľvek, čo za ňou nasleduje. Pravidlo popisku má zrkadlovú poruchu: generátor, ktorý píše zlúčený banner „continued“ ako prvý riadok každého continuation fragmentu, bude mať tie fragmenty odmietnuté ako nové tabuľky, a jediná dnešná náprava je zliepať podľa ContinuationGroup sám, bez povolenia čohokoľvek, pretože to pravidlo nemá vypínač
Whitespace detegované tabuľky nedostanú žiadnu jednoriadkovú úľavu. Whitespace stratégia potrebuje dva zarovnané riadky, aby tabuľku vôbec videla, takže neohraničená tabuľka, ktorá pretečie o jeden riadok, sa stále hlási krátka o ten riadok. Keď na to narazíte, word boxy za structured text blocks a reading order vám dajú surové pozície, z ktorých ho získate späť. Na vzorke, ktorá tento vývoj poháňala — trinásť exportov z textových procesorov a prehliadačov — sa všetkých päť dokumentov so skutočnými viacstranovými tabuľkami prepojilo do jediných reťazí a formulár výpisu, ktorý sa predtým zlial, zostal oddelený, čo je latka, proti ktorej sa vydanie meralo, a nie sľub o každom layoute
Označovanie continuations, pravidlo popisku aj jednoriadkový prechod žijú v dokumentovej ceste zdieľanej buildmi pre Delphi, C++Builder a Lazarus; plné API extrakcie tabuliek opisuje stránka PDFium Component pre Delphi