Tabuľka obsahuje stĺpec s menami zákazníkov. Niektoré sú v čínštine, niektoré v cyrilike, pár nesie nemecké prehlásky alebo francúzsky prízvuk. Exportujete ju do CSV a otvoríte výsledok, a každý znak je neporušený. Exportujete ten istý zošit do RTF pre šablónu hromadnej korešpondencie, otvoríte ho v textovom procesore, a mená mimo ASCII sa zrútili do riadkov plných otáznikov. Dáta sa nikdy nezmenili. Zmenila sa zmluva o kódovaní formátu, do ktorého ste zapisovali, a každá exportná cesta nesie inú
Toto je pasca, ktorá chytí knižnicu, ktorá na povrchu vyzerá plne Unicode-vedomá. Text bunky sa interne uchováva ako WideString, takže model nikdy nestratí znak. Strata nastáva na hranici, vo writeri, ktorý musí serializovať tento text do formátu s vlastnými pravidlami o tom, ktoré bajty sú legálne a ako sa musí zakódovať čokoľvek mimo legálneho rozsahu. Zvládnete jeden writer správne a napriek tomu môžete dodať ďalší, ktorý ten istý text pokazí. Oprava nie je globálny prepínač. Je to samostatné, správne rozhodnutie na každej ceste
RTF je bezpečný 7-bitový formát podľa návrhu
Rich Text Format predchádza Unicode a bol špecifikovaný tak, aby prežil prenosy, ktoré prepúšťajú iba tlačiteľné ASCII. Dokument RTF deklaruje kódovú stránku vo svojej hlavičke, a akýkoľvek znak, ktorý writer nedokáže v danej kódovej stránke reprezentovať, musí byť vyslaný ako escape namiesto ako surový bajt. Relevantný escape je \u, ktorý nesie znamienkovú 16-bitovú kódovú jednotku nasledovanú ASCII záložným znakom pre čitateľov príliš starých na to, aby escape vôbec pochopili
HotXLS zapisuje RTF týmto spôsobom. Hlavička dokumentu sa otvára deklarovaním kódovej stránky, v tvare \ansi\ansicpg1252\uc1, a writer v jednotke lxRTF prechádza každý reťazec a vysiela každý znak nad obyčajné ASCII ako escape \u, takže bajtový tok zostáva 7-bitovo čistý bez ohľadu na to, čo dokáže obsiahnuť deklarovaná kódová stránka. Kódový bod ako U+4E2D sa stane doslovnou sekvenciou \u20013?, nie surovým bajtom, ktorý by sa prehliadač potom pokúsil interpretovať cez akúkoľvek kódovú stránku, ktorú by náhodou predpokladal. Bez tejto disciplíny nemá čokoľvek mimo deklarovanej kódovej stránky žiadnu legálnu bajtovú reprezentáciu, a writer, ktorý vyšle surovú hodnotu, produkuje otázniky, ktorými tento článok začal
Detail, ktorý treba mať na pamäti, je, že deklarovaná kódová stránka a escape sú dve polovice jednej zmluvy. Samotné deklarovanie kódovej stránky nepomôže textu, ktorý leží mimo nej. Vysielanie escapov bez deklarovanej kódovej stránky necháva záložné znaky nejednoznačné. Obe musia byť správne spolu, a preto writer, ktorý zvláda iba jedno z toho, aj tak zlyhá na prvom viacjazyčnom zošite
HTML escapovanie je o viac než len o ostrých zátvorkách
HTML export produkuje viaclistový dokument, ktorého navigačné rámce nesú názvy listov ako viditeľný text. Tieto názvy sú reťazce riadené autorom, ktoré môžu obsahovať akýkoľvek znak, vrátane tých, ktoré majú v značkovaní osobitný význam. List doslovne pomenovaný Q1 & Q2 <draft> musí na stránku doraziť ako escapované entity, inak ostré zátvorky otvoria fantómovú značku a ampersand začne referenciu entity, ktorá nikdy nebola zamýšľaná. Toto je bežné HTML escapovanie, a jeho vynechanie pri popisku rámca je typ opomenutia, ktoré prejde každým testom postaveným na názvoch listov iba z ASCII
Otázka kódovania sedí o vrstvu nižšie. Keď sa znaky mimo ASCII ocitnú v kontexte, ktorý nie je garantovane podávaný ako UTF-8, bezpečnou reprezentáciou je numerická referencia znaku, takže U+00E9 sa zapíše ako é namiesto surového bajtu, ktorého význam závisí od charsetu odpovede. Zrkadlový obraz tohto pravidla platí pri vstupe. Zošit načítaný späť z XLSX nesie zdieľané reťazce, v ktorých znak môže byť už uložený ako numerická XML entita, a táto entita musí byť dekódovaná do jedného celého znaku skôr, než vstúpi do modelu bunky. Dekódujte ju neopatrne, rozdeľte kódový bod na samostatné bajty, a jeden znak sa znovu objaví ako dva kusy mojibake, ktoré žiadny neskorší export nedokáže opraviť
Kontajner XLSX je ZIP, a ZIP má vlastné kódovanie názvov
Súbor XLSX je archív ZIP, a archív ukladá názov pre každý člen, ktorý obsahuje. ZIP je dostatočne starý na to, aby jeho pôvodná špecifikácia nehovorila nič o kódovaní týchto názvov, takže čítačka, ktorá nenájde žiadny signál, predpokladá lokálnu kódovú stránku archívu. Tento predpoklad je nesprávny v okamihu, keď názov člena obsahuje znak mimo ASCII, čo sa stáva pri lokalizovaných názvoch častí zošita a pri vloženom médiu, ktorého názvy súborov nesú diakritiku alebo neladinské písmo
Oprava je jeden jediný bit. Všeobecný bit 11 v každej lokálnej hlavičke súboru deklaruje, že názov člena je kódovaný ako UTF-8. HotXLS kontroluje presne tento bit, keď číta archív, testujúc všeobecné príznaky voči maske $0800, a čítačka alebo writer, ktorý ho ignoruje, nesprávne prečíta názov, ktorý korektná implementácia uložila ako UTF-8. Bit je lacné nastaviť a lacné rešpektovať, a je to celý rozdiel medzi názvom člena, ktorý prežije cestu tam a späť, a takým, ktorý dorazí poškodený skôr, než je vôbec analyzovaný obsah zošita
Skladanie veľkosti písmen a skenovanie čísel skrývajú rovnaké nebezpečenstvo
Vyhodnocovanie vzorcov je miesto, kde bezpečnosť Unicode prestáva byť o serializácii a stáva sa o porovnávaní. Funkcia SEARCH nerozlišuje veľkosť písmen, čo znamená, že musí skladať veľkosť písmen skôr, než hľadá podreťazec. Nesprávny spôsob skladania je cez kódovú stránku ANSI, pretože prevod textu mimo ASCII na veľké písmená týmto spôsobom smeruje znaky cez úzku kódovú stránku a poškodzuje čokoľvek mimo nej. Správny spôsob je skladanie širokých reťazcov na veľké písmená, ktoré zachováva celý rozsah UTF-16. HotXLS skladá pomocou WideUpperCase presne z tohto dôvodu, takže vyhľadávanie akcentovaného alebo neladinského textu nájde tie isté znaky, ktoré dostalo, a nie ich aproximáciu poškodenú kódovou stránkou
Tokenizér vzorcov nesie súvisiacu povinnosť, ktorá nemá nič spoločné s písmenami a všetko spoločné s tým, kde token končí. Vedecká notácia ako 1E3 alebo 2.5E-3 je jeden číselný literál, a skener musí rozpoznať E, voliteľné znamienko a nasledujúce číslice ako súčasť čísla namiesto rozdelenia vstupu na názov nasledovaný samostatným číslom. Skener, ktorý toto nezvláda správne, zmení dokonale platnú konštantu na chybu parsovania alebo, čo je horšie, na ticho nesprávny výraz. Patrí do tej istej diskusie, pretože oba prípady sú o tom, že čítačka robí správne rozhodnutie na úrovni znaku: jedno o tom, ako skladať znak na porovnanie, druhé o tom, či znak pokračuje v aktuálnom tokene
Vytváranie a export viacjazyčného zošita
Verejné API vás nežiada, aby ste nad tým čímkoľvek premýšľali. Zošit zostavíte z hodnôt buniek typu WideString a zavoláte vstupný bod exportu, ktorý chcete. Rozhodnutia o kódovaní sa dejú vnútri každého writera. Nižšie uvedený príklad naplní list textom v niekoľkých písmach, potom zapíše z toho istého zošita súbor RTF aj súbor HTML, takže obe cesty bežia proti identickému vstupu
uses
  lxHandle;

procedure ExportMultilingualWorkbook;
var
  Book: IXLSWorkbook;
  Sheet: IXLSWorksheet;
begin
  Book := TXLSWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Customers');

    Sheet.Cells[1, 1].Value := 'Name';
    Sheet.Cells[1, 2].Value := 'City';

    // Text bunky sa uchováva ako WideString, takže každé písmo prežije model.
    Sheet.Cells[2, 1].Value := '王伟';          // čínština
    Sheet.Cells[2, 2].Value := '北京';
    Sheet.Cells[3, 1].Value := 'Müller';        // nemecký prehlások
    Sheet.Cells[3, 2].Value := 'Köln';
    Sheet.Cells[4, 1].Value := 'Иванов';        // cyrilika
    Sheet.Cells[4, 2].Value := 'Москва';
    Sheet.Cells[5, 1].Value := 'Désirée';       // francúzske akcenty
    Sheet.Cells[5, 2].Value := 'Montréal';

    // RTF: writer lxRTF deklaruje kódovú stránku a vysiela každý
    // znak mimo ASCII ako escape \u, čím udržiava súbor 7-bitovo čistý.
    Book.SaveAsRTF('Customers.rtf');

    // HTML: názvy listov sú HTML-escapované a text mimo ASCII sa zapisuje
    // tak, aby nezávisel od odhadovaného charsetu odpovede.
    Book.SaveAsHTML('Customers.html');
  finally
    Book := nil;
  end;
end;
Obidve volania vrátia stav typu Integer, a obidve spracúvajú ten istý text v pamäti. Nič vo volajúcom kóde nedeklaruje kódovú stránku ani neescapuje znak, pretože zodpovednosť leží na writeri, ktorý pozná svoj vlastný formát. SaveAsCSV na úrovni zošita nasleduje rovnaký tvar, ak potrebujete oddeľovačový export z identického zdroja
// Ten istý zošit, tretia exportná cesta s vlastnými pravidlami kódovania.
Book.SaveAsCSV('Customers.csv');
Bezpečnosť Unicode je na ceste, nie na knižnici
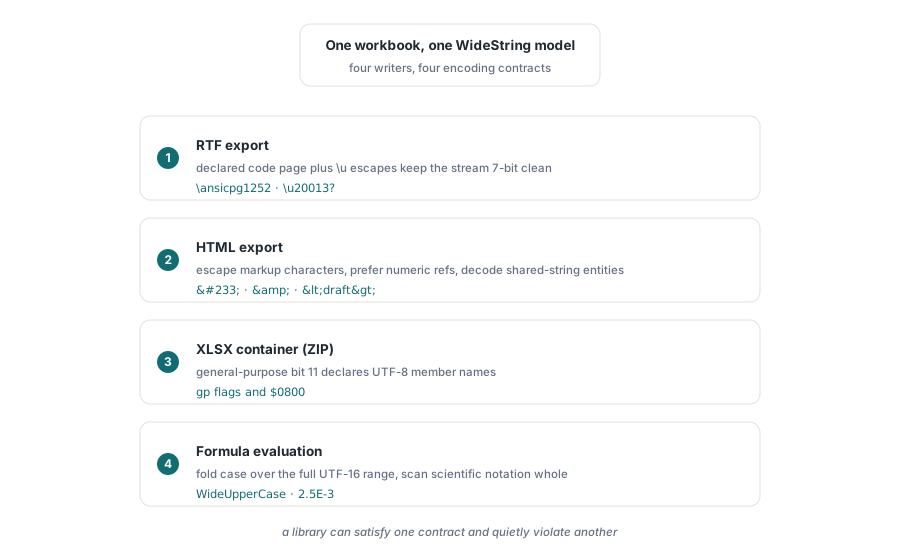
Ponaučenie, ktoré stojí za to si odniesť, je, že neexistuje jediné miesto, kde treba byť bezpečný voči Unicode. RTF potrebuje deklarovanú kódovú stránku plus escape \u. HTML potrebuje escapovanie entít pre znaky s významom v značkovaní a numerické referencie tam, kde charset nie je garantovaný, plus správne dekódovanie entít, ktoré prichádzajú v zdieľaných reťazcoch. Kontajner ZIP potrebuje nastavený všeobecný bit 11, aby sa názov člena v UTF-8 čítal ako UTF-8. Vyhodnocovanie vzorcov potrebuje skladanie veľkosti písmen širokých reťazcov a tokenizér, ktorý drží vedeckú notáciu vcelku. Každé z týchto je iná zmluva, a knižnica môže splniť jednu, pričom ticho poruší inú. To je dôvod, prečo nástroj, ktorý zvláda CSV správne, vám aj tak môže odovzdať RTF plný otáznikov
Ak sa vaše exporty opierajú o oddeľovačové formáty, kompromisy medzi nimi sú pokryté v našom prehľade exportu CSV, TSV a HTML, a keď je zdrojom výsledková množina namiesto ručne zostaveného listu, vzory v exporte databázy pre reporty v Delphi sa prirodzene spájajú s pravidlami kódovania opísanými tu. Všetko je súčasťou HotXLS Delphi Component pre Delphi a C++Builder, spolu s API na čítanie, vzorce a formátovanie pokrytými inde na tomto blogu