HotXLS, natívna Excel knižnica pre Delphi a C++Builder, parsuje hárky XLSX na viacerých vláknach cez trojfázové načítanie: XML hárkov sa sériovo dekomprimuje, paralelne parsuje a malé časti sa čítajú sériovo až potom. Prvé vydanie tejto funkcie získalo len 12–25 %, pretože zámok predvoleného správcu pamäte v Delphi pracovné vlákna zoradil za sebou. Zníženie alokácií na halde zhruba z 20 na 9,1 na bunku zdvihlo paralelné zrýchlenie na ×1,90 pri ôsmich vláknach. Tento článok prechádza merania, slepé uličky a dve opravy, ktoré naozaj zabrali
Ako HotXLS parsuje hárky XLSX paralelne?
HotXLS rozdeľuje Open do troch fáz a na pracovných vláknach beží len tá stredná. Dôvodom je zipový kontajner: zipový archív je jediným zdieľaným vstupným streamom s jediným stavovým automatom inflate a ten nemôžu čítať dve vlákna naraz. Obaliť ho zámkom by nemalo zmysel, pretože inflate je pre jednu položku vo svojej podstate sériový, takže by zámok len zopakoval sériové vykonávanie s réžiou navyše. Fáza A preto dekomprimuje XML každého hárka do vlastného TMemoryStream, ešte kým je beh jednovláknový; v našom benchmarkovom súbore to trvalo asi 4 ms pre osem častí hárkov, takže to nie je ani zďaleka úzkym miestom. Fáza B spúšťa ParseWorksheetXml pre každý hárok na fonde pracovných vlákien, a práve tam sídli takmer celý čas načítania. Fáza C sa vracia k zipu sériovo kvôli malým častiam: komentárom, kresbám, grafom a tabuľkám
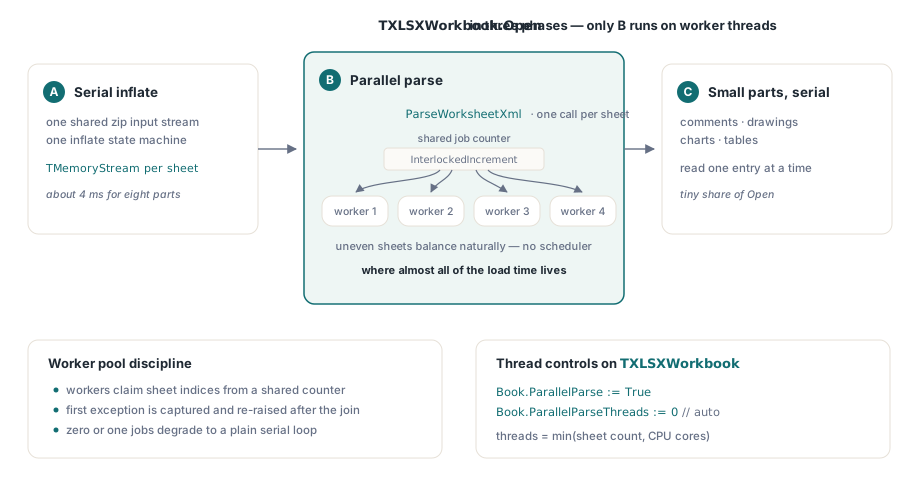
Samotný fond pracovných vlákien je zámerne jednoduchý. Pracovníci si ťahajú indexy úloh zo zdieľaného počítadla cez InterlockedIncrement, takže hárky nerovnakej veľkosti sa vyvážia prirodzene bez akéhokoľvek plánovača. Počet vlákien je min(sheet count, CPU cores), prvá výnimka z pracovníka sa zachytí cez AcquireExceptionObject a po pripojení vlákien sa znovu vyhodí na hlavnom vlákne, a dispečer degraduje na obyčajnú sériovú slučku, keď sú úlohy nula alebo jedna. Funkciu riadia dve vlastnosti na TXLSXWorkbook: ParallelParse otvára bránu fondu a ParallelParseThreads obmedzuje počet vlákien, pričom 0 znamená automaticky. Profitujú z toho viachárkové zošity vrátane tých, ktoré vytvoríte duplikovaním šablónového hárka niekoľko desiatok ráz
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // zapne fond paralelných pracovných vlákien
    Book.ParallelParseThreads := 0;  // 0 = auto: min(hárky, jadrá CPU)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... čítajte bunky ako obvykle; zošit je plne zmaterializovaný ...
  finally
    Book.Free;
  end;
end;
Prečo pridanie vlákien parsovanie XLSX v Delphi spomalí?
Pretože predvolený správca pamäte v Delphi chráni svoju haldu globálnym zámkom a parsovanie hárkov je alokačne husté: bunky, Varianty a WideStringy po miliónoch. Každý pracovník, ktorý sa dotkne haldy, sa na tom zámku zaradí do frontu, takže vlákna, ktoré v zdrojovom kóde vyzerajú nezávisle, sa v praxi vykonávajú takmer po jednom. Náš prvý benchmark to urobil bolestivo konkrétnym. Na zošite s 8 hárkami po 5 000 riadkoch a 4 stĺpcoch, meranom na i5-11600K (6 jadier, 12 vlákien) pod Win64, sa paralelné Open zlepšilo len o 12–25 % oproti plánovanému odhadu aspoň 40 %. Prehliadka počtov vlákien 2, 3, 4, 6 a 8 dala plochú krivku a v neskorších inštrumentovaných behoch bola konfigurácia s 2 vláknami dokonca o 26 % pomalšia než sériová, čo je klasický podpis dvoch vlákien, ktoré si medzi sebou pinkajú sporný zámok
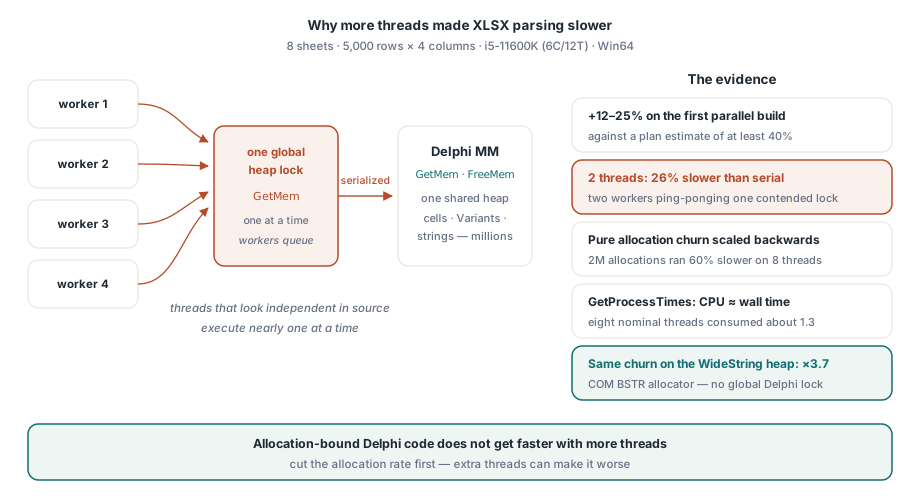
Diagnózu pripli tri merania a každé prevrátilo tú predchádzajúcu intuíciu. Po prvé, drobný súbor (8 hárkov po 1 riadku) sa otvoril za 1,2 ms, čím sa dokázalo, že parsovanie je v podstate 100 % operácie Open a nebolo možné zvaľovať vinu na skrytý fixný náklad. Po druhé, mikrobenchmark čistého alokačného ruchu ukázal, že správca pamäte v Delphi sa škáluje opačne: rovnaký celkový objem 2 miliónov alokácií objektov a AnsiStringov bežal na 8 vláknach o 60 % pomalšie než na jednom, kým ten istý ruch voči halde WideString, ktorá je alokátorom COM BSTR a nie správcom pamäte Delphi, sa škáloval na ×3,7. To, že HotXLS používa WideString všade, sa ukázalo ako historická náhoda hrajúca v náš prospech. Po tretie, GetProcessTimes ukázal, že počas paralelného Open sa čas CPU zhruba rovnal reálnemu času: osem nominálnych vlákien spotrebúvalo asi 1,3 vlákna času CPU. Pracovníci sa netočili naprázdno; spali v ceste sporu správcu pamäte, boli blokovaní, nie zaneprázdnení
Praktické ponaučenie sa dá zovšeobecniť ďaleko za tabuľky. Ak záťaž v Delphi ťažko alokuje, zvyšovanie počtu vlákien neurobí nič, kým neklesne miera alokácií, a môže veci ľahko zhoršiť. Pred touto opravou sme používateľom ladiacim ParallelParseThreads hovorili úprimnú pravdu: pri súboroch viazaných na alokácie viac vlákien nekúpilo takmer nič
Odkiaľ sa berie 20 alokácií na halde na bunku?
Počítací obal nainštalovaný cez SetMemoryManager odpovedal na túto otázku presne: asi 20 alokácií správcu pamäte Delphi na bunku, z toho 2,87 milióna s veľkosťou 32 bajtov a menej. Vinníkom neboli objekty buniek vôbec. TXMLScaner.GetTokenValue materializoval čerstvý AnsiString pri každom volaní a volá sa zhruba 15–20 ráz na bunku: raz za názvy elementov, raz za názvy atribútov, raz za hodnoty atribútov a raz za textový obsah. Navrch cesta cez UTF8ToWideString v RTL vyrábala pri každom prevode dočasný medzičlánok typu UnicodeString. Objekty buniek predstavovali len 160 tisíc alokácií, teda asi 8 % z celku, čo na mieste zabilo náš pôvodný plán: chceli sme postaviť fond objektov buniek a čísla hovorili, že sa nikdy nezaplatí
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // ruch malých objektov, ktorý nás zaujíma
  Result := OldMM.GetMem(Size);
end;

// nainštalovať pred Open, potom obnoviť
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Túto desaťminútovú diagnostiku sa oplatí ukradnúť pre akékoľvek vyšetrovanie výkonu v Delphi. Počítanie alokácií podľa veľkostných priehradiek stojí takmer nič a povie vám, odkiaľ tlak na správcu pamäte naozaj pochádza, čo boli v našom prípade dva zvyky na úrovni RTL vnútri XML skenera, a nie čokoľvek v objektovom modeli. Profilery neustále ukazovali na parser ako celok; obal ukázal na dva konkrétne riadky
Oprava: internovanie tokenov a dekodér UTF-8 bez medzičlánku
Dve cielené zmeny v čítačke XML odstránili viac než polovicu alokácií na bunku bez toho, aby sa dotkli štruktúry parsera. Prvou je internovanie názvov elementov. XML hárkov donekonečna opakuje drobný slovník: row, c, v, r, t, s a hŕstku názvov atribútov. InternTokenName drží 64-slotovú cache už videných názvov a porovnáva buffer staviteľa v skeneri s uloženou položkou cez TokenEqualsAnsi, čo je priame porovnanie bajtov, ktoré nealokuje nič. Pri zásahu vráti uložený AnsiString a tu záleží na voľbe typu: AnsiString je počítaný odkazmi, takže vrátenie uloženej inštancie stojí jedno zvýšenie počtu odkazov a nulovú prevádzku na halde. WideString počet odkazov nemá a každé priradenie ide cez SysAllocString, takže internovanie WideStringov by neušetrilo nič. Internovanie sa oplatí len pri reťazcovom type počítanom odkazmi
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // len refcount++, žiadna alokácia
  else
  begin
    Result := GetTokenValue;        // zmaterializovať raz, potom uložiť do cache
    FInternNames[Slot] := Result;
  end;
end;
Druhá zmena útočí na text buniek. Stará cesta postavila token typu AnsiString, odovzdala ho funkcii UTF8ToWideString, ktorá postavila medzičlánok typu UnicodeString, ktorý sa napokon previedol na WideString ukladaný do bunky: dve alokácie správcu pamäte Delphi na textový token ešte pred tou skutočnou. Náhrada, XmlUtf8ToWide(TokenPtr, TokenLen), je dvojprechodovým čisto pascalovským dekodérom UTF-8, ktorý číta priamo zo skenovacieho bufferu: prvý prechod odmeria dĺžku v UTF-16, druhý dekóduje do jedenkrát alokovaného WideStringu. Čistý náklad na textový token: jedna alokácia COM, nula alokácií správcu pamäte Delphi. Jedna sémantická poznámka pre opatrných: pri chybne sformovaných sekvenciách UTF-8 nový dekodér bajty prepustí namiesto toho, aby ich nahrádzal náhradnými znakmi tak ako RTL, čo ovplyvňuje len to, ako degradujú poškodené súbory; pri platnom vstupe je výstup bajtovo identický. Znakové entity XML sa k dekodéru nikdy nedostanú, pretože skener ich už v bufferi tokenu vyhodnotil do UTF-8
Čo to prinieslo a kde paralelné parsovanie stále nepomôže
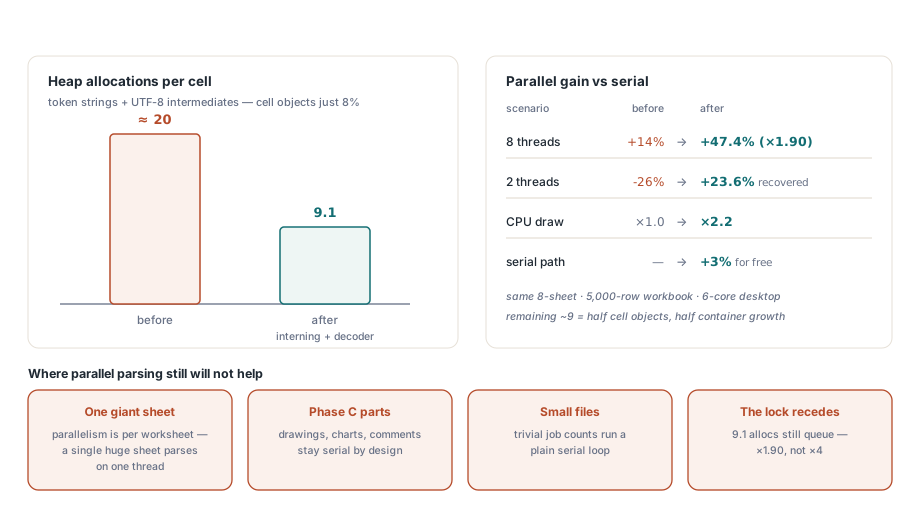
Obe opravy znížili alokácie na bunku z asi 20 na 9,1 a paralelné čísla sa pohli tak, ako teória hovorila, že by mali. Na tom istom benchmarku s 8 hárkami po 5 000 riadkoch a na tom istom stroji 6C12T sa zlepšenie pri 8 vláknach posunulo zo 14 % na 47,4 %, teda ×1,90 zrýchlenie oproti sériovému behu. Prípad s 2 vláknami sa preklopil z 26 % pomalšieho na 23,6 % rýchlejší a nameraná využitosť CPU stúpla z ×1,0 na ×2,2. Sériová cesta ako bonus zrýchlila asi o 3 %, keďže menej alokácií pomôže aj jedinému vláknu. Zvyšných približne 9 alokácií na bunku tvoria zhruba na polovicu objekty buniek a na polovicu amortizovaný rast kontajnerov; odmerali sme ich, vyhodnotili výnosy ako klesajúce a zastali sme, pričom obal správcu pamäte je pripravený znovu odobrať vzorky podľa miesta volania, ak si budúca záťaž vyžiada ďalšie kolo
Hranice si zaslúžia byť pomenované rovnako otvorene ako výhry. HotXLS paralelizuje na úrovni hárkov, takže zošit, ktorý je jedným obrovským hárkom, sa parsuje na jednom vlákne bez ohľadu na to, čo hovorí ParallelParseThreads; pre taký tvar je lepším nástrojom streamovaná priama čítačka, keďže sa materializácii zošita vyhne úplne. Súbory, ktorých čas ide do častí fázy C, teda do kresieb, grafov a komentárov, profitujú menej, pretože táto fáza zostáva sériová zámerne. Pri malých súboroch sa vlákna neoplatia vôbec, a preto dispečer pri triviálnom počte úloh ticho beží sériovo. A strop správcu pamäte nezmizol, len ustúpil: pri 9,1 alokáciách na bunku globálny zámok pracovníkov stále zdaňuje, a práve preto osem vlákien dá ×1,90 a nie ×4. Širšiu sadu nástrojov na skrátenie časov načítania a ukladania vrátane štýlov, fondov a hromadných spätných volaní po riadkoch nájdete v našom sprievodcovi výkonom veľkých zošitov v Delphi
Paralelné parsovanie XLSX, vlastnosti ParallelParse a ParallelParseThreads aj alokačne úsporná čítačka XML tu opísaná sa dodávajú ako štandardné súčasti komponentu HotXLS Delphi Excel Component, ktorý číta a zapisuje XLS, XLSX aj ODS natívne z Delphi a C++Builderu bez akejkoľvek automatizácie Excelu