HotXLS Delphi Excel Component udrží OpenDocument data pilot tabuľky počas cyklu otvorenia a uloženia ODS tak, že pri otvorení doslovne zachytí podstrom <table:data-pilot-tables> z content.xml a pri uložení ho prehrá — od v2.382.0. Od v2.382.1 fragment nesie aj každú XML namespace väzbu, ktorú deklarovali jeho predkovia, takže uložená pivot definícia zostáva well formed pre každého konzumenta, nielen pre HotXLS
Bug, ktorý vynútil obe zmeny, vzišiel z prísneho corpus behu. Vzorka official-pivot.ods, zapísaná development buildom LibreOffice 6.1, drží jeden pivot s menom DataPilot1, ktorý číta Sheet1.A2:E30 a svoj výsledok umiestňuje do Sheet1.G6:J18. Otvorte ho v HotXLS, uložte nezmenený a spočítajte elementy <table:data-pilot-table> na výstupe: jeden dnu, nula von, na Win32 aj Win64 rovnako. Nič v teste sa pivota nedotklo. Prvé kolo sond porovnávalo len konštanty buniek a prešlo; až štrukturálna assertion odhalila tú stratu, čo je pripomienka, že „hodnoty sedia“ je slabá definícia vernosti round-tripu
Prečo ODS pivot zmizne po uložení knižnicou?
ODS pivot zmizne preto, že HotXLS nemá in-memory model pre OpenDocument data pilot tabuľky a ODS writer stavia content.xml úplne z modelu. Writer skladá automatické štýly, jeden <table:table> na worksheet, <table:content-validations>, <table:named-expressions> a <table:database-ranges>, každé generované z objektov, ktoré workbook naozaj drží. Pivot definícia — ODF 1.3 Part 3 §9.6, kontajner <table:data-pilot-tables> s jedným <table:data-pilot-table> na pivot, nesúci svoj table:source-cell-range, svoje deti table:data-pilot-field, svoju table:target-range-address a table:buttons — nemá v čom žiť, takže regenerovaná časť ju jednoducho vynechá
Kontrast s XLSX je zámerný. HotXLS parsuje SpreadsheetML pivot cache a pivot tabuľky do skutočného modelu, ktorý môžete stavať, rozširovať o calculated fields a obnovovať z Delphi, takže tie uloženie prežijú, pretože sa prepisujú, nie kopírujú. ODS pivoty sú oveľa zriedkavejšia požiadavka a modelovať ODF data pilot slovník len kvôli round-tripu by znamenalo veľa kódu, ktorý nikto needituje. Pragmatická odpoveď je tá istá, ktorú HotXLS už aplikuje na neznáme extLst bloky v XLSX: nechaj si to, čo nemodeluješ, bajt po bajte, ak sa dá, event po evente, ak sa nedá
Čo urobilo prvé zachytenie postavené na Pos zle?
Zachytenie vo v2.382.0 vykrojilo pivot definíciu z content.xml ako obyčajný reťazec a v tom výreze chýbali namespace deklarácie, ktoré ju robili zmysluplnou. Implementácia bola taká krátka, ako to znie — dekóduj časť do WideString, nájdi otvárací tag cez Pos, nájdi za ním zatvárací tag, skopíruj rozsah do FRawOdsDataPilotTablesXml na workbooku:
// HotXLS v2.382.0 -- nahradené o jedno vydanie neskôr
function OdsCaptureDataPilotTablesXml(Stream: TStream): WideString;
const
  OpenTag: WideString = '<table:data-pilot-tables';
  CloseTag: WideString = '</table:data-pilot-tables>';
var
  Text: WideString;
  StartPos, ClosePos: Integer;
begin
  Result := '';
  Text := LoadPartAsWideString(Stream);   // celý content.xml v pamäti
  StartPos := Pos(OpenTag, Text);
  if StartPos = 0 then Exit;
  ClosePos := Pos(CloseTag, Copy(Text, StartPos, MaxInt));
  if ClosePos = 0 then Exit;
  Result := Copy(Text, StartPos, ClosePos + Length(CloseTag) - 1);
end;
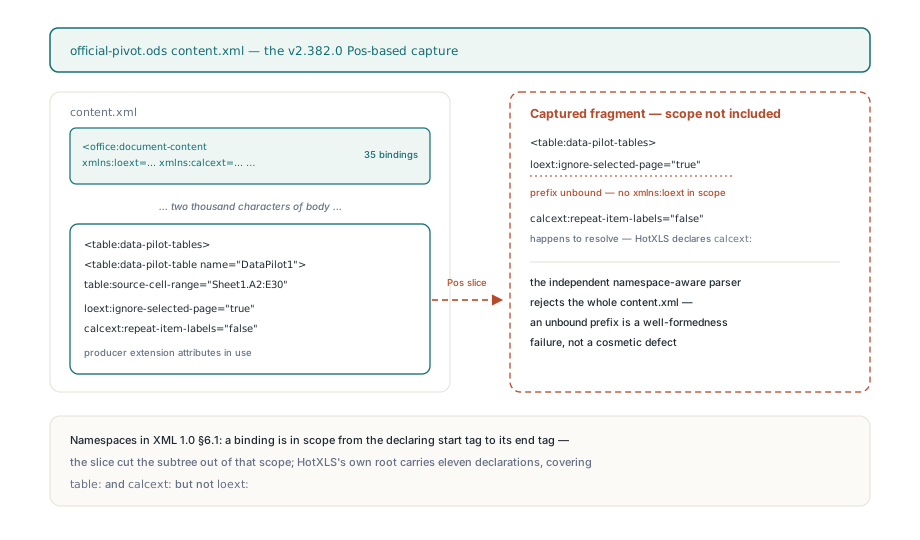
Assertion na počet prešla na zeleno a oprava vyšla. Chytila ju až druhá, prísnejšia kontrola pridaná v ten istý deň: každá XML časť uloženého package ide do nezávislého namespace-aware parsera mimo HotXLS, a ten parser odmietol nový content.xml s chybou neviazaného prefixu. Pivot z LibreOffice nesie producer extension atribúty — loext:ignore-selected-page="true" na page field a calcext:repeat-item-labels="false" na každej úrovni — a vykrojený reťazec tie atribúty obsahoval, ale nie deklarácie xmlns:loext a xmlns:calcext, ktoré ich viažu. Tie deklarácie sedeli v koreni <office:document-content> zdrojového súboru, tridsaťpäť ich bolo, dva tisíc znakov od pivota
W3C Namespaces in XML 1.0 §6.1 definuje pravidlo, ktoré z toho robí tvrdé zlyhanie a nie kozmetickú vadu: namespace deklarácia je v scope od štartovacieho tagu elementu, na ktorom sa objaví, po jeho koncový tag, a každé prefixované meno v tom scope sa proti nej rozlíši. Vykrojte podstrom z dokumentu a vykrojíte ho aj zo scope. HotXLS zapisuje vlastný koreň <office:document-content> s jedenástimi deklaráciami — office, table, text, style, number, fo, draw, svg, xlink, calcext, tableooo — takže calcext: sa náhodou rozlíšil, table: sa rozlíšil a loext: nie. Namespace-aware parser berie neviazaný prefix ako porušenie well-formedness, čo znamená, že celá časť je nečitateľná, nie len jeden atribút
Ako HotXLS prenáša xmlns väzby predkov na fragment?
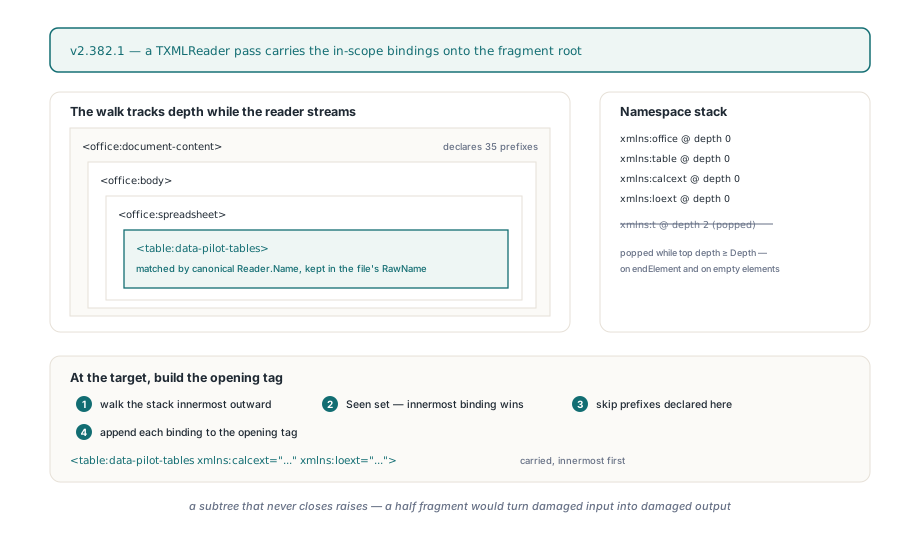
HotXLS v2.382.1 nahradil vykrojenie reťazca prechodom cez content.xml vlastným streaming readerom TXMLReader, pričom drží zásobník namespace väzieb označených hĺbkou, v ktorej bola každá deklarovaná, a väzby, ktoré sú stále v platnosti, skopíruje na koreňový element fragmentu v momente, keď sa dosiahne cieľ. Reader beží so zapnutým PreserveWhitespaceText, takže textové nody sa vrátia presne tak, ako boli zapísané, a prestavané tagy používajú TXMLReader.RawName a TXMLReader.Attribute[I].RawName — teda pravopis prefixu zo súboru — a nie kanonické mená, ktoré reader bežne podáva part parserom. Tu je jadro tej slučky:
// Namespaces: TStringList hodnôt 'xmlns:p=uri' s hĺbkou deklarácie v Objects[]
while Reader.Read do
begin
  if CaptureDepth >= 0 then
    XlsxAppendRawXmlReaderNode(Result, Reader);   // element, text, CDATA, komentár
  if Reader.NodeType = xmlntElement then
  begin
    for I := 0 to Reader.AttributeCount - 1 do
    begin
      AttrName := Reader.Attribute[I].RawName;
      if (AttrName = 'xmlns') or (Pos(WideString('xmlns:'), AttrName) = 1) then
        Namespaces.AddObject(String(AttrName) + '=' + String(Reader.Attribute[I].Value),
          TObject(NativeInt(Depth)));
    end;
    if (CaptureDepth < 0) and (Reader.Name = 'table:data-pilot-tables') then
    begin
      Opening := XlsxRawXmlReaderOpenTag(Reader);   // najprv strhni koncové '>' alebo '/>'
      ...
      // Prenes efektívne väzby predkov na koreň fragmentu.
      for I := Namespaces.Count - 1 downto 0 do
      begin
        AttrName := WideString(Namespaces.Names[I]);
        if Seen.IndexOf(String(AttrName)) >= 0 then Continue;   // vyhráva najvnútornejšia väzba
        Seen.Add(String(AttrName));
        if not Reader.HasAttribute(AttrName) then               // už deklarované tu? preskoč
          Opening := Opening + ' ' + AttrName + '="' +
            XlsxEscapeAttr(WideString(Namespaces.ValueFromIndex[I])) + '"';
      end;
      ...
      CaptureDepth := Depth;
    end;
    if not Reader.IsEmptyElement then Inc(Depth);
  end
  else if Reader.NodeType = xmlntEndElement then
  begin
    Dec(Depth);
    if Depth = CaptureDepth then Exit;                           // podstrom uzavretý
  end;
  if (Reader.NodeType = xmlntEndElement) or
     ((Reader.NodeType = xmlntElement) and Reader.IsEmptyElement) then
    while (Namespaces.Count > 0) and
          (NativeInt(Namespaces.Objects[Namespaces.Count - 1]) >= Depth) do
      Namespaces.Delete(Namespaces.Count - 1);                   // opusti scope
end;
if CaptureDepth >= 0 then
  raise Exception.Create('OpenDocument pivot definition ended inside an element');
Správnosť v tej slučke nesú tri detaily. Prechod zásobníka od najvnútornejšej väzby smerom von a zapamätanie si každého prefixu v Seen implementuje shadowing: ak bližší predok predefinuje xmlns:table, vyhráva tá bližšia hodnota, presne ako §6.1 vyžaduje. Preskočenie prefixov, ktoré element už deklaruje sám, zabráni tomu, aby sa ten istý atribút emitoval dvakrát, čo by bola iná chyba well-formedness. A pravidlo odstraňovania platí pri koncových tagoch aj pri prázdnych elementoch, pretože <x/> nikdy nevyprodukuje event EndElement — tá istá self-closing pasca, ktorú sa muselo naučiť zachytenie extLst v XLSX. Zhoda cieľa podľa Reader.Name a nie RawName je tichšie víťazstvo: reader kanonizuje ODF table namespace URI na prefix table, takže producent, ktorý ho píše ako t:data-pilot-tables, stále sedí, kým emitovaný fragment si drží akýkoľvek prefix producent použil
Slučka tiež odmieta hádať. Ak časť skončí, kým je zachytenie ešte otvorené — teda odseknutý alebo malformovaný content.xml — OdsCaptureDataPilotTablesXml vyhodí výnimku namiesto toho, aby vrátil polovičný fragment, pretože polovičný fragment by sa pri uložení zapísal späť a z poškodeného vstupu by spravil poškodený výstup s menom knižnice na ňom
Kam fragment pristane v uloženom content.xml?
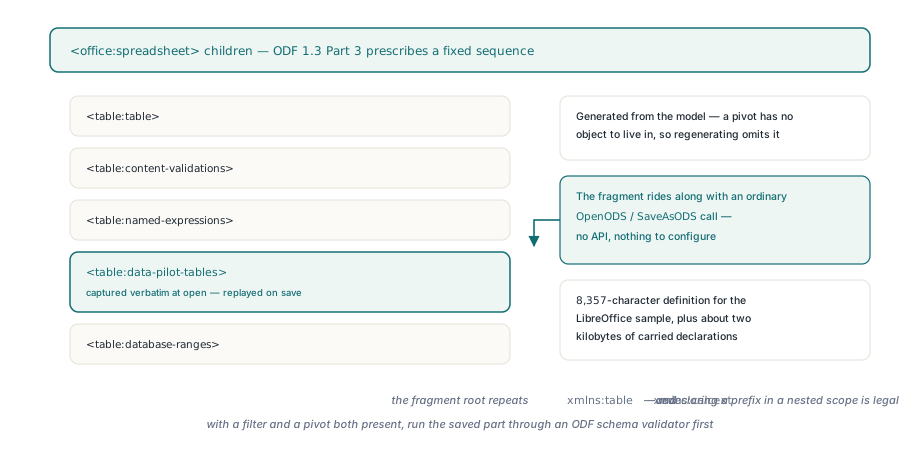
HotXLS zapisuje zachytený fragment do <office:spreadsheet> hneď za <table:named-expressions>, ktoré generuje, a pred <table:database-ranges>. Content model <office:spreadsheet> z ODF 1.3 Part 3 predpisuje pevnú postupnosť pre tieto koncové deti, takže doslovný blok sa nedá jednoducho pripojiť tam, kde writer práve je; musí sa vložiť do konkrétneho slotu. Zo strany volajúceho neexistuje žiadne API a nič sa nenastavuje; definícia ide so sebou pri obyčajnom otvorení a uložení:
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS('official-pivot.ods') <> 1 then
      raise Exception.Create('open failed');
    Book.Sheets[0].Cells[2, 5].Value := 1250.0;   // úprava vnútri zdrojového rozsahu pivota
    Book.SaveAsODS('official-pivot-out.ods');
    // content.xml na výstupe stále nesie DataPilot1 so svojím
    // zdrojovým rozsahom, poľami, cieľovým rozsahom, tlačidlami a loext:/calcext: atribútmi
  finally
    Book.Free;
  end;
end;
Tá redundancia je zámerná a stojí za to o nej vedieť. Koreň fragmentu teraz opakuje xmlns:table a xmlns:calcext, aj keď ich deklaruje aj koreň uloženého dokumentu; Namespaces in XML dovoľuje predeklarovať prefix vo vnorenom scope, takže duplikáty sú neškodné. Pre vzorku z LibreOffice je prenášaná množina všetkých tridsaťpäť koreňových deklarácií, teda asi dva kilobajty navyše k definícii s 8 357 znakmi, pretože zachytenie neanalyzuje, ktoré prefixy podstrom naozaj používa. Sken použitých prefixov by to orezal a možno príde neskôr; najprv správnosť, potom kompaktnosť
Pravidlo pre vykrajovanie podstromov z XML na doslovné prehratie
Všeobecná lekcia je, že podstrom je samostatný až vtedy, keď ho takým spravíte, a namespace scope je prvá vec, ktorá sa pokazí, keď na to zabudnete. Checklist, ktorý HotXLS teraz aplikuje na každé zachytenie typu „nechaj si, čo nemodelujeme“:
- Prejdite dokument skutočným readerom a sledujte väzby v scope. Hľadanie reťazca cez
Posscope nevidí vôbec a navyše sa pomýli na vnorených elementoch s rovnakým menom, na zhodnom reťazci vnútri komentára aleboCDATAsekcie a na hodnotách atribútov, ktoré náhodou obsahujú text tagu - Skopírujte efektívne väzby na koreň fragmentu, od najvnútornejšej, raz na prefix, a preskočte to, čo koreň už deklaruje
- V emitovaných tagoch si držte surový pravopis prefixu; cieľ hľadajte podľa rozlíšeného namespace, nie podľa doslovného prefixu
- Zachovajte whitespace textové nody a pamätajte, že prázdny element uzatvára svoj vlastný scope bez eventu koncového tagu
- Validujte uloženú časť parserom, ktorý nie je testovanou knižnicou. Knižnica si s radosťou znovu prečíta vlastný výstup tou istou benevolentnou cestou, ktorá ho zapísala
Práve posledný bod našiel HXLS-003 druhýkrát. Akceptačná kontrola vo v2.382.0 bola regulárny výraz počítajúci štartovacie tagy data-pilot-table v uloženom content.xml, a regulárny výraz vidí tag, nie dokument — je slepý k tomu, či prefixy na tom tagu sú viazané. Prísny corpus runner pridaný vo v2.382.1 parsuje každú XML a .rels časť uloženého package namespace-aware parserom a potom porovná pivot strom — tag, zoradené atribúty, text, deti, rekurzívne — s originálom. To porovnanie je namespace-expanded, takže iný pravopis prefixu by stále prešiel, ale neviazaný prefix nemá šancu
Kde doslovná záruka končí
Doslovné prehratie definíciu zachová; nerozumie jej, a z toho plynú aj hranice. HotXLS nevystavuje žiadne API na čítanie, úpravu ani obnovu ODS pivota, takže FRawOdsDataPilotTablesXml je interné pole a jediné pozorovateľné správanie je, že definícia prežije. Fragment sa reserializuje z eventov readera, nie kopíruje ako bajty: úvodzovky atribútov a self-closing formy sa normalizujú, kým text a whitespace zostávajú. Zachytené XML emituje len ODS content writer, takže workbook otvorený z .ods a uložený ako .xlsx pivot stratí a workbook otvorený z .xlsx nemá čo prehrať do uloženia .ods — asymetrie importnej a exportnej cesty ODS platia tu ako všade. A keďže je definícia nepriehľadná, nedokáže sledovať vaše úpravy: premenujte Sheet1 alebo presuňte zdrojové dáta v HotXLS a uložený pivot stále ukazuje na Sheet1.A2:E30, čím nechá konzumenta nahlásiť rozbitý rozsah pri najbližšej obnove. Patrí sem aj jedna výhrada k poradiu: HotXLS emituje AutoFilter rozsahy ako <table:database-ranges> za pivot fragmentom, a corpus vzorka žiadny database range nemá, takže workbook s filtrom aj pivotom by mal prejsť cez ODF schema validátor, kým sa spoľahnete na relatívne poradie tých dvoch elementov
Testujte na súboroch svojho vlastného producenta, nielen na corpus vzorke. Prenos namespacov zvládne akýkoľvek prefix, ktorý producent deklaruje na predkovi, ale dokument, ktorý deklaruje prefix priamo na pivot elemente, alebo ktorý používa default namespace pre table slovník, precvičí vetvy preskočenia a shadowingu, ktoré vzorka z LibreOffice nepokrýva. Obe sú implementované; ani jedna zatiaľ nemá v corpuse vzorku, a ten rozdiel je presne ten typ veci, ktorý changelog zvyčajne rozmaže
Doslovné zachytenie data pilotov vo v2.382.0 a oprava namespace scope vo v2.382.1 sú v aktuálnom HotXLS Delphi Excel Component, ktorého produktová stránka uvádza plné čítanie a zápis ODS, XLSX a XLS pre Delphi a C++Builder