Keď HotPDF Delphi Component načíta súbor PDF 1.5 cez LoadFromFile, neparsuje objekty zabalené v kontajneroch /Type /ObjStm. Len si poznamená, kde ktorý komprimovaný člen žije, a naparsuje ho, až keď si ho niečo vyžiada. Práve táto lazy invariant drží čas načítania úmerný tomu, čoho sa naozaj dotknete, a je aj dôvodom, prečo musí úplný prepis pred vypustením akýchkoľvek bajtov spraviť jednu prácu navyše: expandovať každého člena, ktorý je ešte neparsovaný, pretože prepis sa chystá zahodiť kontajnery, v ktorých tí členovia žijú
Príznak, ktorý viedol k tejto poznámke, sa ľahko opisuje a nepríjemne ladí. Načítajte súbor, ktorého fonty, farebné priestory a structure tree sedia v object streamoch, prežeňte ho dvojicou generovania BeginDoc a EndDoc a výstup sa otvorí bez sťažností. Počet strán je správny, text je viditeľný na stránkach, ktoré namátkou skontrolujete. Potom kolega otvorí stranu 40 a telový text sa vykreslí so substituovaným fontom, alebo príkaz Extract Text vráti odpad tam, kde bývala náhrada ActualText. Nič nespadlo. Writer jednoducho serializoval objekt, ktorý nikdy nebol načítaný, a nenačítaný objekt sa serializuje ako nič
Čo LoadFromFile vlastne drží pre komprimovaný objekt?
Pre každý cross-reference záznam typu 2 si LoadFromFile drží malý záznam v FCompactObjects: číslo objektu, index obsahujúceho streamu v tabuľke kontajnerov, pozíciu člena vnútri toho streamu a pointer ParsedObject, ktorý začína ako nil. Samotný kontajner sa lokalizuje, dešifruje, ak je dokument šifrovaný, a inflatuje, ale telá členov zostávajú ako bajty. ISO 32000-1 §7.5.7 definuje rozloženie kontajnera, ktoré to umožňuje: hlavička dvojíc číslo objektu a offset a za /First zreťazené telá členov, takže ktorýkoľvek jednotlivý člen sa dá vyrezať bez dotyku na svojich susedov
EnsureCompressedObjectLoaded je jediná cesta, ktorá zmení záznam na objekt. Nájde záznam podľa čísla objektu a ak je ParsedObject už nastavený, vráti ten cachovaný objekt a započíta cache hit. Inak znovu načíta kontajner, ak bol evictovaný, spočíta bajtový rozsah člena z offsetovej tabuľky, odovzdá parseru zero-copy view toho rezu a výsledok uloží späť do záznamu. Odvtedy je objekt nepriamy, nesie svoje skutočné číslo objektu a je zaregistrovaný v objektovom indexe dokumentu ako každý objekt naparsovaný z tela súboru. Katalóg, info slovník, koreň page tree a objekty stránok prechádzajú touto cestou už pri načítaní, pretože ich navigácia potrebuje. Fonty, farebné priestory, slovníky ExtGState a structure elementy nie, a zostávajú ako záznamy, dokým sa ich nedotkne vykreslenie stránky alebo prepis
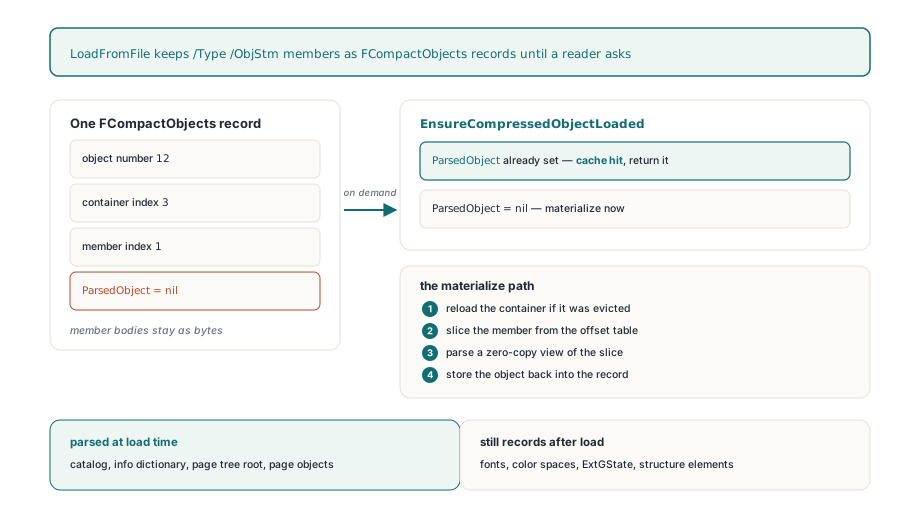
Môžete to sledovať zvonku. GetLoadedObjectStreamCacheInfo hlási, koľko kontajnerov existuje, koľko členov bolo indexovaných a koľko z nich je zatiaľ naparsovaných:
var
  Pdf: THotPDF;
  Info: THPDFObjectStreamCacheInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('tagged-report.pdf');
    if Pdf.GetLoadedObjectStreamCacheInfo(Info) then
      Writeln(Format('%d containers, %d members indexed, %d parsed so far',
        [Info.ContainerCount, Info.IndexedObjectCount,
         Info.MaterializedObjectCount]));
  finally
    Pdf.Free;
  end;
end;
Na súbore s ťažkou štruktúrou je to tretie číslo hneď po načítaní malý zlomok toho druhého. Práve tá medzera je celá pointa lazy načítavania a je to zároveň presne tá množina objektov, po ktorú sa úplný prepis musí vrátiť
Prečo úplný prepis zahodí fonty, ktoré inkrementálne uloženie zachová?
Úplný prepis zahodí kontajnery /ObjStm a /XRef zdrojového súboru a objektový graf serializuje odznova, takže každý člen, ktorého ParsedObject je ešte nil, nemá vo výstupe žiadnu reprezentáciu. Inkrementálna aktualizácia tento problém nikdy nemá, pretože pripája nové objekty za pôvodné bajty a staré kontajnery necháva na mieste pre predchádzajúcu cross-reference sekciu. Rozdiel nie je v tom, ako tie dva režimy zaobchádzajú s fontmi. Je v tom, či pôvodné kontajnery prežijú, aby si ich prečítal nasledujúci viewer
Oprava žije v SaveToStream, teda v serializéri, ktorý EndDoc riadi, či nastavíte FileName alebo OutputStream. Než sa rozdelí do ktorejkoľvek vetvy writera, prejde FCompactObjects a na každom zázname zavolá EnsureCompressedObjectLoaded. Ak sa člen nedá načítať, uloženie vyhodí výnimku namiesto pokračovania, pretože prepis, ktorý potichu zahodí slovník fontu, je horší než ten, ktorý sa zastaví. Expanzia musí sedieť na tejto úrovni, nad vetvami classic, packed a linearized, a nad prerezávaním znovu načítaných štrukturálnych streamov, ktoré robí linearized cesta. Staršia verzia expandovala členov len vo vnútri SaveLoadedDocument, čím pokrývala slovník načítaného dokumentu a slovník generovania minula úplne. LoadFromFile nasledované BeginDoc, úpravami stránok a EndDoc šlo priamo do writera so všetkými nedotknutými členmi stále neparsovanými
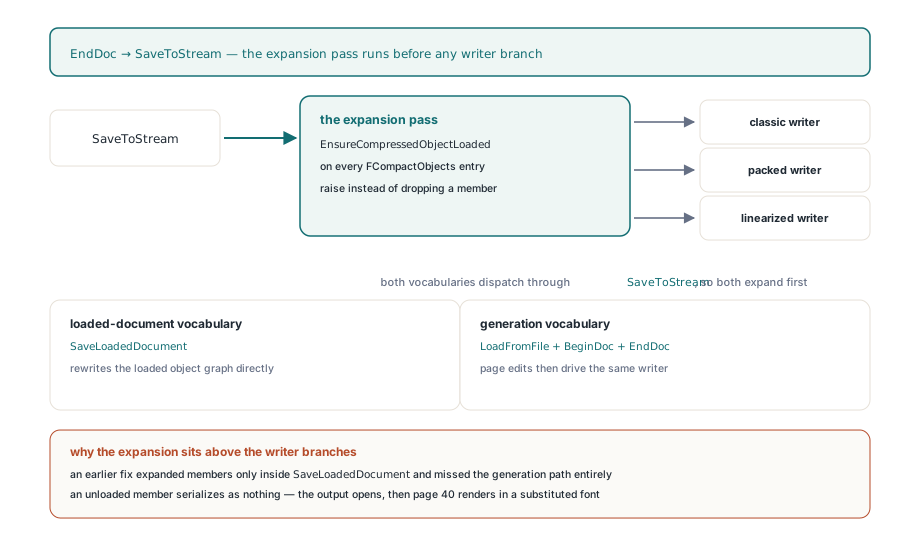
// Oba slovníky prepisu teraz expandujú compact členov pred behom writera.
// Cesta načítaného dokumentu:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.SaveLoadedDocument('quarterly-rewritten.pdf');

// Cesta generovania nad načítaným súborom:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.FileName := 'quarterly-stamped.pdf';
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('Arial', [], 9);
Pdf.CurrentPage.TextOut(40, 20, 0, 'Reviewed 2026-09-11');
Pdf.EndDoc;   // SaveToStream najprv materializuje každý záznam FCompactObjects
Cachovaní členovia si držia to, čo ste s nimi urobili. Objekt, ktorý bol naparsovaný, upravený a označený ako dirty pred uložením, sa z cache vráti so svojimi úpravami, a člen, ktorý ste zmazali, si svoj stav zmazania drží naprieč opakovanými uloženiami. Expanzný prechod je idempotentný už zo svojej konštrukcie: vždy zaplní len nil sloty
Prečo pixelové kontroly na troch stránkach minú prípad ActualText
Structure elementy sú miesto, kde sa táto chyba skrýva najdlhšie. Záznam ActualText na marked-content sekvencii, definovaný v ISO 32000-1 §14.9.4, nahrádza glyfy pre extrakciu a prístupnosť, ale vykreslenie neovplyvňuje. Ak structure element žije v object streame a prepis ho stratí, stránka sa stále kreslí správne, prvá, prostredná aj posledná stránka sa porovnajú pixel po pixeli so zdrojom a regresia sa ukáže až vtedy, keď niekto spustí extrakciu textu alebo čítačku obrazovky. Test prepisu, ktorý len vykresľuje stránky, nie je testom prepisu pre tagované PDF. Porovnajte aj extrahovaný text a structure tree
Ako prázdne používateľské heslo zmení načítanie?
Prázdne používateľské heslo stále znamená, že súbor je šifrovaný, a object streamy v takom súbore sú ciphertext, dokým sa nezíska file key. ISO 32000-1 §7.6.3.4 Algorithm 2 odvodzuje ten kľúč z hesla, záznamu /O, /P a prvého identifikátora dokumentu, a HotPDF ho musí spustiť proti prázdnemu reťazcu, aby type-2 prechod mohol inflatovať čo i len jeden kontajner. Preto BeginDoc na načítanom šifrovanom dokumente volá DecryptLoadedDocument s prázdnym heslom pred čímkoľvek iným: objektový graf musí byť autentifikovaný a dešifrovaný skôr, než môže začať prepis, bez ohľadu na to, či volajúci zamýšľa výstup chrániť. Šifrovanie výstupu je samostatné rozhodnutie, riadené nastaveniami ochrany od volajúceho, a BeginDoc tie nastavenia po dešifrovacom prechode obnoví, aby sa šifrovaný vstup potichu nezmenil na šifrovaný výstup
Politika kontajnerov sa číta zo slovníka /Encrypt skôr, než sa skúsi akékoľvek heslo. Pre /V 1 a 2 je každý stream šifrovaný file key-om. Pri crypt filtroch HotPDF rozkladá /StmF cez /CF: filter Identity alebo /CFM s hodnotou None znamená plaintextové kontajnery, kým V2 a AESV2 znamenajú šifrované. Odpoveď pristane v FReloadObjectStreamsEncrypted a je dôležitá pre jeden konkrétny prípad. Keď sú kontajnery plaintextové, ale reťazce nie, členovia nesú šifrované reťazce, ktoré treba dešifrovať jednotlivo, takže MaterializeMembersOfPlaintextObjectStreams expanduje každého compact člena pred dešifrovacím prechodom po objektoch. Nerobí nič, keď politika ešte nie je známa, a nič, keď boli šifrované samotné kontajnery, pretože členovia šifrovaného kontajnera boli dešifrovaní už s ním a nikdy sa nesmú dešifrovať dvakrát
Čo sa stane, keď kontajner nemožno dešifrovať?
Kontajner, ktorý neprejde dešifrovaním, ide do karantény, nie je fatálny. Type-2 prechod zapíše záznam THPDFObjStmQuarantineInfo do FObjStmQuarantine s číslom objektu kontajnera, dôvodom THPDFObjStmQuarantineReason, diagnostickým reťazcom a zoznamom čísel objektov členov, ktoré doň cross-reference nasmeroval. osqrDecryptFailed sa vyhodí v štyroch odlišných situáciách: nedal sa rozložiť žiadny crypt filter, hodilo výnimku dešifrovanie AES-256 alebo AES-GCM, hodilo výnimku legacy dešifrovanie RC4 alebo AES-128, alebo neexistuje žiadny použiteľný file key. Nezávislé kontajnery sa načítavajú ďalej, takže dokument s jedným poškodeným kontajnerom sa stále otvorí a stále vykreslí každú stránku, ktorá na ňom nezávisí
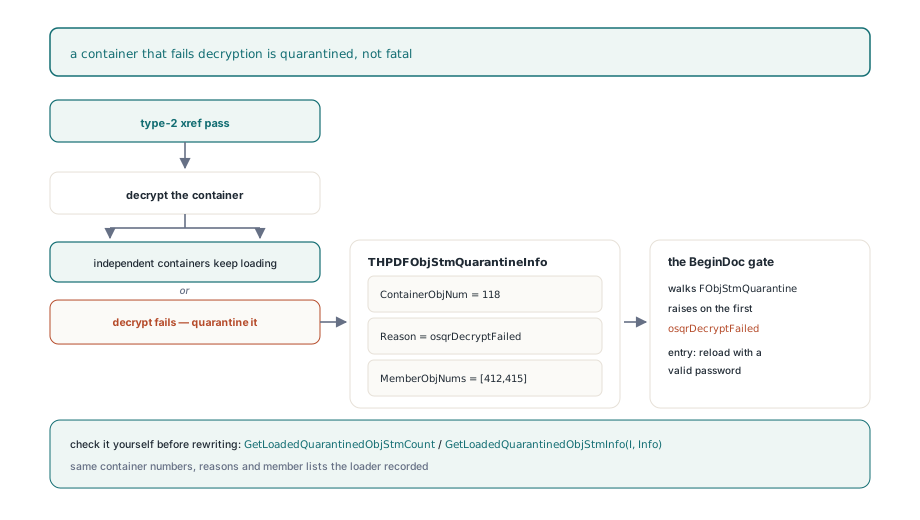
Zoznam karantény prežije fallback parsera. Ak primárne načítanie cross-reference zlyhá a HotPDF rekonštruuje tabuľku objektov skenovaním súboru, šifrovací príznak z prvého pokusu tú rekonštrukciu nemusí prežiť, ale záznamy karantény áno. Preto BeginDoc kontroluje zoznam karantény a nie šifrovací príznak: na načítanom dokumente prejde FObjStmQuarantine a vyhodí výnimku pri prvom zázname osqrDecryptFailed, menuje kontajner a žiada znovunačítanie s platným heslom. Prepis, ktorý by za tým bodom pokračoval, by členov, ktoré mal kontajner držať, zapísal ako prázdne objekty a nahlásil úspech. Tú istú kontrolu si môžete spustiť sami, skôr a s vlastnou politikou, cez verejné accessory:
var
  Info: THPDFObjStmQuarantineInfo;
  I: Integer;
begin
  Pdf.LoadFromFile('vendor-form.pdf');   // prázdne používateľské heslo
  for I := 0 to Pdf.GetLoadedQuarantinedObjStmCount - 1 do
    if Pdf.GetLoadedQuarantinedObjStmInfo(I, Info) and
       (Info.Reason = osqrDecryptFailed) then
      raise Exception.CreateFmt(
        'Object stream %d is unreadable (%s); %d members unresolved',
        [Info.ContainerObjNum, String(Info.Diagnostic),
         Length(Info.MemberObjNums)]);
  // odtiaľto je prepis bezpečný
end;
Ostatné dôvody karantény pokrývajú nekryptografické zlyhania: kontajner, ktorý nie je stream, chýbajúci slovník, neplatné /N alebo /First, veľkosť streamu mimo akceptovaného rozsahu, zlyhanie dekompresie, /First ukazujúce za dáta alebo telo člena, ktoré sa dekódovalo, ale nenaparsovalo. Tie stoja za logovanie pri ingestii, keďže každý z nich menuje presne tých členov, ktorí vám budú po prúde chýbať
Prečo prepis potrebuje pôvodný číselný token?
HotPDF ukladá každý číselný objekt ako Single a Single nevie reprodukovať zdrojový text reálneho čísla. ISO 32000-1 §7.3.3 dovoľuje writeru zapísať pre tú istú hodnotu 0.750000, .75 alebo 0.75, a žiadny z tých tvarov neprežije round trip cez 24-bitovú binárku a generický formátovač nezmenený. Horšie, hodnota ako 0.7 nie je v Single reprezentovateľná vôbec; naparsuje sa na najbližší float a preformátovanie toho floatu môže vyprodukovať 0.69999999 alebo zaokrúhleného suseda, podľa toho, ako beží číslicová slučka. Pri fill farbe alebo konštante priehľadnosti /CA je to rozdiel jedného kroku v 8-bitovom kanáli, čo stačí na to, aby porovnanie pixelov proti zdroju neprešlo a na hraniciach gradientu aby to bolo vidieť
THPDFNumericObject.RememberSourceToken to rieši pre neupravený prípad. Parser ho zavolá s raw tokenom hneď po priradení Value; metóda akceptuje len tokeny zložené z číslic, s nanajvýš jednou desatinnou bodkou a voliteľným vedúcim znamienkom, a token uloží spolu s hodnotou, ktorej zodpovedal, do FSourceValue. Vlastnosť SourceToken vráti uložený text len pokiaľ sa Value stále rovná FSourceValue. Zmeňte číslo a token sa vyparí, takže upravená hodnota vždy ide cez existujúcu formátovaciu cestu a nikdy nezapíše zastaraný text. SaveNumericObject skontroluje najprv SourceToken a ak je prítomný, zapíše ho doslovne, a do vetiev pre celé čísla, referencie na farebný priestor a zlomky spadne len pri číslach, ktoré vznikli alebo boli upravené v pamäti
Invariant je malý a stojí za to povedať ho priamo: číslo, ktorého ste sa nedotkli, sa zapíše tými bajtmi, s ktorými bolo prečítané, a číslo, ktorého ste sa dotkli, zapíše vlastný formátovač HotPDF. Compact členovia z toho profitujú rovnako ako objekty v tele súboru, keďže EnsureCompressedObjectLoaded spúšťa ten istý parser nad rezom člena. Samotné formátovanie čísel a jeho nezávislosť od locale procesu je pokrytá v článku o formátovaní PDF čísel nezávislom od locale v HotPDF
Testovanie cesty prepisu proti object streamom
Tri kontroly zachytia každé zlyhanie opísané vyššie a žiadna z nich nepotrebuje Acrobat. Po prvé, po uložení porovnajte IndexedObjectCount s MaterializedObjectCount; pri úplnom prepise sa musia rovnať a každá medzera je člen, ktorý vypadol. Po druhé, extrahujte text a vymenujte structure tree na oboch súboroch, nie ich len vykreslite, aby sa stratený ActualText alebo stratený structure element ukázal ako diff. Po tretie, načítajte výstup v novej inštancii a overte, že GetLoadedQuarantinedObjStmCount je nula, čo zároveň dokazuje, že writer nevyprodukoval kontajner, ktorý čítačka nevie otvoriť. Kombinácie crypt filtrov, ktoré rozhodujú o FReloadObjectStreamsEncrypted, sú rozložené v článku o politikách StmF, StrF a EFF. Strana writera tohto príbehu, teda ako emitovať object streamy a kedy dať prednosť inkrementálnej aktualizácii pred prepisom, je v návode na object streamy a inkrementálne aktualizácie
Lazy načítavanie členov, expanzný prechod pred writerom, karanténa dešifrovania aj zachovanie zdrojového tokenu sú súčasťou HotPDF Delphi Component pre Delphi a C++Builder. Produktová stránka odkazuje referenciu API, ak chcete GetLoadedObjectStreamCacheInfo a quarantine accessors vystopovať proti svojej vlastnej ingest pipeline