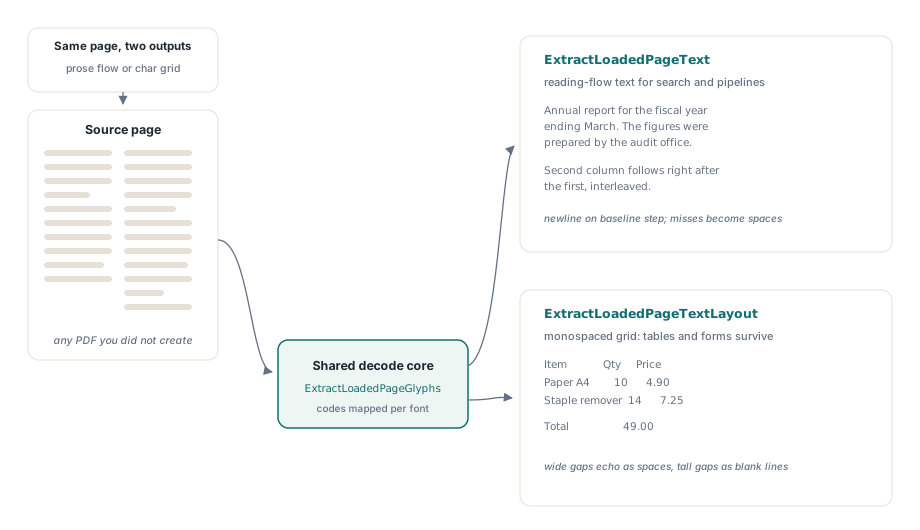
Komponent HotPDF Delphi Component extrahuje Unicode text z ľubovoľného PDF, ktoré v Delphi načítate, dvoma volaniami: ExtractLoadedPageText vracia text strany v poradí čítania a ExtractLoadedPageTextLayout (pridané vo v2.263.0) rekonštruuje vizuálne usporiadanie strany ako čistý text, takže stĺpce, odsadenia a zarovnanie tabuliek vo výstupe prežijú. Obe fungujú na dokumentoch, ktoré HotPDF nevytvoril, čo je práve ten prípad, na ktorom naozaj záleží: faktúra, ktorú vám poslal zákazník e-mailom, report doručený skenovacou agentúrou, zmluva vygenerovaná softvérom, ktorý už nikto nevie pomenovať
Dostať sa k tomu si vyžiadalo viac mechaniky, než tie dve signatúry naznačujú, pretože PDF neukladá text tak ako textový súbor. Tento článok prechádza oba režimy extrakcie a potom otvára kapotu nad troma súčasťami pod nimi — čítačkou CMap, interpreterom obsahových streamov a reťazou záložných dekódovaní písiem — pretože vedieť, ako mapovanie funguje, je rozdiel medzi pokrčením ramenami nad nezmyselným výstupom a jeho diagnostikou
Prečo je extrakcia textu ťažšia než vyčítanie reťazcov zo súboru?
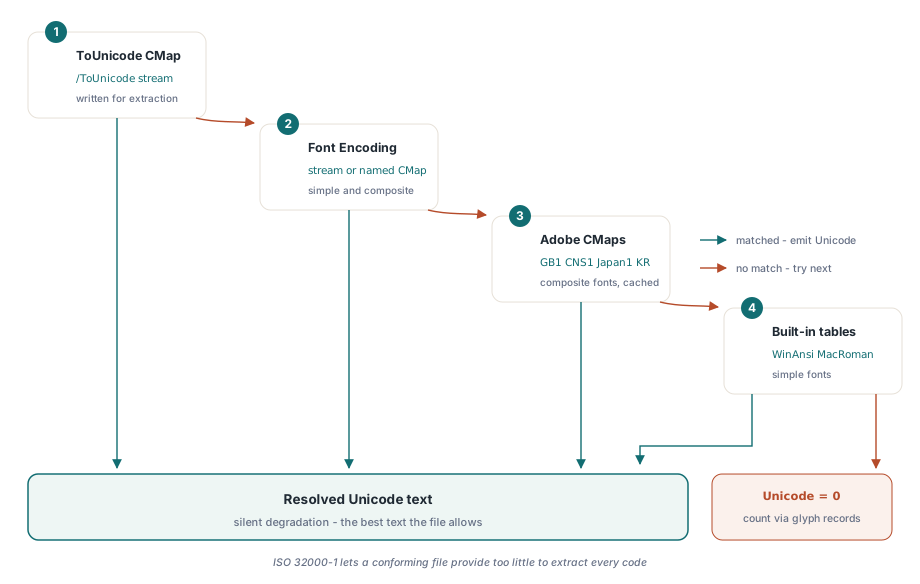
Obsahový stream v PDF zaznamenáva kódy znakov, nie znaky. Operátory Tj a TJ (ISO 32000-1 §9.4.3) nesú reťazce bajtov, ktorých význam úplne závisí od písma zvoleného predchádzajúcim Tf: bajt 0x41 môže byť písmeno A pod WinAnsi, ľubovoľný glyf v písme s podmnožinou alebo polovica dvojbajtového CID v zloženom písme pre CJK. Norma ISO 32000-1 §9.10 definuje extrakciu textu presne ako tento dekódovací problém — mapovanie každého kódu späť na Unicode pomocou akýchkoľvek informácií, ktoré slovník písma poskytne — a výslovne uvádza, že vyhovujúci súbor nemusí poskytnúť dosť informácií na to, aby sa to dalo urobiť
Práve táto posledná veta vysvetľuje každé hlásenie typu „prečo kopírovanie z tohto PDF vyprodukuje nezmysly“, aké ste kedy videli. Producent, ktorý vloží písmo s podmnožinou bez tabuľky /ToUnicode, napísal súbor, ktorý sa vykreslí dokonale a extrahuje ako nezmysel, pretože mapovanie kód na glyf existuje, no mapovanie kód na Unicode nebolo nikdy dodané. Každé úprimné extrakčné API je preto reťazou záložných stratégií podľa najlepšieho úsilia a užitočnou otázkou je, ako hlboko tá reťaz siaha
Extrakcia v poradí čítania cez ExtractLoadedPageText
Na indexovanie pre vyhľadávanie, hľadanie kľúčových slov alebo podávanie textu analytickej pipeline je ExtractLoadedPageText tým správnym volaním. Signatúra znie function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean — indexy strán sú počítané od nuly, výsledok prichádza ako natívny UnicodeString v Delphi a funkcia vráti False, keď strana nemá čitateľný obsahový stream, namiesto toho, aby vyhodila výnimku
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
    // AllText teraz drží text dokumentu v poradí čítania
  finally
    Pdf.Free;
  end;
end;
Zalomenia riadkov vo výstupe pochádzajú zo zámerne jednoduchého geometrického pravidla. Od HotPDF v2.766.79 sa nový riadok vloží vtedy, keď sa počiatok glyfu posunie v smere zápisu o viac než polovicu výšky textu, pričom za výšku sa berie väčšia z výšok boxov tohto a predchádzajúceho glyfu od ascendu po descent, v jednotkách strany. Pred týmto releaseom sa zvislý posun porovnával s polovicou veľkosti písma zadanou v Tf, ktorá býva v dokumentoch nastavujúcich veľkosť textu cez textovú maticu často 1, takže zvýšený horný index začal nový riadok a otočený text dal každý znak na vlastný riadok. Medzery medzi slovami nasledujú od v2.766.76 zodpovedajúce pravidlo: keď producent oddeľuje slová posunom textovej pozície — úpravou TJ alebo Td — namiesto zobrazenia znaku medzery, medzera sa pridá, keď voľný priestor po účiari za vlastnou šírkou predchádzajúceho glyfu presiahne 0,15 výšky boxu glyfu, a nikdy medzi dvoma čínskymi, japonskými alebo kórejskými znakmi. Znaky, ktoré dekodér nedokáže vyriešiť, sa namiesto zmiznutia stanú medzerami, takže hranice slov prežijú aj vtedy, keď jednotlivé glyfy nie. O čo sa tento režim nepokúša, je zoskupovanie do poradia čítania ani detekcia viacerých stĺpcov: dvojstĺpcová strana vyjde prekladaná v poradí obsahového streamu, čo býva, no nie vždy, poradie vizuálne
Kedy siahnuť radšej po extrakcii so zachovaním rozloženia?
ExtractLoadedPageTextLayout je správnym volaním vždy, keď pozícia nesie význam: tabuľky, formuláre, výpisy kódu, čokoľvek, čo chcete porovnávať cez diff, prehľadávať cez grep alebo parsovať po stĺpcoch. Namiesto splošťovania glyfov do prúdu ich zoskupí do účiar, každú účiaru zoradí podľa X a reprodukuje vodorovné aj zvislé biele miesta na mriežke znakov s neproporcionálnym písmom, ktorej rozmer vychádza z mediánového posunu glyfu a veľkosti písma. Zo širokých medzier medzi behmi na tej istej účiare sa stanú série medzier; z veľkých medzier medzi účiarami prázdne riadky. Výsledok sa číta tak, ako strana vyzerá
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Stĺpce, odsadenie a zarovnanie tabuliek prežijú ako
  // medzery a prázdne riadky na mriežke znakov
end;
Oba režimy zdieľajú každý bajt dekódovacej mechaniky a líšia sa len tým, ako dekódované glyfy usporiadajú, takže voľba nestojí nič na vernosti. Vyberte ExtractLoadedPageText, keď záleží len na slovách, a ExtractLoadedPageTextLayout, keď záleží na usporiadaní. Detekcia poradia čítania pri viacerých stĺpcoch zostáva mimo záberu oboch — mriežkové vykreslenie dvojstĺpcovej strany vám verne ukáže oba stĺpce vedľa seba, čo je pre porovnávanie presne správne a pre pretekanie prózy nie
Ako HotPDF dekóduje kódy znakov na Unicode?
Komponent HotPDF Delphi Component rieši každý kód znaku cez reťaz záložných stratégií zoradených podľa priority: najprv vložená CMap /ToUnicode daného písma, potom položka /Encoding (stream alebo pomenovaná CMap), ďalej — pri zložených písmach — štandardné súbory CMap od Adobe pre zbierky znakov ako Adobe-GB1, Adobe-CNS1, Adobe-Japan1 a Adobe-KR a napokon zabudované tabuľky WinAnsi a MacRoman pre jednoduché písma. Stratégia, ktorá nedokáže dodať odpoveď, ticho degraduje na nasledujúcu namiesto vyhodenia výnimky, a kód, ktorý vyčerpá celú reťaz, sa vyhodnotí na 0, takže volajúci môže neúspechy počítať namiesto hádania
CMap /ToUnicode (ISO 32000-1 §9.10.3) stojí prvá, pretože je to jediné mapovanie, ktoré producent napísal špeciálne na extrakciu. Cesta cez štandardné CMap od Adobe je dôležitá pri dokumentoch CJK, ktoré namiesto vkladania čohokoľvek používajú preddefinované CMap ako UniGB-UTF16-H: HotPDF dodáva súbory zbierok v adresári resources\CMap, počas behu ich hľadá relatívne k spustiteľnému súboru a každú rozparsovanú mapu si na proces uloží do cache — čo je dobré vedieť, pretože tá najväčšia z nich, mapa Adobe-GB1, má zhruba 2 MB zdrojového textu, ktorý nechcete parsovať znovu pri každej strane. Ak adresár chýba, dekodér CMap uložené na disku jednoducho preskočí a pracuje s vloženými tabuľkami plus zabudovanými kódovaniami. Toto je zrkadlom problému shapingu na strane čítania, ktorý pokrýva článok o shapingu textu v zložitých písmach pomocou HotPDF, kde sa to isté rozlíšenie medzi kódom a glyfom rieši pri zápise
Dve syntaktické pasce CMap, ktoré stojí za to poznať
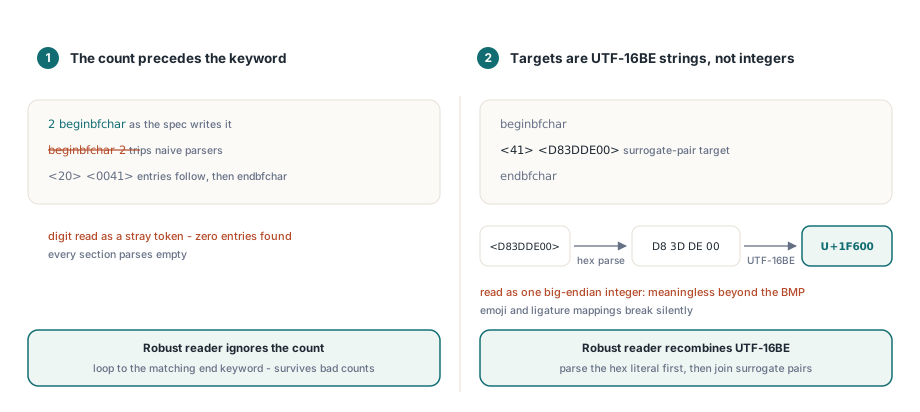
Súbory CMap vyzerajú triviálne parsovateľne a nie sú, pričom dva detaily majú na svedomí väčšinu zlyhaní parserov na prvý pokus. Prvým je, že počet záznamov stojí pred kľúčovým slovom sekcie: sekcia znie 2 beginbfchar, nie beginbfchar 2. Parser, ktorý očakáva počet za kľúčovým slovom, skonzumuje číslo ako zblúdilý token a potom v každej sekcii nájde nula položiek. Robustný prístup — ten, na ktorom sa ustálila čítačka v HotPDF — je počet úplne ignorovať a cyklovať až po zodpovedajúce kľúčové slovo endbfchar / endbfrange, čo má bonus v tolerancii voči reálnym súborom, ktorých počty sú jednoducho nesprávne
Druhou pascou je, že ciele v bfchar a bfrange sú reťazce UTF-16BE, nie celé čísla. Cieľ <D83DDE00> znamená U+1F600 — náhradný pár, ktorý treba znovu spojiť do jedného kódového bodu — a prečítanie týchto štyroch bajtov ako big-endian celého čísla dá nezmyselnú hodnotu pri každom kódovom bode mimo základnej viacjazyčnej roviny. Emoji v PDF už nie sú exotikou, takže dekodér, ktorý preskočí spájanie náhradných párov, zlyhá na súboroch, ktoré vaši používatelia naozaj majú. HotPDF najprv rozparsuje šestnástkový literál na surové bajty a potom spojí kódové jednotky UTF-16BE, čo zároveň pokrýva viacznakové ciele produkované mapovaním ligatúr
Zostup na úroveň glyfov cez ExtractLoadedPageGlyphs
Obe textové volania stoja na ExtractLoadedPageGlyphs a podkladové pole THPDFGlyphArray je dostupné aj vášmu kódu. Každý záznam THPDFGlyphRecord nesie vyriešený kódový bod Unicode popri surovom kóde znaku, bajtovú šírku tohto kódu (1, 2 alebo 4, určenú podľa codespacerange danej CMap), kľúč a veľkosť aktívneho zdroja písma, počiatok X a Y v používateľskom priestore a vodorovný posun; od v2.766.76 nesie navyše GlyphEndX a GlyphEndY — koniec vlastnej šírky glyfu v priestore strany bez medzier znaku a slova, od ktorého meria vyššie uvedené pravidlo medzier medzi slovami. To stačí na vybudovanie detekcie hraníc slov, pozičného zvýrazňovania alebo vlastného algoritmu rozloženia bez toho, aby ste sa sami dotkli obsahového streamu
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Počítanie záznamov s Unicode = 0, ako je uvedené vyššie, je úprimným spôsobom, ako zmerať kvalitu extrakcie na danom dokumente skôr, než textu ďalej v spracovaní uveríte. Záznamy glyfov navyše ukotvujú každý znak k zdrojovému operandu v obsahovom streame, čo je práve to, čo nad rovnakým základom umožňuje vyhľadávanie a nahradzovanie textu v načítaných dokumentoch v HotPDF
Ktoré PDF svoj text nevydajú?
Niektoré súbory porazia každý extraktor a je lepšie ich odhaliť než ich výstup posunúť ďalej. Naskenované dokumenty sú najjednoduchším prípadom: strana, ktorá je jedným veľkým obrázkom, neobsahuje vôbec žiadne textové operátory, takže extrakcia správne vráti prázdny reťazec — riešením je OCR a extrakcia obrázkov strany z načítaného PDF je prvým krokom tejto pipeline. Písma s podmnožinou bez tabuľky /ToUnicode sú ťažším prípadom: ak aj cesta cez /Encoding a štandardné CMap prídu naprázdno, tieto glyfy sa vyhodnotia na 0 a v textových volaniach sa objavia ako medzery. Šifrované dokumenty sa extrahujú normálne za predpokladu, že ich načítate s heslom cez preťaženú verziu LoadFromFile, takže streamy sú dešifrované ešte skôr, než ich interpreter uvidí
Jedno užšie obmedzenie stojí za otvorené pomenovanie: dekódovacia reťaz číta CMap a obsahové streamy cez cestu Flate v HotPDF, takže písmo, ktorého stream ToUnicode používa nezvyčajný filter, degraduje na nasledujúcu stratégiu namiesto toho, aby stranu zhodilo. V praxi FlateDecode pokrýva takmer všetko vyprodukované za posledné dve desaťročia a degradácia je tichá zámerne — dostanete najlepší text, aký súbor dovolí, nie výnimku. Tá istá objektová mechanika na strane čítania, ktorá tu rieši slovníky písiem, poháňa aj úpravu metadát na načítaných dokumentoch, takže vstupná pipeline dokumentov môže extrahovať, kontrolovať a anotovať v jednom prechode
Extrakcia textu, vykresľovanie so zachovaním rozloženia, prístup na úrovni glyfov aj funkcie vyhľadávania a nahradzovania nad nimi postavené sú všetko súčasťou štandardného komponentu HotPDF Delphi Component pre Delphi a C++Builder — žiadne externé DLL, žiadne textové služby operačného systému, len Object Pascal, ktorým môžete krokovať, keď vám do fronty pristane zvláštny súbor