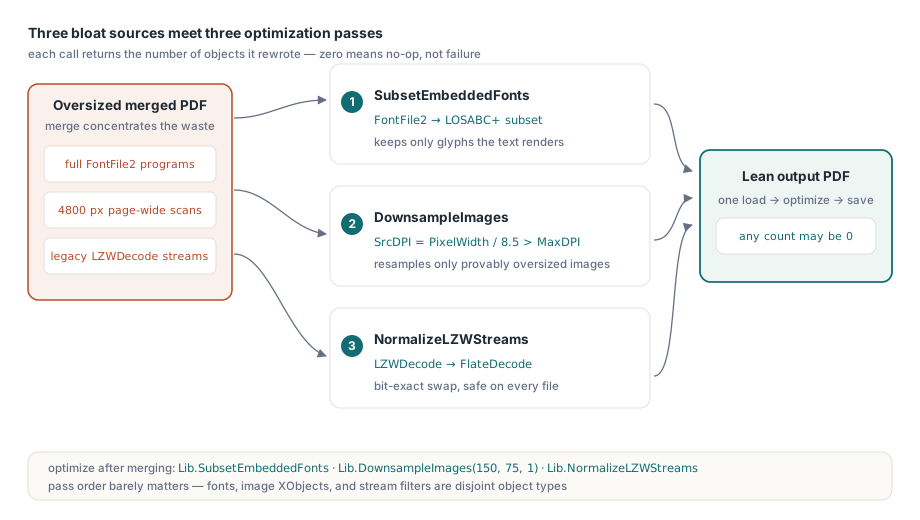
Na zmenšenie veľkosti súboru PDF v Delphi ponúka knižnica losLab PDF Library tri API, ktoré útočia na tri najväčšie zdroje nafúknutia: SubsetEmbeddedFonts prepíše každý vložený program písma TrueType tak, aby obsahoval len glyfy, ktoré dokument skutočne vykresľuje, DownsampleImages prevzorkuje rastrové obrázky presahujúce cieľové DPI a NormalizeLZWStreams nahradí staršiu kompresiu LZWDecode filtrom FlateDecode. Každá z nich vracia počet objektov, ktoré zmenila, takže nula vám povie, že prechod nič neurobil, a nie že ticho zlyhal
Prečo je moje zlúčené PDF väčšie než jeho zdrojové súbory?
Zlúčené alebo programovo vygenerované PDF býva predimenzované z jedného z troch dôvodov: úplne vložené písma, obrázky navzorkované ďaleko nad ich zobrazovacie rozlíšenie a streamy stále komprimované starším filtrom LZW. Norma ISO 32000-1 §9.9 dovoľuje producentovi vložiť kompletný program písma a väčšina producentov presne to aj robí, pretože je to bezpečná predvoľba. Kompletné FontFile2 pre Arial má stovky kilobajtov; vložte ho do tucta zdrojových súborov, zlúčte ich a nesiete tucet kópií obrysov glyfov pre znaky, ktoré nikto nenapísal. Samotné zlučovanie tento odpad nevytvára, len ho skoncentruje do jediného súboru, kde sa jeho celkový objem konečne stane viditeľným
Obrázky sú druhým previnilcom. Sken so šírkou 4800 pixelov umiestnený do rámu na štvrtinu strany prináša zhruba 40-krát viac obrazových dát, než dokáže tlačová pipeline s 300 DPI využiť. Tretí dôvod je tichší: streamy filtrované cez LZWDecode. Norma ISO 32000-1 §7.4.4 špecifikuje LZWDecode aj FlateDecode a poznamenáva, že Flate zvyčajne komprimuje aspoň rovnako dobre; v praxi je výstup Flate na tých istých dátach sústavne menší a LZW prežíva najmä v súboroch, ktoré niekedy vo svojej histórii prešli nástrojmi z deväťdesiatych rokov. Zvyšok tohto článku prechádza tri optimalizačné prechody knižnice losLab PDF Library, ktoré riešia jednotlivé problémy, a napokon ich spája do jednej pipeline
Podmnožiny písiem cez SubsetEmbeddedFonts
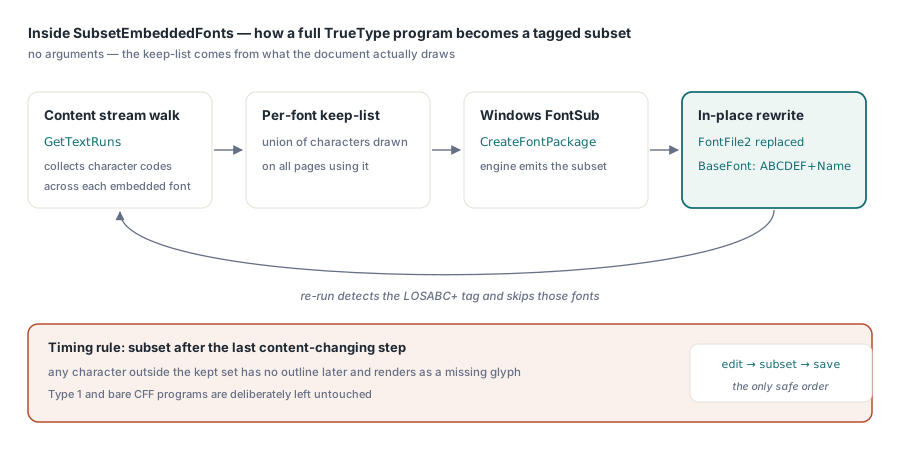
SubsetEmbeddedFonts zmenší každé vložené písmo TrueType v načítanom dokumente na znaky, ktoré dokument skutočne používa, a nepotrebuje žiadne argumenty, pretože zoznam ponechaných znakov odvodí priamo z obsahových streamov. Vnútri prechod prejde obsahový stream každej strany pomocou GetTextRuns, pozbiera kódy znakov použité pod jednotlivými zdrojmi písiem, zostaví zoznam ponechaných glyfov a odovzdá pôvodný program písma engine FontSub systému Windows (CreateFontPackage), ktorý vyrobí podmnožinu. Prepísaný program nahradí stream FontFile2 na mieste a názov v BaseFont dostane značku LOSABC+ podľa konvencie šiestich veľkých písmen a znaku plus, ktorú norma ISO 32000-1 §9.6.4 definuje pre písma s podmnožinou. Práve tento prefix robí volanie idempotentným: spustite prechod dvakrát a už spracované písma sa rozpoznajú a preskočia, takže je bezpečné zapojiť ho do dávkovej úlohy, ktorá sa k súborom môže vracať
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = počet prepísaných programov FontFile2;
      // 0 znamená nič vložené alebo všetko už v podmnožine
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Dva detaily implementácie stoja za poznanie, pretože vysvetľujú hranice tohto API. Po prvé, prechod cieli na FontFile2, takže pokrýva vložené programy TrueType; písma vložené ako Type 1 alebo holé CFF zostávajú nedotknuté namiesto toho, aby sa riskovalo ich prepísanie. Po druhé, prechod sa spolieha na FontSub, čo robí SubsetEmbeddedFonts dostupným len na Windows. Jemnejší bod z implementácie: či písmo pripadá do úvahy, sa rozhoduje skutočným vyhodnotením reťaze odkazov FontDescriptor → FontFile2, nie dôverou v heuristiku podľa príznaku vloženia, pretože písma v načítanom dokumente nikdy neprešli účtovníctvom na strane tvorby, ktoré takéto príznaky nastavuje. Ak vyhodnotený stream existuje, písmo je kandidátom; ak nie, preskočí sa bez chyby
Úprimný kompromis: písmo s podmnožinou obsahuje len glyfy prítomné v čase jej vytvorenia. Ak nadväzujúci nástroj alebo váš vlastný kód neskôr pridá text v tom istom písme, ktorýkoľvek znak mimo podmnožiny nemá obrys a vykreslí sa ako chýbajúci glyf. Podmnožinu vytvárajte ako posledný krok meniaci obsah, nikdy nie pred fázou úprav. Rovnaká opatrnosť platí, ak plánujete písmo neskôr vytiahnuť späť na opätovné použitie; článok o extrakcii textu, obrázkov a písiem pomocou PDF Library for Delphi rozoberá, čo vám extrahovaný program s podmnožinou dať môže a čo nie
Ako DownsampleImages rozhodne, ktoré obrázky zmenšiť?
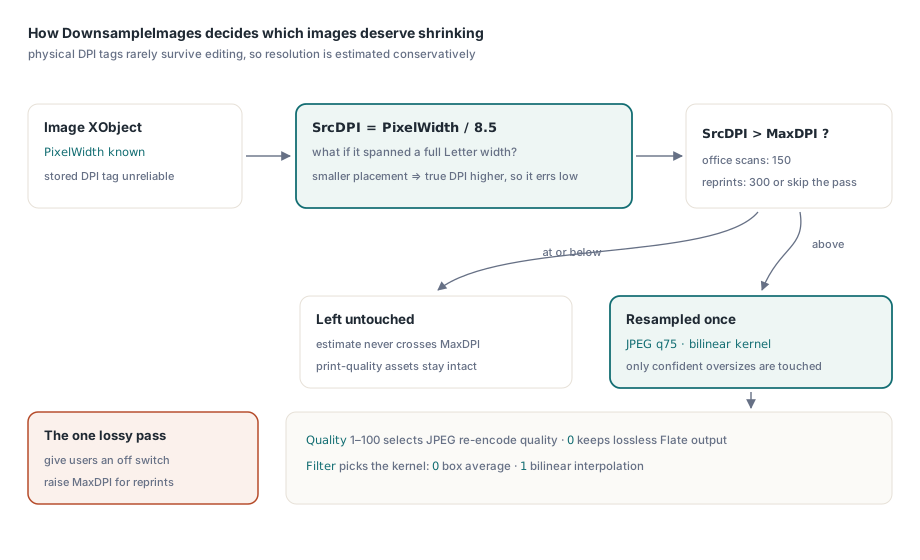
DownsampleImages(MaxDPI, Quality, Filter) prevzorkuje len tie obrázky, ktoré vie s istotou označiť za prevzorkované nad rámec potreby, pričom používa zámerne konzervatívny odhad DPI. Obrazový XObject v PDF ukladá rozmery v pixeloch, ale žiadne dôveryhodné fyzické rozlíšenie a značka DPI zo zdrojového obrázka len zriedka prežije cyklus načítania, úpravy a uloženia. Prechod preto odhaduje SrcDPI = PixelWidth / 8.5, čím sa v podstate pýta: keby tento obrázok pokrýval celú šírku strany formátu Letter, aké by mal rozlíšenie? Dotknuté sú len obrázky, ktorých odhad presiahne MaxDPI. Toto skreslenie je úmyselné: obrázok umiestnený na strane v malom má skutočné DPI vyššie než odhad, takže prechod skôr nezareaguje, než by znehodnotil podklad v tlačovej kvalite, ktorý nedokáže zmerať
Quality v rozsahu 1 až 100 volí kvalitu opätovného kódovania do JPEG, kým hodnota 0 ponechá výstup ako bezstratový Flate v štýle PNG; Filter vyberá prevzorkovacie jadro, 0 pre priemerovanie box a 1 pre bilineárne. Pre naskenované kancelárske papiere je DownsampleImages(150, 75, 1) rozumným východiskom; pri čomkoľvek, čo sa môže znova tlačiť, zdvihnite MaxDPI na 300 alebo prechod úplne vynechajte. Zníženie rozlíšenia je jediným stratovým krokom z tejto trojice, takže patrí za nastavenie, ktoré si vaši používatelia môžu vypnúť
Konverzia starých LZW streamov cez NormalizeLZWStreams
NormalizeLZWStreams je výhra zadarmo: bezstratovo dekomprimuje každý stream LZWDecode, znovu ho skomprimuje filtrom FlateDecode priamo na mieste a vráti počet prevedených streamov. Zvláda tak samostatnú položku /Filter /LZWDecode, ako aj LZW vyskytujúci sa vnútri poľa s reťazou filtrov, kde sa nahradí iba článok LZW a zvyšok reťaze zostane zachovaný. Parametre prediktora (Predictor, Columns, Colors, BitsPerComponent) sa čítajú z DecodeParms streamu a posúvajú sa do dekompresora, takže obrazové dáta kódované prediktorom prejdú cyklom správne. Keďže oba filtre sú bitovo presné kodeky, dekódované bajty sú pred aj po zásahu identické; mení sa iba kompresia kontajnera, a práve preto je bezpečné spúšťať tento prechod na každom súbore bez podmienok
Pri dokumente bez LZW streamov volanie jednoducho vráti 0 a ničoho sa nedotkne, čo regresná sada knižnice výslovne overuje: čerstvo vytvorený súbor len s filtrom Flate musí hlásiť nula konverzií. Táto záruka nulového zásahu je dôležitá, keď prechod sedí v pipeline spracúvajúcej tisíce heterogénnych súborov, niektoré z roku 2024 a niektoré z roku 1998
Kompletná pipeline na optimalizáciu veľkosti v Delphi
Tri prechody sa spájajú do jedinej funkcie načítať-optimalizovať-uložiť a na poradí záleží menej, než by ste čakali, pretože pracujú s disjunktnými typmi objektov: písmami, obrazovými XObjektmi a filtrami streamov. Spustiť podmnožinovanie ako prvé je aj tak úhľadnejšia voľba, keďže ide o prechod s obmedzením na poradie úprav
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> podmnožina
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineárne
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Zaznamenajte Fonts/Images/Streams: tri nuly znamenajú, že súbor bol už štíhly
  finally
    Lib.Free;
  end;
end;
Pipeline si overte tak, ako sa overuje samotná knižnica: cyklom tam a späť. Regresné testy vo verzii v3.130 vytvoria dokument, uložia ho, znova načítajú, spustia optimalizáciu, opäť uložia a potom tvrdia tri veci: výstup je menší, vrátené počty zodpovedajú očakávaniam a opätovné načítanie optimalizovaného súboru sa stále rozparsuje a vykreslí. Zopakovať túto slučku vytvoriť-optimalizovať-znova načítať na vzorke vlastných produkčných súborov a porovnať extrahovaný text pred a po je hodinová investícia, ktorá odhalí integračné chyby dávno predtým, než zákazník otvorí pokazenú faktúru
// Kontrola cyklu: optimalizovaný súbor sa musí stále načítať bez problémov
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Kam táto pipeline zapadá v pracovnom postupe zlučovania? Za zlúčenie, nie doň. Zlúčiť najprv a optimalizovať jediný výsledok znamená, že podmnožina každého vloženého písma sa vytvorí raz voči zjednoteniu všetkých použitých znakov namiesto zvlášť pre každý zdrojový súbor. Ak je úzkym miestom priepustnosť zlučovania, PDF Library for Delphi ponúka rýchlu cestu na úrovni bajtov, ktorá sa vyhýba plnému parsovaniu objektov a je opísaná v článku o rýchlom zlučovaní PDF s posúvaním bajtových odkazov; a pre vstupy, ktoré sa celé do pamäte nezmestia, pokrýva streamovanú cestu článok o zlučovaní a delení veľkých PDF s priamym prístupom. Obe sa prirodzene dopĺňajú so záverečným optimalizačným prechodom nad zlúčeným výstupom
Čo tieto tri prechody neurobia
Optimalizačná trojica knižnice losLab PDF Library zámerne vynecháva všetko, čo mení sémantiku dokumentu. SubsetEmbeddedFonts nezjednotí duplicitné písma z rôznych zlúčených zdrojov do jediného programu, zmenšuje každé nezávisle; deduplikácia je iná a rizikovejšia transformácia. DownsampleImages obíde obrázok, ktorého konzervatívny odhad DPI zostane pod prahom, aj keď človek vidí, že je na svoj rám predimenzovaný. A žiadny z prechodov sa nedotýka štruktúry dokumentu, takže súbor nafúknutý tisíckami osirelých objektov potrebuje uloženie prepisom, nie tieto prechody na úrovni streamov. V rámci týchto hraníc kombinácia podmnožinovania písiem, znižovania rozlíšenia obrázkov a normalizácie LZW na Flate odstráni tri klasické zdroje nafúknutia PDF, každý jedným predvídateľným volaním API. Tieto tri funkcie sú súčasťou knižnice losLab PDF Library pre Delphi, C# a VB.NET, popri API na zlučovanie, extrakciu a vykresľovanie, o ktorých bola reč vyššie