PDF Library for Delphi zapisuje rozsahy page labels cez AddPageLabels a od v3.539.10 toto volanie funguje aj na načítaných súboroch, ktorých číselný strom /PageLabels je rozdelený do uzlov /Kids: koreň sa zarovná na jediný list /Nums, kým nový rozsah vstupuje dnu, takže štítok naozaj vyjde v prehliadači namiesto potichu ignorovania. Typická obeť je PDF v štýle knihy z layoutového nástroja, s rímskymi číslicami v predsade, arabským číslovaním v tele a prílohou štítkovanou A-1, A-2, kde ste chceli preštítkovať len prílohu a nič sa nezmenilo
Čo sú PDF page labels a ako sa ukladajú?
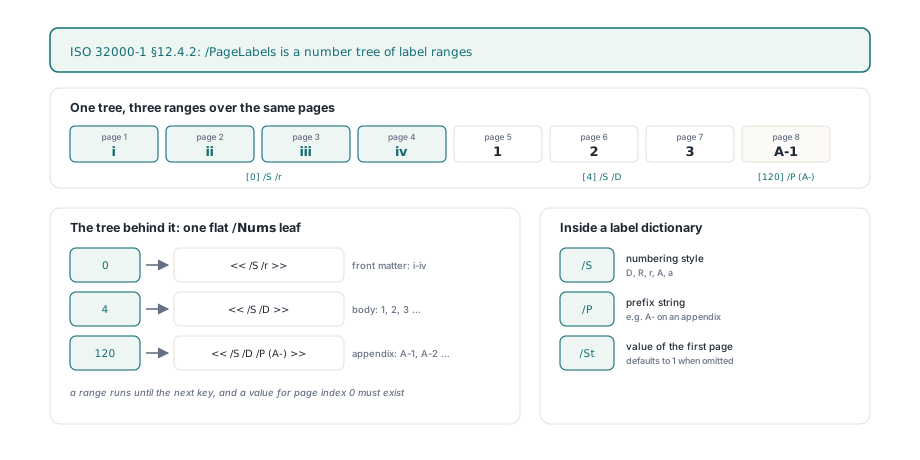
Page labels sú reťazce, ktoré prehliadač ukazuje vo svojom políčku strán namiesto fyzického indexu strany, a ISO 32000-1 §12.4.2 ich ukladá ako number tree pod kľúčom katalógu /PageLabels. Každý kľúč je index strany od nuly, ktorý začína štítkovací rozsah, a každá hodnota je slovník page label s najviac tromi položkami: /S pre štýl číslovania (D, R, r, A alebo a), /P pre prefixový reťazec a /St pre číselnú hodnotu prvej strany rozsahu, ktorá má predvolené 1. Rozsah beží do ďalšieho kľúča a špecifikácia vyžaduje, aby strom obsahoval hodnotu pre index strany 0, takže každá strana je pokrytá nejakým rozsahom
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('handbook.pdf', '') <> 1 then
      Exit;
    // Strany 1-4: i, ii, iii, iv (malé rímske)
    Lib.AddPageLabels(1, 3, 1, '');
    // Strany 5-120: 1, 2, 3 ... (desiatkové)
    Lib.AddPageLabels(5, 1, 1, '');
    // Strany 121 ďalej: A-1, A-2 ... (desiatkové s prefixom)
    Lib.AddPageLabels(121, 1, 1, 'A-');
    WriteLn(Lib.GetPageLabel(5));    // 1
    WriteLn(Lib.GetPageLabel(122));  // A-2
    Lib.SaveToFile('handbook-labeled.pdf');
  finally
    Lib.Free;
  end;
end;
TPDFlib.AddPageLabels(Start, Style, Offset, Prefix) mapuje svoje argumenty na ten slovník bez prekvapení, keď poznáte tri pravidlá. Start je číslovaný od 1 ako každý iný stránkový argument v knižnici a do stromu sa zapisuje ako Start - 1. Style beží od 0 do 5, kde 0 znamená len prefix a 1 až 5 sa stanú hodnotami /S D, R, r, A a a; čokoľvek mimo tohto rozsahu vráti 0 a ničoho sa nedotkne. Offset sa stane /St len vtedy, keď je väčší než nula, takže 0 jednoducho kľúč vynechá a prehliadač spadne na predvolenú 1. Keďže page labels prišli v PDF 1.3, volanie navyše spustí EnsureMinVersion('1.3', '/PageLabels'), ktoré zvýši výstupnú verziu staršieho súboru, pokiaľ ste si verziu ukladania výslovne nezamkli
Prečo nové page labels zmiznú, keď má strom /Kids?
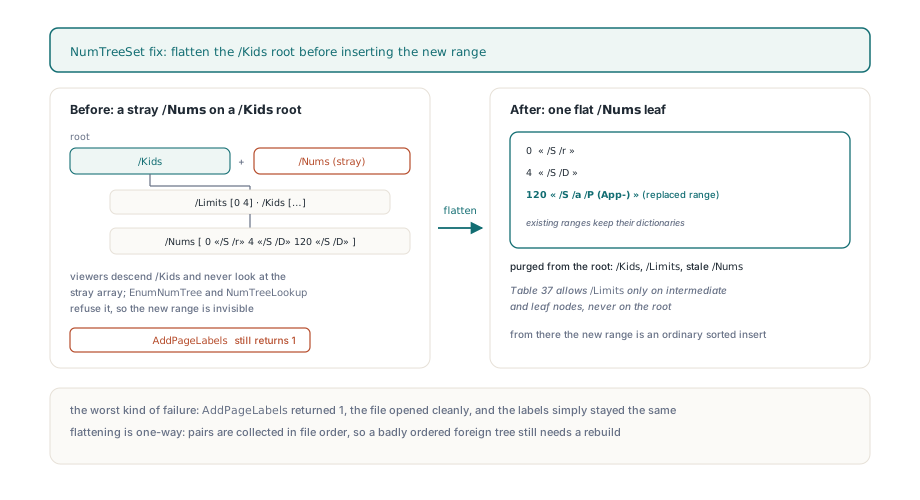
Nové štítky zmiznú preto, lebo ISO 32000-1 §7.9.7 (Table 37) núti koreň number tree niesť buď /Kids, alebo /Nums, nikdy nie oboje, a starší helper NumTreeSet vedel hľadať len /Nums. Producenti dlhých dokumentov často delia strom na medziuzly, každý s dvojicou /Limits, a zavesia ich na koreň, ktorý má len /Kids. Starý kód na tom koreni nenašiel žiadne /Nums, vytvoril čerstvé vedľa existujúcich /Kids a nový rozsah vložil tam. Výsledkom bol koreň s dvomi navzájom sa vylučujúcimi vstupmi. Prehliadače zostupujú cez /Kids a o blúdiacom poli sa nikdy nepozrú, vlastný EnumNumTree knižnice tiež kontroluje najprv /Kids a NumTreeLookup odmieta uzol, kde neplatí HasKids xor HasNums. AddPageLabels aj naďalej vrátil 1 a uložený súbor sa stále otvoril čisto, čo je najhorší druh zlyhania: nič si nesťažuje, štítky prosto zostávajú
Oprava v NumTreeSet premení koreň na list, skôr než čokoľvek vloží. Keď koreň nesie /Kids, EnumNumTree prejde každý list v poradí a posbiera všetky dvojice kľúč a hodnota, z tohto zoznamu sa postaví nové ploché pole /Nums a /Kids, /Limits aj prípadné zdedené /Nums sa z koreňa vyčistia skôr, než sa ploché pole pripojí. Zahodenie /Limits nie je kozmetika, Table 37 dovoľuje túto položku len na medziuzloch a listoch, nikdy na koreni. Odtiaľ je vloženie obyčajným triedeným insertom do jedného poľa a existujúce rozsahy prežijú so svojimi pôvodnými slovníkmi štítkov. Kompromis je zámerný: strom sa potom nestavia späť do vyvážených uzlov /Kids. Pre page labels to nestojí nič, lebo aj veľký referenčný manuál má zriedka viac než pár desiatok rozsahov a jediný list píše väčšina producentov aj tak
// Preštítkujte prílohu v súbore, ktorého koreň /PageLabels používa /Kids
if Lib.LoadFromFile('vendor-manual.pdf', '') = 1 then
begin
  WriteLn('Before: ', Lib.GetPageLabel(121));  // e.g. A-1
  // Nahraďte rozsah začínajúci na strane 121: App-a, App-b ...
  if Lib.AddPageLabels(121, 5, 1, 'App-') = 1 then
    Lib.SaveToFile('vendor-manual-relabeled.pdf');
  // Existujúce rímske a desiatkové rozsahy sú stále v zarovnanom liste
  WriteLn('After: ', Lib.GetPageLabel(121));   // App-a
  WriteLn('Front: ', Lib.GetPageLabel(2));     // ii, nezmenené
end;
Ako sa dá pole /Nums zle prečítať ako kľúče?
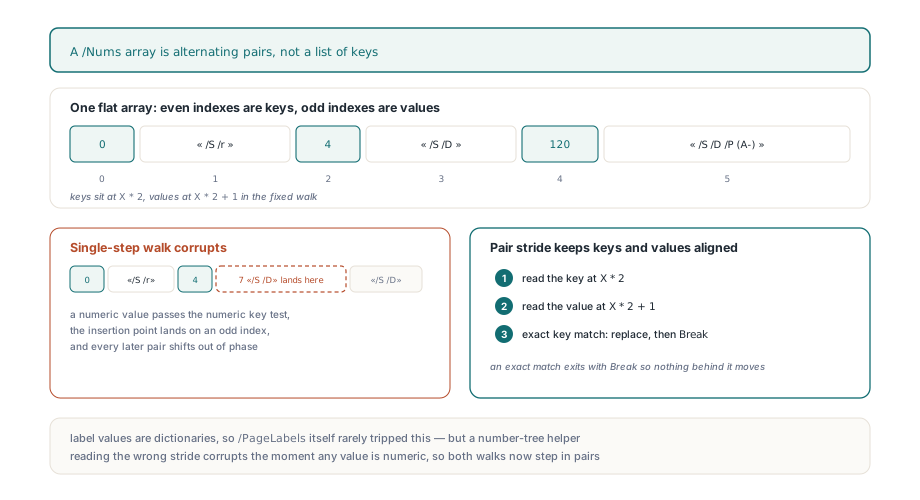
Pole /Nums sa prečíta zle vtedy, keď ho kód prechádza po jednom prvku, lebo pole je plochý beh striedavých dvojíc [key0 value0 key1 value1 ...] a kľúče sú len párne pozície. Stará slučka NumTreeSet testovala každý prvok na číselný typ, takže hodnota, ktorá sa náhodou stala číslom, sa porovnala, akoby bola kľúčom; zásah menší-než mohol nastaviť miesto vloženia na nepárny index a hodiť novú dvojicu do stredu existujúcej, pričom každú neskoršiu dvojicu vysunul z fázy. EnumNumTree mal ten istý jednokrokový prechod. Oba teraz iterujú dvojice s krokom dva, čítajú kľúč na X * 2 a hodnotu na X * 2 + 1 a presná zhoda kľúča nahradí hodnotu a skončí s Break. Spravodlivo treba povedať, že hodnoty page labels sú slovníky, takže tá druhá chyba sa na /PageLabels samotnom spúšťala zriedka, ale helper number tree čítajúci zlý krok je skorumpovaný v momente, keď je akákoľvek hodnota číselná, a opravilo sa to v tom istom ťahu
Čítanie štítkov späť a ich round trip
TPDFlib.GetPageLabel(Page) vracia štítok pre stranu číslovanú od 1 a má dva fallbacky, ktoré stoja za poznanie. Bez akejkoľvek položky /PageLabels vráti desiatkové číslo strany, takže volajúci ho môže použiť bezpodmienečne. So stromom prítomným, ale bez rozsahu pokrývajúceho stranu, vráti prázdny reťazec, čo sa presne deje, keď súbor vynechá povinnú položku indexu 0; referenčná dokumentácia hovorí, že na správne zobrazenie štítkov musí existovať rozsah začínajúci na strane 1, a kód túto požiadavku urobí viditeľnou. Písmenové štýly nasledujú špecifikáciu, nie tabuľkové stĺpce: po Z príde AA, potom BB, opakovanie písmena namiesto prenosu
var
  P: Integer;
  Data: WideString;
begin
  // Rýchly audit toho, čo prehliadač ukáže vo svojom políčku strán
  for P := 1 to Lib.PageCount do
    WriteLn(P, ' -> ', Lib.GetPageLabel(P));

  // Hodnota option 4 exportuje len rozsahy štítkov ako záznamy PageLabelBegin
  Data := Lib.ExportDocumentData(4);
  // Import ich prehrá cez ClearPageLabels + AddPageLabels
  Lib.ImportDocumentData(Data, 0);
end;
Pre hromadné úpravy ExportDocumentData s hodnotou option 4 zapíše každý rozsah ako blok PageLabelBegin s riadkami PageLabelNewIndex, PageLabelStart, PageLabelPrefix a PageLabelNumStyle a ImportDocumentData berie prvý nájdený záznam štítku ako plnú náhradu: raz zavolá ClearPageLabels a potom každý záznam podá AddPageLabels. Textový round trip je tým deterministický aj vtedy, keď pôvodný súbor používal strom /Kids, lebo čistenie odstráni celú položku katalógu a znovu postavený strom je od začiatku jediný list
Čo oprava stále negarantuje?
Zarovnanie je jednosmerné a verí poradiu, ktoré nájde. EnumNumTree zbiera dvojice v poradí súboru a GetPageLabel aplikuje posledný rozsah, ktorého kľúč je menší alebo rovný indexu strany, takže cudzí súbor s listami mimo poradia, ktoré §7.9.7 zakazuje, ale ktoré sa v prírode vyskytuje, môže stále dať zlé štítky, kým rozsahy znovu nestavíte cez ClearPageLabels a čerstvé volania AddPageLabels. Štítky sú tiež viazané na indexy strán, nie na objekty strán, takže každá operácia meniaca počet či poradie strán nechá rozsahy tam, kde boli. Výmena na mieste, ako náhrada strán so zachovaním čísel objektov, drží počet, a teda aj štítky v súlade, zatiaľ čo zlučovanie, ako usporadúvanie prepletených duplex skenov, vyrobí novú postupnosť strán, ktorá si zaslúži čerstvo zapísanú sadu rozsahov
Volania page labels, obsluha number tree a export a import dát dokumentu opísané tu všetky prichádzajú v PDF Library for Delphi pre Delphi, C++Builder aj Lazarus, pričom referenčná položka AddPageLabels dokumentuje hodnoty štýlov a návratové kódy