Поиск "two-x" в только что сгенерированном PDF может вернуть ноль попаданий, хотя страница совершенно ясно показывает эти пять символов. Выгрузите извлечённую строку как кодовые точки — и причина тут как тут: дефис вернулся как U+00AD SOFT HYPHEN, а стоящий после него пробел — как U+00A0 NO-BREAK SPACE. На экране они выглядят одинаково. Разница живёт в ToUnicode CMap — таблице, по которой читатель возвращает коды символов обратно в Unicode, — и возникает она из-за того, что один глиф шрифта делится между двумя кодовыми точками
Обычные строковые инструменты усугубляют несовпадение. Экспорт в CSV режет строку иначе, инструмент сравнения помечает две строки, читающиеся одинаково в каждом просмотрщике, а проверка правописания считает "two-x" с мягким переносом неизвестным словом. Нормализация Unicode спасает лишь наполовину: NFKC схлопывает U+00A0 в обычный пробел, потому что у NBSP есть декомпозиция совместимости, но у U+00AD декомпозиции нет вовсе, так что мягкий перенос переживает любую форму нормализации
Почему извлечённые пробелы возвращаются как U+00A0?
Извлечённые пробелы превращаются в U+00A0, когда ToUnicode CMap ключуется по глифу, а до одного глифа можно добраться с двух кодовых точек. В Arial глиф 3 обслуживает и U+0020, и U+00A0, а глиф дефиса — и U+002D, и U+00AD. CMap, построенный со стороны глифов, обязан что-то сказать о CID 0003, и генератор PDFium в FPDFText_LoadFont в итоге говорит две вещи: запись bfchar, отображающую его в U+0020, и bfrange в форме массива, отображающий тот же CID в U+00A0
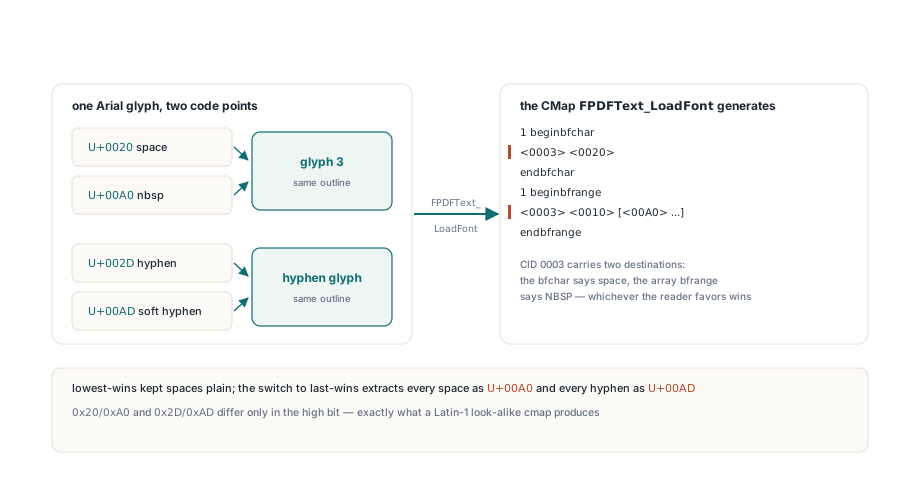
1 beginbfchar
<0003> <0020>
endbfchar
1 beginbfrange
<0003> <0010> [<00A0> ...]
endbfrange
ISO 32000-1 §9.10.3 описывает, как bfchar и bfrange отображают коды в Unicode, но не говорит, какая запись побеждает, когда две претендуют на один CID. Читатели выбирают правило приоритета сами. Читатель, хранящий младшее или первое отображение, извлечёт обычный пробел; читатель PDFium хранит последнее, и поскольку range-массив идёт после блока bfchar, каждый пробел, записанный через CMap с ключом по глифу, извлекается как NBSP, а каждый дефис — как мягкий перенос. Один и тот же текст поэтому может извлечься по-разному в двух просмотрщиках одного файла
Пары следуют шаблону. 0x20/0xA0 и 0x2D/0xAD отличаются только старшим битом — так шрифт поступает, когда его cmap отправляет Latin-1 двойников в контур, уже используемый для ASCII-символа. Греческая заглавная омега (U+03A9) и знак ома (U+2126) тоже делят глиф в Arial. Если код извлечения, который раньше проходил, теперь падает на невидимых символах, печатайте кодовые точки, а не доверяйте строковому виду отладчика; основы чтения текста со страницы — в статье об извлечении текста из PDF-документов с PDFium в Delphi
Как PDFium Component ключует системные шрифты по кодовой точке
PDFium Component ни за что не просит движок генерировать тот CMap для системных шрифтов, несущих Unicode cmap. Когда TPdf.AddText нужен шрифт, компонент читает собственную sfnt-таблицу cmap шрифта, предпочитая подтаблицу формата 12 и откатываясь к формату 4. Кодовые точки возвращаются отсортированными и дедуплицированными, и CID k+1 назначается k-й кодовой точке, при этом CID 0 оставлен как .notdef. Явный CIDToGIDMap отправляет каждый CID его глифу. U+0020 и U+00A0 поэтому получают два разных CID, рисующих один контур, а записываемый компонентом ToUnicode CMap отображает каждый CID ровно в одну кодовую точку
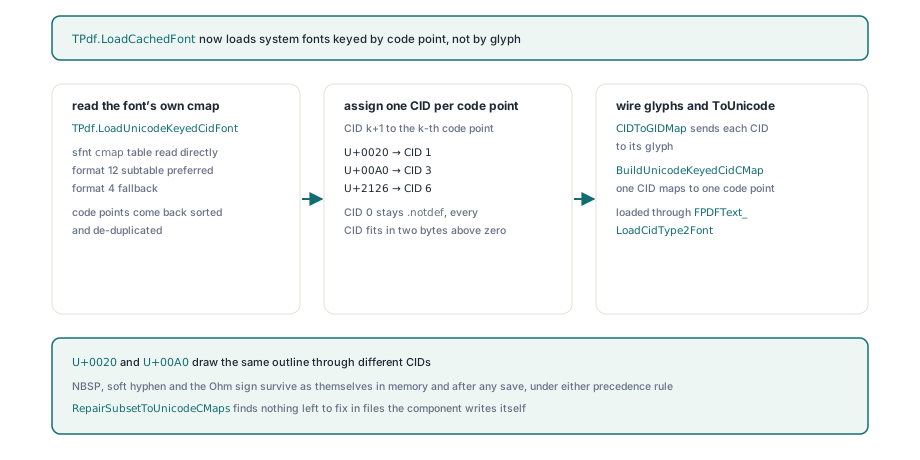
Шрифт загружается через FPDFText_LoadCidType2Font — ту же точку входа, что стоит за познаковой записью в статье о встраивании шрифтов CID Type 2 с явными CID-to-GID-картами. Когда FPDFText_SetText позже пишет строку, обратный поиск попадает в один CID на символ. Здесь ничто не зависит от правила приоритета читателя: второго отображения, между которым правилу пришлось бы выбирать, просто нет. Сохранённый файл несёт и собственный ToUnicode-поток компонента, поэтому извлечение после перезагрузки видит ту же таблицу «один к одному», что использовал живой документ
Цена — выросший CIDToGIDMap: два байта на каждую кодовую точку, которую покрывает шрифт. Положим, шрифт отображает около 3000 кодовых точек. Карта тогда выходит примерно на 6 КБ и отдаётся движку с каждым шрифтом. Этот размен стоит совершать каждый раз. Несколько килобайт покупают извлечение, читающееся одинаково в PDFium, в просмотрщиках, хранящих первое отображение, и в том индексаторе, который ваш клиент запустит в следующем году
Круговой тест ниже пишет строку, содержащую все проблемные пары, извлекает её из несохранённого документа, сохраняет, перезагружает и извлекает снова. Обе строки должны совпасть со входом в точности; хелпер CodePoints нужен лишь для того, чтобы несовпадение можно было прочитать:
uses
  SysUtils, PDFium;

const
  // Пробел/U+00A0 и дефис/U+00AD делят один глиф Arial, как и
  // греческая омега (U+03A9) со знаком ома (U+2126)
  Sample: WString = 'two-x'#$00A0'y'#$00AD'z '#$03A9#$2126;

function CodePoints(const S: WString): string;
var
  I: Integer;
begin
  Result := '';
  for I := 1 to Length(S) do
    Result := Result + 'U+' + IntToHex(Ord(S[I]), 4) + ' ';
end;

var
  Pdf: TPdf;
  Live, Reloaded: WString;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.CreateDocument;
    Pdf.AddPage(1, 595, 842);
    Pdf.AddText(Sample, 'Arial', 12, 72, 770);
    Live := Pdf.Text;                  // живой, несохранённый документ
    Pdf.SaveAs('codepoints.pdf');
  finally
    Pdf.Free;
  end;

  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'codepoints.pdf';
    Pdf.Active := True;
    Pdf.PageNumber := 1;
    Reloaded := Pdf.Text;              // после полного сохранения и перезагрузки
  finally
    Pdf.Free;
  end;

  if (Live <> Sample) or (Reloaded <> Sample) then
    Writeln('Mismatch: ', CodePoints(Live), '/ ', CodePoints(Reloaded));
end.
Держите NBSP и мягкий перенос в тестовой строке, даже если ваши документы содержат их редко. Тест, пишущий только ASCII, пройдёт и против CMap с ключом по глифу, потому что ничто в нём не попросит читатель выбирать между двумя отображениями
Почему одна запись bfrange способна стереть целый блок?
Одиночный bfrange, чей пробег CID пересекает границу xxFF, заставляет PDFium отбросить весь блок, в котором он сидит. ISO 32000-1 §9.10.3 позволяет внутри диапазона меняться только последнему байту назначения, а со стороны CID в парсере PDFium есть симметричная ловушка: старший CID он выводит как (low and $FFFFFF00) or (high and $FF). Пробег от CID 00FE до 0101 читается как 00FE–0001, низ больше высокого, и весь блок помечается недействительным. SetText завершается успехом, страница рендерится правильно, а извлечение возвращает U+0000 для каждого символа этого блока
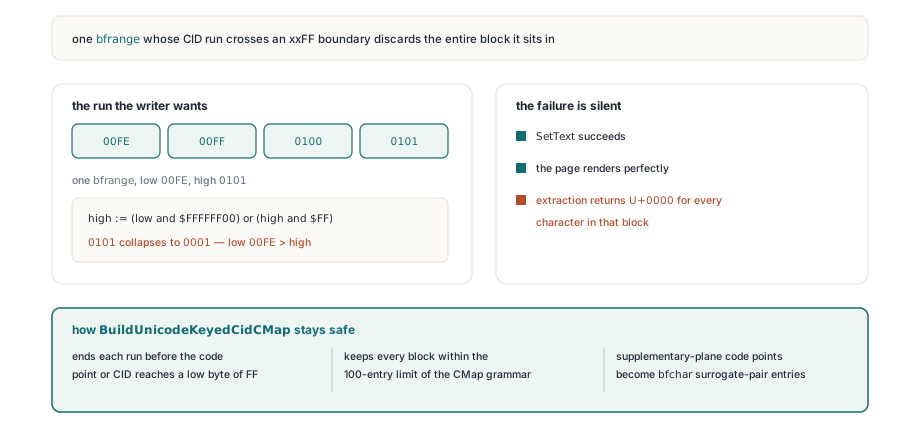
Шрифт с ключом по кодовой точке — ровно то место, где это кусается. CID плотные и последовательные, поэтому любой шрифт с более чем 255 кодовыми точками даёт пробеги CID, которые пересекли бы 00FF, 01FF и так далее, если бы писатель просто сливал соседние записи. CMap, который пишет PDFium Component, завершает пробег раньше, чем кодовая точка или CID дойдут до младшего байта FF, и режет записи на блоки максимум по 100 — лимит, который грамматика CMap накладывает на каждую секцию beginbfrange и beginbfchar
Кодовые точки выше U+FFFF получают отдельные записи bfchar, чьи назначения — суррогатные пары UTF-16, поскольку инкремент суррогатной пары внутри диапазона смысла не имеет по определению. Суррогатная сторона истории — в статье об обработке emoji, CJK и суррогатных пар в Delphi. CMap только из bfchar обошёл бы граничную проблему целиком, ценой многократно большего размера, поэтому диапазоны остаются основной формой, а правила разрезания несут нагрузку
Починка конфликтов ToUnicode в файлах из других инструментов
RepairSubsetToUnicodeCMaps в модуле FPdfCompress чинит конфликт с ключом по глифу в файлах, которые компонент не писал. TPdf.SaveAs запускает его при каждом полном, неинкрементном сохранении, а напрямую его можно вызвать на любом потоке. Для каждого CID с двумя назначениями побеждает запись bfchar. Если у CID нет bfchar, пара, отличающаяся только старшим битом, разрешается в меньшую кодовую точку базовой латыни. Любой другой конфликт сохраняет первое отображение
Починка правит конфликтующие hex-значения на месте, заменами той же длины. Раскладка блоков, покрытие CID и все остальные байты потока остаются как были, поэтому CMap сохраняет форму, которую читатель PDFium уже принял. Чисто пересобранный CMap выглядел бы опрятнее в hex-дампе. Он также изменил бы структуру потока, который строгий читатель уже принял, а это азартная игра без выгоды, когда неправильны всего несколько значений назначений
uses
  Classes, FPdfCompress;

var
  Source, Dest: TFileStream;
begin
  Source := TFileStream.Create('from-other-tool.pdf',
    fmOpenRead or fmShareDenyWrite);
  try
    Dest := TFileStream.Create('repaired.pdf', fmCreate);
    try
      // Только правки равной длины; файлы без устранимого конфликта,
      // а также файлы с cross-reference-потоками или object-потоками копируются как есть
      RepairSubsetToUnicodeCMaps(Source, Dest);
    finally
      Dest.Free;
    end;
  finally
    Source.Free;
  end;
end.
Подпрограмма пересобирает классическую таблицу cross-reference, поэтому документы с cross-reference-потоками, гибридными ссылками или object-потоками проходят насквозь байт в байт. Инкрементные сохранения (saIncremental) пропускают починку намеренно: инкрементная ревизия обязана оставаться append-only. Для текста, который компонент пишет сам, ни тот ни другой случай не важен: его шрифты с ключом по кодовой точке никогда не порождают конфликта, который починка могла бы найти
Где применяется путь с ключом по кодовой точке
Путь с ключом по кодовой точке покрывает каждый шрифт, выставляющий наружу подтаблицу cmap Unicode, а загрузка PDFium с ключом по глифу берёт на себя остальных. Детали, которые стоит знать, прежде чем на него положиться:
- Symbol-шрифты, несущие только cmap (3,0), и любой шрифт, который CID-путь не может загрузить, идут через
FPDFText_LoadFont, где глиф, делимый двумя кодовыми точками, подпадает под правило приоритета читателя - С одной лишь подтаблицей формата 4 карта покрывает базовую многоязычную плоскость; подтаблица формата 12 на платформе (3,10) или Unicode-платформе добавляет кодовые точки дополнительной плоскости
- Глиф 0 и суррогатные кодовые точки исключаются, а число записей ограничено 65535, чтобы каждый CID умещался в два байта выше нуля
- TrueType Collections требуют особой осторожности: GDI-функция
GetFontDataвозвращает весь .ttc, а уFPDFText_LoadCidType2Fontнет параметра индекса гарнитуры, поэтому передача коллекции как есть встроила бы гарнитуру 0 — SimSun, — когда вы просили NSimSun из simsun.ttc. Компонент сверяет имя семейства с таблицей имён шрифта (nameID 1 и 16) и отдаёт запрошенную гарнитуру как отдельный sfnt; коллекцию, которую он не может разобрать, он пропускает целиком, и она использует гарнитуру 0 - Если системный шрифт с запрошенным именем прочесть не удаётся,
AddTextпередаёт имя шрифта вFPDFPageObj_NewTextObj, который ищет его среди стандартных шрифтов PDFium
Схлопывайте невидимые символы в индексе, сохраняйте их в тексте
Когда извлечение возвращает настоящие кодовые точки, возникает другой вопрос: что поисковому индексу делать с настоящим NBSP или мягким переносом, которые автор набрал намеренно? Схлопывайте их в слое индексации и не трогайте TPdf.Text. Извлечённая строка — это запись того, что говорит документ; индекс — это представление с потерями, построенное для сопоставления, и правила схлопывания принадлежат ему
Хелпер ниже — функция, которую вы добавляете в свой код. Он отображает NBSP в пробел и выбрасывает мягкий перенос, который по стандарту Unicode лишь помечает место, где строка может разорваться. U+2126 он нарочно не трогает: нормализация NFC превратила бы знак ома в омегу, потому что у U+2126 есть каноническая синглетонная декомпозиция в U+03A9, а должен ли поиск по даташитам сопоставлять эти два символа — продуктовое решение, а не решение об извлечении:
uses
  SysUtils, Classes, PDFium;

// Ваш собственный хелпер для поискового индекса; не часть PDFium Component
function FoldForIndex(const S: string): string;
begin
  Result := StringReplace(S, #$00A0, ' ', [rfReplaceAll]);
  Result := StringReplace(Result, #$00AD, '', [rfReplaceAll]);
end;

procedure IndexDocument(const FileName: string; Lines: TStrings);
var
  Pdf: TPdf;
  P: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    for P := 1 to Pdf.PageCount do
    begin
      Pdf.PageNumber := P;
      Lines.Add(FoldForIndex(Pdf.Text));   // точный текст остаётся в Pdf.Text
    end;
  finally
    Pdf.Free;
  end;
end;
Запустите IndexDocument на файле codepoints.pdf из первого примера — и проиндексированная строка должна читаться как "two-x yz ΩΩ", одиннадцать символов, где последний — знак ома, тогда как Pdf.Text по-прежнему возвращает все двенадцать исходных символов, включая NBSP и мягкий перенос
Шрифты с ключом по кодовой точке, починка CMap и извлечение текста сидят на одной модели страницы в Delphi, C++Builder и Lazarus; шрифтовый и текстовый API разобран во всей полноте на странице продукта PDFium Component for Delphi