Импортируете FDF в форму — и значения полей приходят тонко неправильно: буллет приходит как кинжал, многоточие — как длинное тире. PDFium Component свёл всё это семейство симптомов к одной строке в своей таблице PDFDocEncoding — спец-блок символов в Приложении D.2 ISO 32000-1 начинается с $80, а не с $7F
Почему импорт FDF возвращает соседний символ?
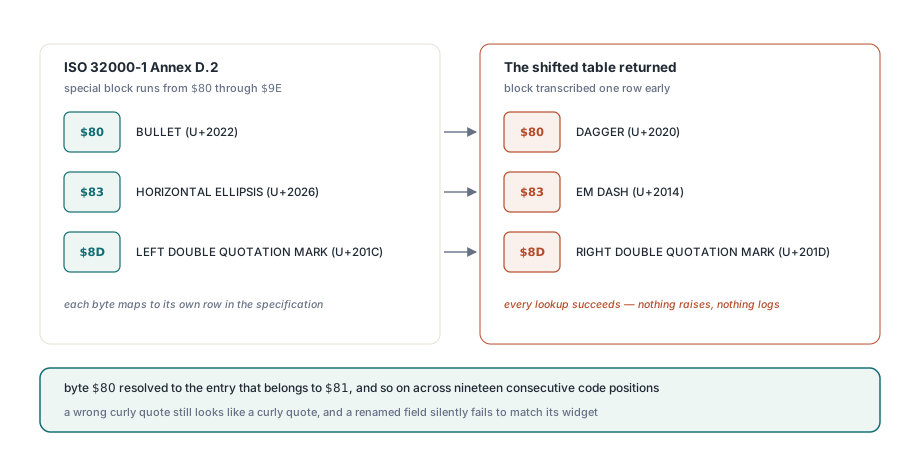
Потому что таблица кодировки, сдвинутая на одну позицию, всё равно выглядит идеально валидной, и каждый поиск в ней успешен. Блок, который Приложение D.2 отводит под $80–$9E, был переписан на одну строку раньше, так что байт $80 разрешался в запись, принадлежащую $81, байт $81 — в запись для $82, и так далее по девятнадцати подряд идущим кодовым позициям. Ничего не поднималось, ничего не логировалось, и ни одно поле никогда не отвергалось — TPdf.ImportFDF докладывал то же число полей, что и всегда
Ущерб был единообразным и тихим. Байт $80, который Приложение D.2 определяет как BULLET (U+2022), возвращался как DAGGER (U+2020). Байт $83, HORIZONTAL ELLIPSIS (U+2026), возвращался как EM DASH (U+2014). Байт $8D, LEFT DOUBLE QUOTATION MARK (U+201C), возвращался как RIGHT DOUBLE QUOTATION MARK (U+201D) — случай, которого никто не замечает, потому что неверная фигурная кавычка в поле формы всё ещё выглядит как фигурная кавычка. Имена полей постигла та же участь, что и значения, а это хуже: имя, которое больше не совпадает с виджетом в документе, молча не применяется
Текстовые строки PDF несут две разные кодировки
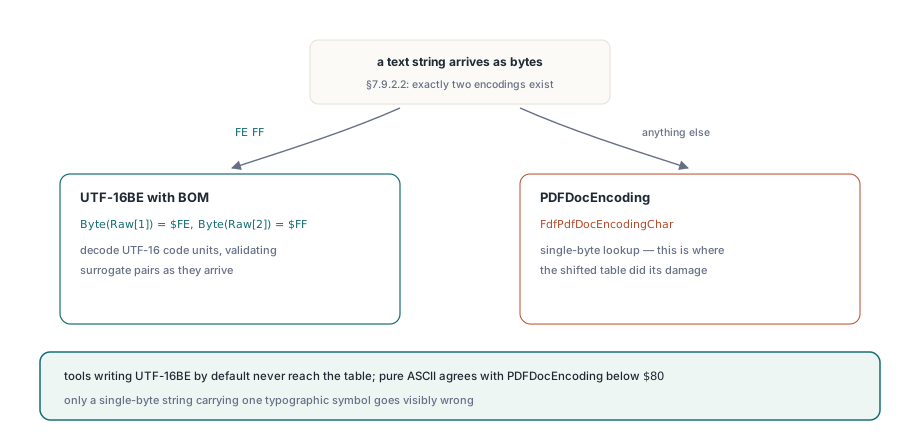
ISO 32000-1 §7.9.2.2 определяет тип текстовой строки как одну из ровно двух кодировок, выбираемых по первым двум байтам, а не по какой-либо записи словаря. Строка, открывающаяся маркером порядка байтов FE FF, — это UTF-16BE; всё остальное — PDFDocEncoding. Эта единственная ветка решает, какой из двух совершенно разных декодеров запустится, и PDFium Component применяет её внутри FDF-парсера до касания хоть одного символа
// Текстовая строка FDF: UTF-16 при наличии BOM, иначе PDFDocEncoding
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... декодируем кодовые единицы UTF-16 с валидацией суррогатных пар
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
Вот почему баг так долго прятался в обычном тестировании. Любой FDF, произведённый инструментом, который по умолчанию пишет UTF-16BE, вообще не доходит до FdfPdfDocEncodingChar, так что сдвинутая таблица остаётся спящей. Только однобайтовые строки — а именно их многие FDF-генераторы эмитят для простых латинских имён полей, потому что они короче — идут по ветке, где таблица важна. Чисто ASCII-имена полей при этом всё равно декодируются корректно, ведь ниже $80 PDFDocEncoding и ASCII согласны. Нужна однобайтовая строка с одним типографическим символом, чтобы что-то стало видимо не так
Исправленная таблица и два якоря, которые её прибивают
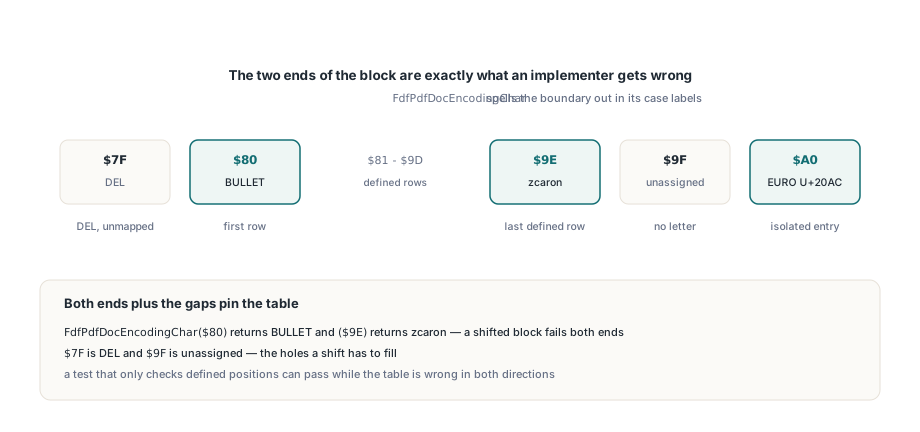
PDFium Component теперь прописывает границу прямо в FdfPdfDocEncodingChar, потому что два конца блока — ровно то, в чём имплементатор ошибается. $7F — это DEL, и в PDFDocEncoding он вообще не имеет значения; блок открывается на $80 буллетом и идёт до $9E с zcaron; $9F не назначен; а знак евро сидит один на $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Приложение D.2. Блок идёт с $80, а не с $7F: $7F это DEL и
    // не имеет значения в PDFDocEncoding, а евро сидит на $A0, который
    // ветка по умолчанию иначе вернула бы как no-break space
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, первая строка блока
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 по $9D
    $9E: Result := WideChar($017E);   // zcaron, последняя определённая строка
    $9F: Result := WideChar($FFFD);   // не назначен в Приложении D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Смотрите, что сдвиг сделал с этими двумя концами, потому что именно там off-by-one перестаёт быть косметикой. zcaron сидел на $9E в спецификации, но на $9D в сдвинутой таблице, так что байт документа $9E пролетал мимо последней строки, которую кто-либо переписывал, и падал прямо в fallback идентичности, возвращая управляющий символ C1 вместо буквы. А $A0, евро, вообще никогда не был записан в таблицу — ветка идентичности возвращала его как U+00A0 NO-BREAK SPACE, символ, который переживает любую последующую валидацию, печатается как ничто и никогда не совпадает с именем поля, которое вы ищете
Как тестировать переписанную таблицу кодировки?
Тестируйте первую строку, последнюю строку и пробелы — а не выборку из середины. Это часть фикса, которую стоит перенести на любую другую таблицу, скопированную из спецификации, потому что точечная проверка из середины блока — ровно тот тест, который сдвиг целого блока переживает. Проверка, что $8D даёт левую двойную кавычку, ничего не доказывает, когда $8C тоже даёт что-то правдоподобное; проверка, что $80 даёт BULLET, а $9E даёт zcaron, прибивает оба конца, и сдвинутый блок не может удовлетворить оба одновременно
procedure CheckPdfDocEncodingAnchors;
begin
  // Оба конца спец-блока Приложения D.2: сдвиг целого блока их ломает
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Кодовые позиции, которые спецификация оставляет неопределёнными, не должны декодироваться в букву
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // Изолированная запись над блоком, которую легко упустить целиком
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Неопределённые позиции заслуживают собственных ассертов, а не пропуска как неинтересные. Off-by-one обязан что-то куда-то положить, и кладёт он почти всегда в кодовую позицию, которую спецификация оставила пустой, — $7F спереди, $9F сзади. Тест, проверяющий только определённые позиции, может пройти при таблице, неверной в обе стороны; тест, прибивающий дыры, ловит сдвиг на первом же прогоне
Чего это стоит в round-trip рабочем процессе с формами
Импорт FDF, который тихо переписывает по одному символу на каждый символ, хуже падающего, потому что отказ всплывает ниже по потоку и выглядит как что-то другое. Имена полей здесь — острый край. TPdf.ImportFDF сверяет входящие имена с виджетами в открытом документе, и имя, декодированное с одной неверной буквой, просто не совпадает — поле остаётся пустым, возвращаемое значение по-прежнему считает поле распарсенным, и отчёт, выходящий из конвейера, недосчитывает одно значение, а в логах нет ничего, что объясняло бы почему. Всякому, кто строит цикл экспорта-реимпорта вроде описанного в экспорте и импорте данных форм XFDF и аннотаций через PDFium Component, стоит прогнать в round-trip имя поля с типографическим символом, а не только чистый ASCII, прежде чем доверять циклу
Стоит также честно сказать о границах фикса. Таблица теперь совпадает с Приложением D.2 для всех 256 значений байтов, что делает однобайтовые строки FDF корректными, но сама PDFDocEncoding покрывает латинский репертуар и ничего больше — всё вне него должно приходить как UTF-16BE с BOM, а это ровно то, что задумано в §7.9.2.2. И у строки UTF-16 есть свои отдельные опасности на стороне Delphi, поскольку кодовая точка выше U+FFFF требует суррогатной пары, а не одного WideChar, — проблема, разобранная в почему emoji и CJK-символы ломают WideChar в Delphi. Более широкая мысль обобщается дальше таблиц кодировки: парсер PDF может либо отвергнуть то, что должен принять, — и вы узнаете об этом сразу, либо принять и тихо исказить, — и вы узнаете об этом в проде. Ловушки с name-токенами из безопасного парсинга словарей PDF сидят во второй категории, и таблица, сдвинутая на одну строку, тоже — путь кода успешен, возвращаемое значение выглядит разумным, и только тест, написанный против спецификации, а не против реализации, скажет обратное
ImportFDF, ExportFDF и ImportXFDF на TPdf, вместе со стоящими за ними парсерами FDF и XFDF, — часть стандартного PDFium Component для Delphi и C++Builder