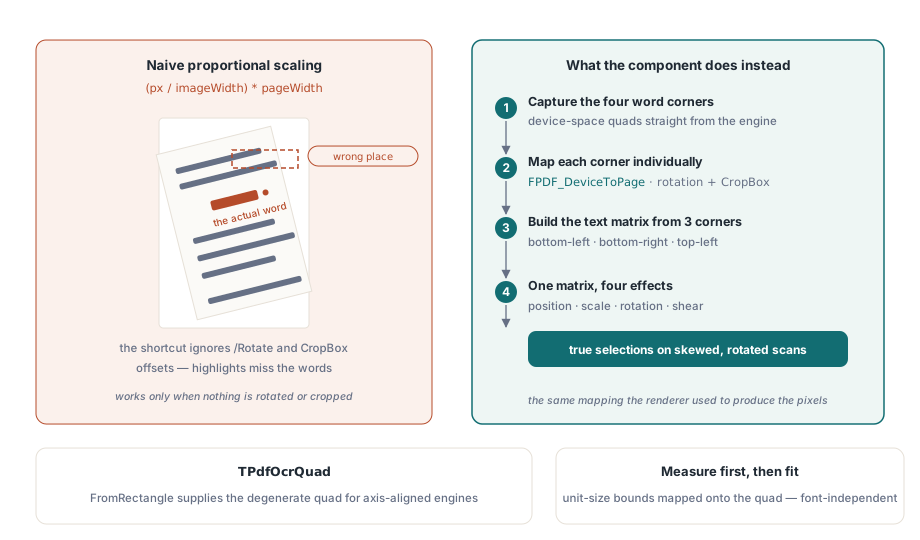
Поиск номера счёта в сканированном PDF находит совпадение, но подсветка ложится на полдюйма левее напечатанных цифр и на полдюйма ниже. Полдюйма — это 36 пунктов, а у страницы из примера CropBox равен [36 36 576 756]. Тот, кто собирал этот текстовый слой, переводил пиксельные координаты в страничные, деля на ширину битмапа и умножая на ширину страницы, — а это работает только когда видимая область начинается в начале координат. На странице с /Rotate 90 та же формула ошибается куда сильнее: ось x битмапа теперь идёт вдоль оси y страницы, и слова оказываются вообще не в той части страницы
Что такое невидимый текстовый слой на самом деле
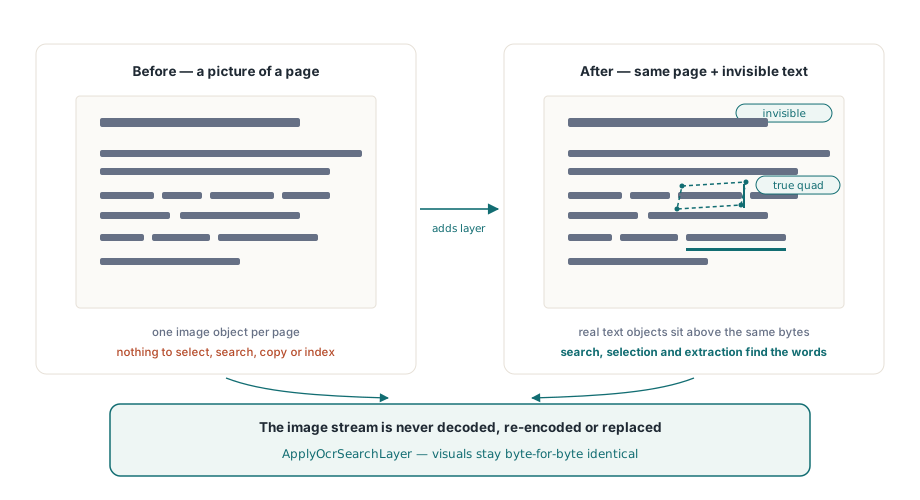
Сканированная страница — это одно большое изображение, нарисованное контентным потоком. Выделять, искать, копировать и индексировать здесь нечего. Слой поиска по тексту добавляет поверх этого изображения обычные текстовые объекты и выставляет им режим отрисовки текста 3, который ISO 32000-1 §9.3.6 (таблица 106) определяет как «ни заливка, ни обводка»: глифы существуют для выделения, поиска и извлечения, а просмотрщик не рисует для них ничего. Если всё сделано правильно, читатель видит исходный скан, а Ctrl+F находит слова ровно там, где они напечатаны
В PDFium Component вся работа — один вызов, TPdf.ApplyOcrSearchLayer. Метод рендерит каждую выбранную страницу, передаёт пиксели OCR-поставщику, фильтрует распознанные слова по достоверности и записывает выжившие обратно невидимыми текстовыми объектами. Изображение страницы остаётся как есть: скан не декодируется, не перекодируется и не заменяется, поэтому изображение JBIG2 или CCITT G4 сохраняет ровно те сжатые байты, с которыми пришло. Метод доступен в редакциях Small Business и Enterprise, так что проекту нужно держать Lib\SmallBusiness на пути поиска и FPdfSmallBusiness в uses; без этого модуля вызов поднимает EPdfSmallBusinessRequired
Пишем IPdfOcrProvider
Само распознавание спрятано за одним интерфейсом. IPdfOcrProvider.RecognizePage получает TPdfOcrImage (номер страницы, ширина, высота, stride, DPI, формат пикселей и буфер TBytes с top-down строками BGRA), плюс токен отмены, и возвращает массив записей TPdfOcrWord: текст в Unicode, достоверность от 0 до 1 и четырёхугольник из четырёх углов в пикселях изображения. В редакцию входит один готовый поставщик, CreatePdfTesseractOcrProvider из FPdfOcrTesseract, который привязывается к библиотеке Tesseract и каталогу traineddata, поставляемым вами. Любой другой движок — облачный API или коммерческий SDK — подключается через класс вроде этого:
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // Engine* — условные подпрограммы вашей собственной привязки к OCR-движку
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // отмену докладываем как отмену

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // многие движки выдают 0..100, слою нужен диапазон 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Поставщик, который пропускает 87.5 от Tesseract как есть, получит отказ для каждого слова. Tesseract, например, выдаёт достоверность слова в процентах, и комплектный адаптер делит её перед возвратом; самодельный поставщик обязан делать то же, потому что ApplyOcrSearchLayer считает достоверность выше 1 недопустимым входом. Симптом невозможно перепутать, если знать, куда смотреть: Report.RejectedWordCount равен Report.DetectedWordCount, а в сохранённом файле нет ни одного слова
Вызов токена важен по другой причине. Если поставщик замечает отмену и просто возвращает False, страница попадает в отчёт как popsFailed с тем сообщением, которое вы задали. Вызов ThrowIfCancelled поднимает вместо этого EPdfOperationCancelled, который слой перехватывает и записывает как popsCancelled, выставляя Report.Cancelled и останавливая цикл. Внутри поставщика токен никогда не nil; когда вызывающий не передал ничего, подставляется токен, который никогда не отменится
Четырёхугольники и слова, которые слой не принимает
Сканы редко стоят на странице идеально прямо, поэтому слово на чуть перекошенном листе занимает параллелограмм. Для именно такого случая TPdfOcrQuad несёт точки TopLeft, TopRight, BottomRight и BottomLeft, а FromRectangle собирает вариант, выровненный по осям, для движков, которые выдают только прямоугольные рамки. Слово пропускается и попадает в RejectedWordCount, если его текст пуст или длиннее MaxWordCharacters, если его достоверность NaN, ниже MinConfidence или выше 1, если какой-то из углов оказался за пределами битмапа или если четырёхугольник схлопывается в щель уже 0.01 pt после проецирования
Почему пропорциональное масштабирование смещает слова OCR
Пропорциональное масштабирование корректно, только если у страницы нет записи /Rotate и её CropBox начинается в (0, 0). Множество сканов нарушает хотя бы одно из этих условий: альбомный лист часто хранится как портретная страница с выставленным /Rotate, а кадрирующие блоки смещаются, когда кто-то подрезает поля в редакторе. Пример из начала статьи — мягкий случай; при повороте ошибка перестаёт быть смещением и превращается в перепутанные оси
ApplyOcrSearchLayer пропускает каждый из четырёх углов через FPDF_DeviceToPage, используя тот же размер битмапа и тот же поворот, с которыми были получены пиксели, увиденные поставщиком. Поворот и смещения CropBox поэтому обрабатываются тем же преобразованием, каким пользовался рендерер. Углы округляются до целых пикселей на входе, что при стандартных 300 DPI даёт шаг квантования 0.24 pt — намного меньше, чем способна показать подсветка выделения
Из спроецированных точек нижний левый, нижний правый и верхний левый углы задают аффинную матрицу. Трёх точек достаточно, чтобы выразить позицию, масштаб, поворот и сдвиг, поэтому четвёртый угол только проверяется и никогда не участвует в подгонке. Текстовый объект создаётся с размером шрифта 1, его реальные границы измеряются, и матрица отображает измеренные границы на целевой четырёхугольник. Угадывать размер в пунктах по высоте четырёхугольника — значит плыть вместе с выносными и подстрочными элементами каждого шрифта; измерение заранее делает подгонку независимой от шрифта, названного в Options.FontName
Шрифт всё ещё важен для извлечения, даже если ничего не рисуется. TPdfOcrOptions.Default ставит Arial. Если этот шрифт не загружается, слой откатывается к стандартному Helvetica, одному из стандартных 14 шрифтов, чья встроенная кодировка покрывает только латиницу. Для кириллицы, греческого или CJK задайте в FontName установленный шрифт, покрывающий нужную письменность
Запускаем слой и читаем отчёт
ApplyOcrSearchLayer возвращает True, только когда ни одна страница не провалилась и ничего не отменено. Этим возвращаемым значением — неправильный флаг для решения о сохранении. При ContinueOnError, оставленном в умолчательном True, задача на 300 страниц с одной нечитаемой страницей вернёт False, хотя 299 страниц несут правильный слой, а провалившаяся страница уже возвращена к исходному виду. Ставьте сохранение в зависимость от отчёта:
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // держите его там, откуда до него дотянется кнопка Cancel
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0.5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
Не сохранять после отмены — решение по выбору, и здесь принято именно оно. Отменённая задача оставляет файл, который доступен для поиска в первой части и пуст во второй, и ничто в PDF не подскажет следующему читателю, где слой кончается. Перепрогнать весь документ позже дешевле, чем объяснять полупроиндексированный архив
SkipPagesWithText по умолчанию True и проверяет, выдаёт ли страница хоть какие-то извлекаемые символы. Это удерживает изначально цифровые страницы вне OCR, мешает второму слою на файлах, обработанных ранее, и превращает повторный прогон того же вывода в no-op. Обратная сторона: достаточно одного настоящего символа. Скан со штампом Бейтса, впечатанным настоящим текстом, получит статус popsSkippedExistingText и останется без слоя. Архивам, собранным так, нужны SkipPagesWithText := False и аккуратный диапазон страниц через FirstPage и LastPage, иначе ранее обработанные страницы обзаведутся дублирующим слоем, а извлечение вернёт каждое слово дважды
Пиксельные бюджеты, отмена и постраничный откат
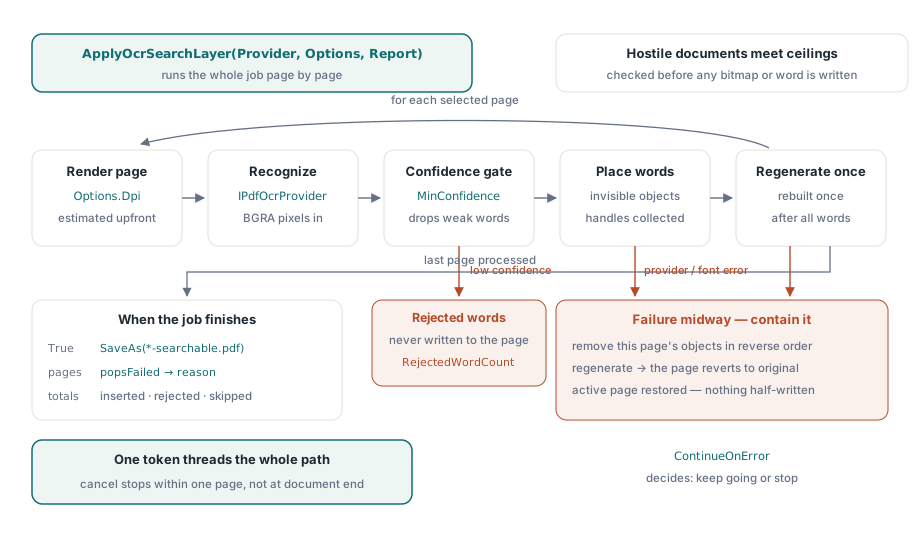
У каждой величины, которую враждебный или просто огромный документ способен раздуть, есть потолок в TPdfOcrOptions, и пиксельные проверки выполняются до выделения хоть одного битмапа. Размер рендера — Ceil(PageWidth * Dpi / 72) на Ceil(PageHeight * Dpi / 72), так что числа можно посчитать заранее:
| Страница при 300 DPI | Битмап | Пиксели |
|---|---|---|
| US Letter, 612 × 792 pt | 2550 × 3300 | 8,415,000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8,702,320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17,415,167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139,493,228 |
Умолчания — 100 миллионов пикселей на страницу и 1 миллиард на задачу. Чертёж A0 при 300 DPI превышает MaxPixelsPerPage уже сам по себе. Общий бюджет задачи кончается раньше постраничного: при 8,415,000 пикселей на страницу Letter под 1 миллиард укладываются 118 страниц, а страница 119 проваливается с сообщением, называющим MaxTotalPixels, — как и все страницы после неё. Для длинных сканированных архивов поднимайте MaxTotalPixels, как в примере выше, или делите работу на диапазоны через FirstPage и LastPage. Пропущенные страницы не рендерятся и не считаются. Комплектный адаптер Tesseract добавляет собственный лимит, TPdfTesseractOptions.MaxPixels, по умолчанию 16,777,216; лист A3 при 300 DPI — чуть больше этого, поэтому для пакетов A3 нужно поднять лимит адаптера или снизить DPI
DPI должен лежать между 36 и 1200. Удвоение с 300 до 600 учетверяет битмап, а каждый пиксель стоит 4 байта, поэтому страница Letter вырастает с примерно 34 MB BGRA до примерно 135 MB. Для обычных офисных сканов 300 DPI уравновешивает качество распознавания и память; 600 стоит своих байтов для мелкого шрифта и сносок, но не для целых архивов. Количество слов ограничивают MaxWordsPerPage и MaxTotalWords, и поставщик, вернувший больше слов, чем страница позволяет, проваливает страницу, а не обрезается
Токен отмены доходит до прогрессивного рендера, вызова поставщика и цикла вставки слов. Отмена во время распознавания страницы 212 из файла на 400 страниц останавливает работу на странице 212 — при условии, что поставщик уважает переданный ему токен. Адаптер Tesseract идёт дальше и регистрирует в движке callback отмены рядом с постраничным таймаутом в 60,000 ms по умолчанию
Сдерживание сбоев — на уровне страницы. Слой хранит дескриптор каждого вставленного текстового объекта и вызывает FPDFPage_GenerateContent один раз, после размещения последнего слова на странице. Если посреди этого что-то проваливается — шрифт отказывает символу или отмена приходит посреди цикла, — объекты, уже вставленные на эту страницу, удаляются в обратном порядке и контент страницы генерируется заново, так что страница возвращается ровно к тому, что имела до вызова. Дальше цикл продолжается или останавливается в соответствии с ContinueOnError, и страница, активная до вызова, снова активна после него
Проверяем результат
Две проверки покрывают большую часть того, что может пойти не так. Первая — визуальная: отрендерите одну страницу из исходного файла и ту же страницу из обработанного в одном размере через TPdf.RenderPage, затем сравните битмапы. Ожидание: идентичны, потому что режим 3 ничего не рисует и поток изображения не тронут; любое расхождение пикселей значит, что страницу изменило что-то кроме текстового слоя. Вторая проверяет, что слова существуют и сидят там, где их показывает скан:
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Выберите пробное слово, которое легко найти глазами на скане, — заголовок или итог, — и сверьте выданные координаты с его положением на отрендеренном изображении. На странице с CropBox из вступления значение x должно начинаться с 36 или больше, но никак не около нуля. Извлечение текста подробнее разобрано в статье про извлечение текста из PDF-документов, рендеринг страниц для совмещающего оверлея — в конвертации страниц PDF в JPEG, а используемый на всём пути шаблон токена — в отменяемом прогрессивном рендеринге
Слой OCR соседствует с рендерингом, извлечением текста и редактированием страниц на том же объекте TPdf, в Delphi, C++Builder и Lazarus. Редакции и полный список API — на странице продукта PDFium Component for Delphi