При выключенной проверке переполнения 2000000000 + 2000000000 вычисляется в -294 967 296, когда оба операнда — Delphi Integer. Это число перестаёт быть trivia в тот момент, когда парсер контейнера читает из заголовка записи смещение и длину и складывает их, чтобы проверить, влезает ли встроенный PDF в буфер. Сумма заворачивается в минус, сравнение с Length(Data) проходит, и следующая строка берёт адрес байта примерно в двух гигабайтах за концом массива. Загрузка PDF из середины большего буфера нуждается в проверке диапазона, которая никогда не складывает, и в ясном ответе, кто владеет байтами, когда документ уже открыт
Эта статья о документах, уже лежащих в RAM, на известном смещении внутри чего-то ещё. Документы, слишком большие для памяти, — другая проблема, решаемая подтягиванием блоков с диска по требованию, как описано в потоковой загрузке больших PDF по требованию с PDFium VCL. Последний раздел проводит границу
Встроенный PDF на известном смещении
Почтовое хранилище держит тела сообщений и вложения в одной записи. Архивный контейнер склеивает манифест, несколько изображений и PDF. Собственный wire-протокол оформляет документ за length-prefixed заголовком. Пусть запись — 40 МБ, PDF начинается с байта 1 182 336 и тянется на 312 КБ. Привычный код вызывает Copy(Data, Index, Count), чтобы отрезать срез, и передаёт этот срез загрузчику, который копирует его ещё раз. Считая контейнер, те же 312 КБ теперь существуют втроём, а скан почтового ящика повторяет это для каждого сообщения
PDFium Component адресует окно напрямую. TPdf объявляет LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True), где Index — нулевая байтовая позиция, а Count — длина в байтах. Метод валидирует оба числа, вычисляет один указатель и пересылает в перегрузку по указателю LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean), которая открывает документ через FPDF_LoadMemDocument64. Форма целого массива LoadDocument(const Data: TBytes; Buffered: Boolean) — вызов в одну строку байт-диапазонной формы с 0 и Length(Data), поэтому каждая загрузка TBytes проходит одну и ту же валидацию
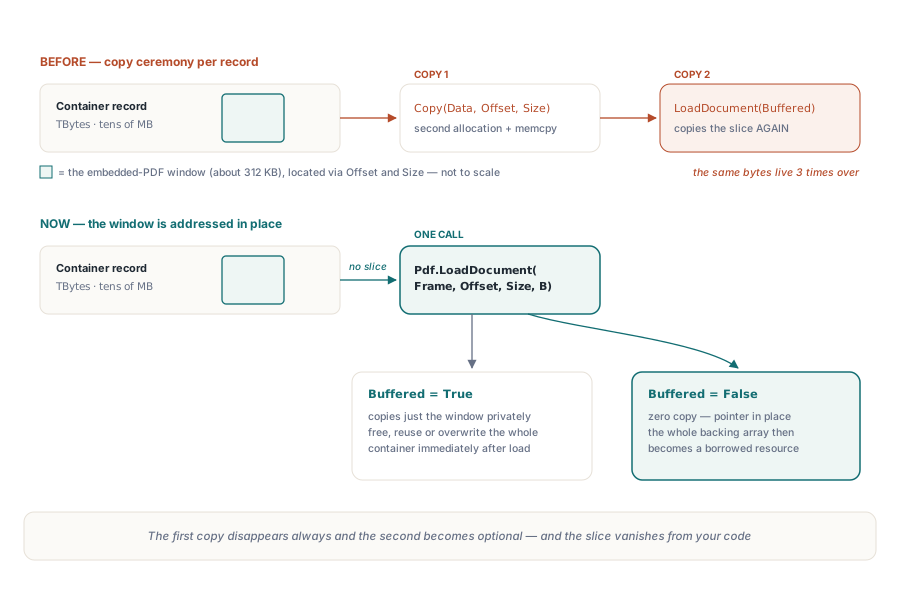
В коде срез просто исчезает. LocateEmbeddedPdf стоит за вашим собственным парсером контейнера
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // вся запись контейнера, десятки мегабайт
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // ваш парсер, не часть компонента

  Pdf := TPdf.Create(nil);
  try
    // Никаких Copy(Frame, Offset, Size): окно адресуется на месте
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered по умолчанию True
    Frame := nil;  // здесь безопасно: копировалось только окно PDF
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // закрывает документ
  end;
end;
Когда глобальный EnableV8Engine всё ещё False и библиотека PDFium ещё не загружена, memory-загрузчики сканируют входящие байты на маркеры XFA и включают EnableV8Engine, если найдут, — так грузится DLL с поддержкой V8. При байт-диапазонном вызове этот скан видит только окно. Манифест или второй документ в другом месте той же записи не смогут его запустить
Почему Index плюс Count переполняет проверку границ?
Потому что Index и Count — оба 32-битные знаковые Integer, и сложение двух больших положительных не обязано давать большое положительное. Где смещение и длина приходят из заголовка файла, ими управляют атакующий или повреждённая запись. Та же ловушка ждёт и в вашем парсере контейнера, который вычисляет эти числа первым делом
// Помощник для вашего парсера контейнера (предложение, не часть компонента)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // НЕВЕРНО: Index + Count вычисляется как Integer и может завернуться в минус
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // ВЕРНО: отбросьте знаки, ограничьте Index отдельно, затем сравните Count
  // с остатком; единственная арифметика — вычитание, которое не может завернуться
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;
Прогоните провальный случай. При Index = 2000000000 и Count = 2000000000 истинная сумма — четыре миллиарда, но 32-битная знаковая арифметика хранит её как -294 967 296. Это значение комфортно ниже любого Length(Data), неверная проверка проходит, и @Data[Index] указывает далеко за пределы массива с приставленной длиной в два гигабайта. Падение — хороший исход. Плохой — PDFium разбирает ту память процесса, которая там случайно оказалась
Правильный порядок никогда не складывает. Отрицательные значения отбрасываются прежде всякой индексации. Затем Index ограничивается сам по себе относительно Length(Data), что гарантирует неотрицательность Length(Data) - Index как Integer, и только потом Count сравнивается с этим остатком. Delphi вычисляет and с short-circuit логикой по умолчанию ({$B-}), поэтому каждый следующий член выполняется лишь когда предыдущие держатся. Не опирайтесь на {$Q+} как на страховочную сетку: release-сборки штатно уходят в свет с выключенной проверкой переполнения, а с включённой вы просто обменяли дыру в памяти-безопасности на EIntOverflow, вылетающий из середины рутины валидации
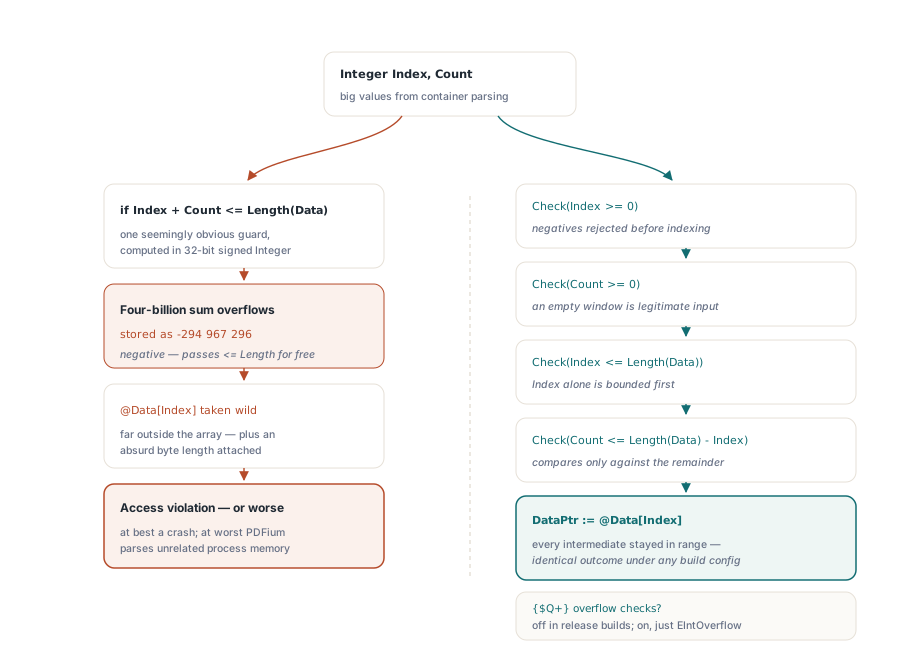
Байт-диапазонный LoadDocument прогоняет те же четыре теста в том же порядке и поднимает EPdfError с сообщением, называющим нарушенное правило: "PDF byte range index cannot be negative", "PDF byte range count cannot be negative", "PDF byte range index exceeds data length" и "PDF byte range exceeds data length". Каждый можно воспроизвести на массиве из четырёх байтов. Index = 5, Count = 0 ловит третье сообщение, Index = 2, Count = 3 — четвёртое, и после каждого отказа Pdf.Active всё ещё False. Более широкое покрытие обращения с недоверенными длинами на границе с нативным кодом — в закалке ABI и памяти-безопасности PDFium VCL в Delphi
Окно нулевой длины — всё ещё законный вызов
Пустое окно передаёт nil-указатель, потому что @Data[Index] — не законное выражение для каждого Index, который принимает валидация. Index = Length(Data) при Count = 0 — корректное пустое окно в хвосте буфера, а пустой TBytes даёт Index = 0 на массиве без нулевого элемента. Взятие адреса в любом из случаев читает за концом или разыменовывает nil-динамический массив, и со включённой проверкой диапазона Delphi поднимает ERangeError прежде, чем загрузчик вообще запустится
Поэтому байт-диапазонная перегрузка ветвится: Count = 0 даёт nil, любой другой счётчик даёт @Data[Index]. Указательная перегрузка принимает nil только вместе с нулевым размером, PDFium затем отказывается открывать пустой буфер, и вызов заканчивается обычным EPdfError с последним текстом ошибки PDFium, или "Cannot load PDF document", когда PDFium не сообщает ничего. Заголовок, заявляющий вложение в ноль байтов, получает то же ловимое исключение, что и прочий плохой вход. Отвергнуть его в своём парсере, с номером записи в сообщении, всё же читается лучше в логе поддержки
Buffered решает, кто владеет байтами
Buffered — единственный параметр здесь, чьи последствия переживают вызов. При Buffered = True компонент копирует выбранное окно, и только окно, в свой буфер до загрузки. В примере с 40 МБ копируются 312 КБ, и контейнер остаётся нетронутым. Как только LoadDocument вернулся, вы можете освободить, переиспользовать или перезаписать контейнер немедленно
При Buffered = False @Data[Index] идёт прямо в FPDF_LoadMemDocument64, и PDFium продолжает читать через этот указатель, пока документ открыт. Весь подложащий TBytes становится заимствованным. Он обязан оставаться живым и неизменным, пока вы не выставите Active := False или не освободите TPdf. Важен весь массив, а не только окно: динамический массив Delphi считается по ссылкам одним блоком, поэтому падение последней ссылки где угодно в вашем коде освобождает память, которую PDFium всё ещё читает. SetLength столь же смертоносен: реаллокация может сдвинуть блок
Две детали Delphi делают здесь ошибку легче, чем кажется. У динамических массивов нет copy-on-write, в отличие от строк, поэтому Other := FFrame; Other[0] := 0; пишет в те самые байты, которые разбирает PDFium. А приёмный буфер, который ваш сетевой код переиспользует для следующего кадра, будет перезаписан под открытым документом. Передача результата функции прямо в вызов, как в Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False), оставляет массив удерживаемым лишь скрытой временной переменной, умирающей вместе с вызывающей рутиной, — пока документ живёт дальше
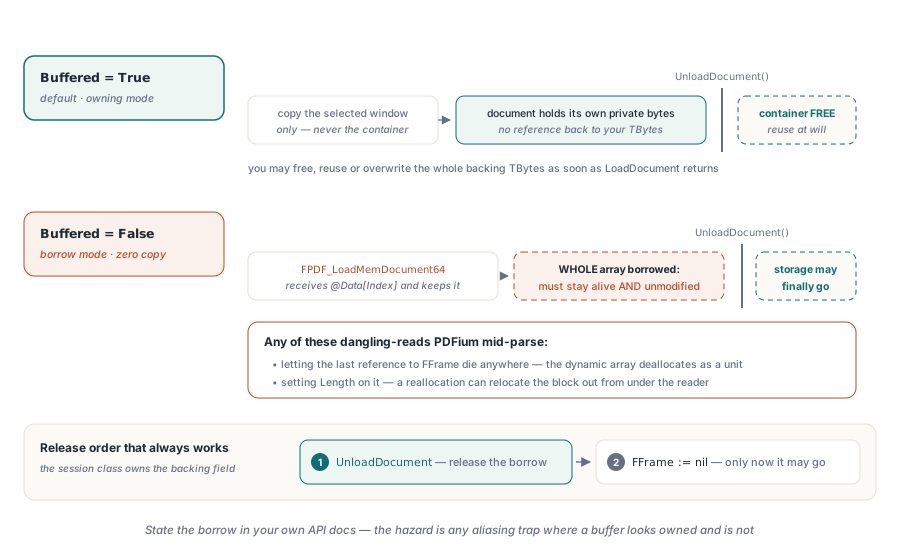
Держите Buffered = True для всего, что пересекает поток, сидит за переиспользуемым буфером или переживает загрузившую его рутину. Дополнительная цена — одна копия размера самого PDF, и она покупает свободу выбросить запись на 40 МБ в момент возврата вызова. Заимствование оправдано только когда контейнер — уже долгоживущее поле, которое вы всё равно держите всю сессию, как вьюер, держащий запись архива открытой, пока пользователь листает вложение. В таком случае сделайте владение явным в одном классе
type
  TFrameSession = class
  private
    FFrame: TBytes;   // владеет опорным хранилищем, пока FPdf держит документ открытым
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // разделяет массив; больше никто не имеет права в него писать
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // сначала закройте любое прежнее окно
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame обязан пережить этот документ
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. верните заимствование
  FPdf.Free;
  FFrame := nil;         // 2. только теперь хранилище может уйти
  inherited;
end;
Конструктор разделяет массив вызывающего вместо копирования, так что вызывающий обязан прекратить в него писать. Не можете этого пообещать — передайте конструктору Copy(AFrame), и вы вернётесь к одной копии, сделанной раз за сессию вместо раза на загрузку
Проверка, что окно начинается с %PDF-
Окно, сбежавшее на несколько байтов, — тонкий провал, потому что документ может всё равно открыться. ISO 32000-1 §7.5.4 определяет каждую запись cross-reference как байтовое смещение от начала файла, а §7.5.2 кладёт заголовок %PDF- в начало. Когда ваш парсер недосчитал префикс и окно начинается на восемь байтов раньше, те смещения уходят на восемь байтов в сторону. PDFium ищет заголовок в первых 1024 байтах и компенсирует ведущий мусор; окно, начавшееся поздно или закончившееся рано, может толкнуть его на перестройку cross-reference таблицы по найденным маркерам объектов. В любом случае счётчик страниц выглядит правильным. Смещение в вашем парсере всё ещё неверное, и следующий читатель той записи может быть менее снисходителен
Перегрузка LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) делает это видимым. Report.HeaderOffset — то место, где %PDF- найден в первых 1024 байтах окна, или -1, если не найден. Report.UsedRecovery равен True, когда PDFium не принял cross-reference таблицу как валидную. Все смещения в отчёте считаются от первого байта окна, а не от контейнера. Слишком короткий Count отрезает хвостовой %%EOF, и TPdfLoadOptions.Default(plmStrict) включает RequireFinalEndOfFileMarker, так что строгий режим отвергает такое окно целиком
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning — ваша собственная рутина логирования
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
У ревизии за теми полями есть цена, значимая для заимствованных загрузок. Когда окно влезает в Options.AuditByteLimit (256 МБ по умолчанию), ревизия читает временную копию окна, поэтому Buffered = False в паре с отчётом больше не обходится без копирования на время загрузки. AuditByteLimit в 0 пропускает ревизию и копию и оставляет HeaderOffset на -1. Прогоняйте ревизионную форму, пока разрабатываете парсер контейнера и против новых источников записей; переключайтесь на простую перегрузку, когда смещениям можно верить. Остальной отчёт разобран в отлове провалов загрузки PDF отчётом PDFium
Когда байтовый диапазон — не тот инструмент
Байт-диапазонная перегрузка предполагает, что весь контейнер уже в памяти, а поскольку Count — Integer, одно окно не может превысить MaxInt байтов. Архив на 6 ГБ на диске или сокет, который нельзя перемотать, в эту форму не влезают, и читать всё в TBytes ради адресации окна внутри — против смысла приёма. Для таких случаев LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) позволяет PDFium подтягивать блоки из seekable-потока по требованию. Небольшой собственный потомок TStream, прибавляющий стартовое смещение PDF к каждому Seek, представит встроенный документ так, будто он начинается с нулевой позиции, как показывает статья о потоковой загрузке по требованию
Второе несоответствие — контент, ещё не являющийся чистым PDF. Если встроенные байты сжаты, зашифрованы контейнером или завёрнуты в другую кодировку, преобразованная копия неизбежна, и загрузка нового массива с дефолтным Buffered = True — прямолинейный ответ. Байтовый диапазон окупается в одной форме: непрерывные, неизменённые байты PDF, уже резидентные, на смещении, которое ваш парсер валидировал без сложения
Байт-диапазонный вызов сидит рядом с загрузкой из файла, потока, сырого указателя и по требованию в том же компоненте TPdf. На странице продукта PDFium Component перечислены поддерживаемые версии Delphi и C++Builder, варианты лицензирования и остальная часть API загрузки