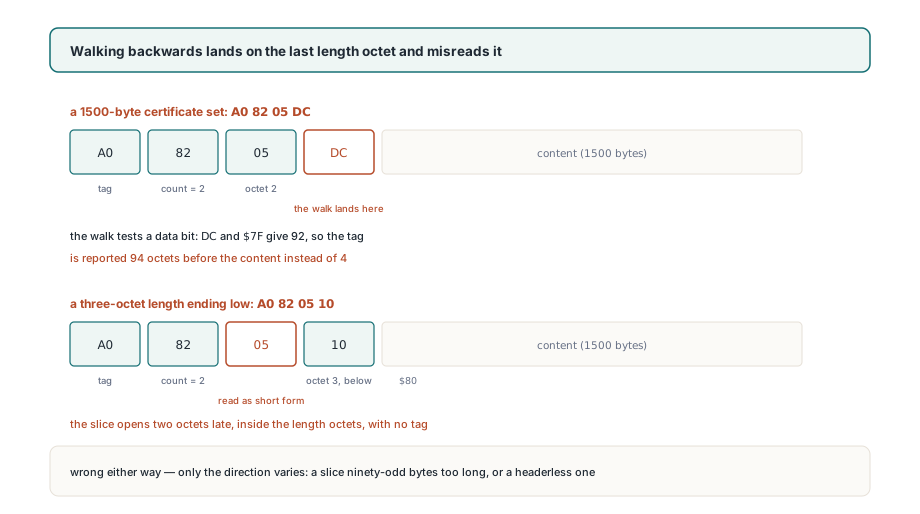
Четыре байта A0 82 05 DC открывают context-specific элемент [0], несущий 1500 байт содержимого. Читая слева направо, они однозначны: тег A0, начальный октет длины 82, объявляющий ещё два, затем 05 DC. Читая справа налево, начиная с первого байта содержимого, первый встреченный октет — DC. Его старший бит выставлен, а младшие семь бит говорят 92, поэтому помощник, доверяющий ему, докладывает, что тег лежит за 94 байта до содержимого. Настоящее расстояние — 4
Никто не ходит назад нарочно. Это случается потому, что большинство DER-ридеров возвращают смещение и длину содержимого каждого элемента — ровно то, что нужно, чтобы спуститься внутрь, — тогда как копирование соседнего элемента без изменений требует смещения его тега. Вычитание из смещения содержимого выглядит работой на две строки и остаётся корректной, пока каждая длина умещается в один октет. Длина настоящего набора сертификатов в один не умещается никогда
Что метка времени подписи делает с подписанным CMS
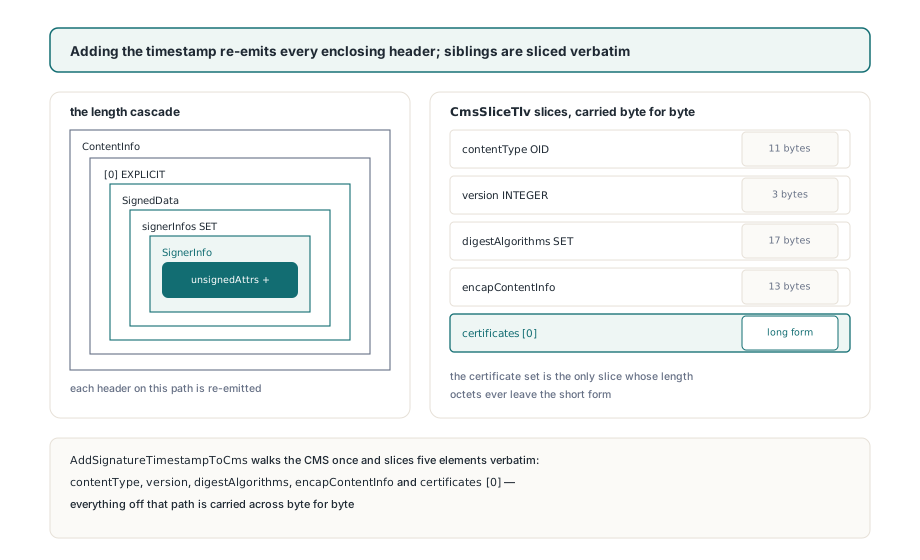
Добавление метки времени PAdES B-T заставляет каждый объемлющий заголовок CMS перекодироваться заново, тогда как пять соседних элементов обязаны перейти байт в байт. Атрибут метки времени подписи, определённый ETSI EN 319 122-1 в пункте 5.3 под OID 1.2.840.113549.1.9.16.2.14, живёт в unsignedAttrs SignerInfo из пункта 5.3 RFC 5652, а токен RFC 3161 внутри него вычисляется по значению подписи. Так что CMS уже построен и уже подписан, когда токен приходит от TSA. Один лишний атрибут удлиняет SignerInfo, что удлиняет SET signerInfos, затем SignedData, затем обёртку [0] EXPLICIT, затем внешний ContentInfo
В PDFium Component та последовательность — три экспортированных вызова в FPdfCms.pas и FPdfTsa.pas. SignPadesBytes прогоняет их за вас, когда TPadesSignOptions.Level — plB_T или выше и TsaUrl задан, и бросает EPadesCrypto, когда уровень B-T запрошен с пустым TsaUrl, вместо того чтобы записать обычную подпись B-B. Если вы собираете CMS сами через BuildSignedData, цепочка выглядит так:
// CmsDer держит ContentInfo, возвращённый BuildSignedData.
// SignPadesBytes выполняет те же три шага, когда Options.Level >= plB_T
var
  SigValue: TBytes;
  Ts: TPadesTimestamp;
begin
  if not ExtractSignatureValue(CmsDer, SigValue) then
    raise Exception.Create('CMS carries no signature value');
  // messageImprint TSA вычисляется по октетам значения подписи
  Ts:= RequestTimestamp(TsaUrl, SigValue, Nonce);
  // Перекодирует SignerInfo вплоть до ContentInfo, копирует соседей без изменений
  AddSignatureTimestampToCms(CmsDer, Ts.TokenDer);
end;
AddSignatureTimestampToCms переносит нетронутыми пять элементов: OID contentType, INTEGER версии SignedData, SET digestAlgorithms, SEQUENCE encapContentInfo и, когда есть, набор certificates [0]. В CMS, который BuildSignedData выпускает с SHA-256, четыре из них крошечные: 11 байт на OID, 3 на версию, 17 на набор алгоритмов digest, 13 на отсоединённый encapContentInfo. Набор сертификатов держит сертификат подписанта, за которым следует каждая цепочечная сертификата, что вы передали. Настоящий сертификат X.509 тянется на несколько сотен байт. Это та единственная вырезка, чьи октеты длины всегда пользуются длинной формой
Почему октеты длины DER нельзя читать назад?
Число октетов длины хранится в первом из них, а обратный обход встречает последнего первым. X.690, пункт 8.1.3.4, определяет короткую форму: один октет, бит 8 сброшен, биты 7–1 держат длину от 0 до 127. Пункт 8.1.3.5 определяет длинную форму. Её начальный октет имеет бит 8 выставленным, а биты 7–1 считают последующие октеты, держащие длину как беззнаковое big-endian целое. Ничто не помечает последующий октет как последующий. Его бит 8 — бит величины, как и остальные семь. Так что помощник, тестирующий старший бит Buf[ContentOffs- 1], тестирует данные и затем читает данные как счётчик
// Искушающий помощник, которому дали лишь смещение содержимого. Не выпускайте это
function NaiveHeaderStart(const Buf: TBytes; ContentOffs: Integer): Integer;
var
  P, LenByte: Integer;
begin
  P:= ContentOffs- 1;            // попадаем на ПОСЛЕДНИЙ октет длины
  if P< 0 then
    Exit(ContentOffs);
  LenByte:= Buf[P];
  if (LenByte and $80)= 0 then   // имеет смысл только для ПЕРВОГО
    Result:= P- 1
  else
    Result:= P- (LenByte and $7F)- 1;
end;

// A0 82 05 DC (1500 байт): Buf[ContentOffs- 1]= $DC, $DC and $7F= 92
//   Result= ContentOffs- 94, тег лежит в ContentOffs- 4
// A0 82 05 10 (1296 байт): у $10 бит 8 сброшен, читается как короткая форма
//   Result= ContentOffs- 2, что указывает на 05 внутри октетов длины
Оба направления отказа проявляются на обычных размерах. Набор сертификатов в 1500 байт кончает заголовок на DC, и помощник начинает вырезку на 90 байт раньше. Набор в 1296 байт кончает на 10, помощник принимает его за короткую форму длины, и вырезка стартует на два байта позже, вовсе без тега. Попадёт ли данная цепочка в первый случай или во второй, зависит не более чем от младшего байта её полной длины
Ранний случай может ещё и убежать за передний край буфера. Для CMS, разложенного так, как его раскладывает BuildSignedData, с каждым объемлющим заголовком длины в два октета, содержимое набора сертификатов начинается на 60-м байте: 4 на заголовок ContentInfo, 11 на OID, по 4 на заголовки [0] и SignedData, затем 3, 17 и 13 на мелких соседей и 4 на заголовок набора сертификатов. Вычтите 94 из 60 — и помощник вернёт -34. Его единственная страховка сидит на ContentOffs- 1, поэтому отрицательный результат уходит прямо в копирование
Что фиксирует пункт 10.1 X.690
DER делает кодирование длины чистой функцией самой длины. X.690, пункт 10.1, ограничивает DER определённой формой и требует минимального числа октетов, что убирает две вольности, которые позволяет BER: неопределённую форму и длинную длину, набитую ведущими нулевыми октетами. По тому правилу длина содержимого ниже 128 всегда берёт ровно один октет длины. Любая другая длина берёт один начальный октет плюс ровно столько последующих октетов, сколько значимых байтов у значения. Это даёт 81 80 для 128. На 256 заголовок растёт до 82 01 00, а 65536 требует 83 01 00 00. Код, уже держащий длину содержимого, может вычислить размер заголовка, не читая ни одного байта буфера
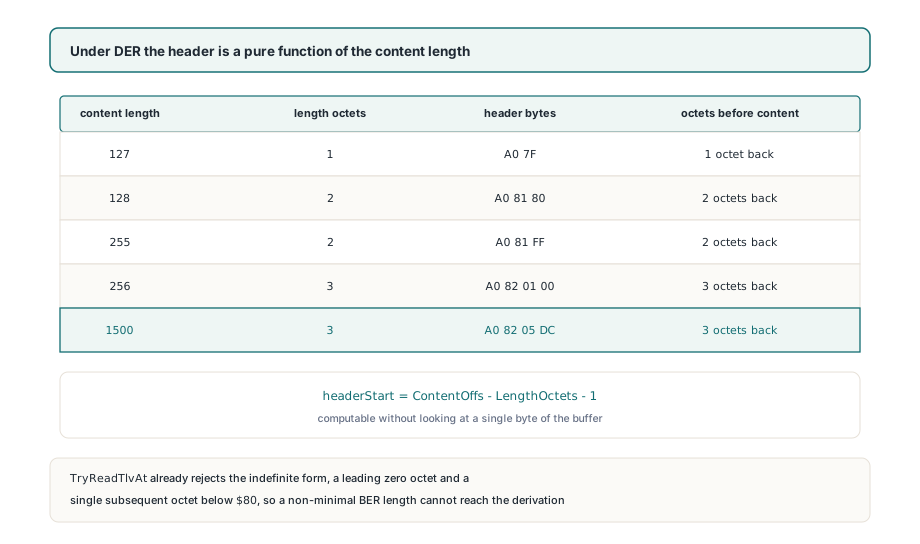
Вывод хорош ровно настолько, насколько верно утверждение, что вход — действительно DER. TDerReader.TryReadTlvAt навязывает то утверждение, прежде чем случится хоть одна вырезка. Она отвергает начальный октет длины $80 (неопределённая форма), длинную длину, чей первый последующий октет — ноль, одиночный последующий октет ниже $80, который должен был быть короткой формой, и более четырёх последующих октетов. ReadTlv построен на TryReadTlvAt, поэтому каждый элемент, по которому ходит AddSignatureTimestampToCms, уже прошёл те проверки. Набитая по-BER длина до арифметики не добирается
Внутри AddSignatureTimestampToCms смещение тега каждого соседа выводится из его смещения содержимого и длины содержимого вот так. Когда выведенный старт падает до начала буфера — то есть смещения не могут принадлежать друг другу, — процедура бросает исключение с сообщением CMS: TLV header precedes the buffer start и не производит никакого CMS. Кривая пересборка, которая всё ещё парсится, отслеживается куда труднее, чем исключение в точке, где смещения перестали сходиться
У вывода есть ещё одно допущение: идентификатор занимает один октет. X.690 разрешает многооктетные идентификаторы для номеров тегов 31 и выше, и TryReadTlvAt их парсит. CMS SignedData никогда их не использует, поскольку его теги — универсальные SEQUENCE, SET, INTEGER и OID плюс context-specific [0] и [1], так что допущение держится для каждого элемента, которого касается пересборка метки времени
Копирование соседних элементов в собственном DER-коде
Если пишете код против TDerReader, пропустите вывод вовсе. PeekTlv и ReadNextTlv заполняют record TDerTlv, чьё Offset уже указывает на тег, а HeaderLength — измеренный размер тега плюс октетов длины, и EncodedBytes возвращает элемент от Offset до NextOffset. Тот путь вдобавок справляется с многооктетными идентификаторами, которые никакая арифметика длины не вернёт. Четырёхвыходной ReadTlv удобен для спуска. Он докладывает, правда, только сторону содержимого, так что берите его, когда нужно содержимое, а record-форму — когда нужен весь элемент
// Каждый ребёнок SignedData как полный TLV: тег, октеты длины, содержимое.
// TDerTlv.Offset указывает на тег, поэтому никакая заголовочная арифметика не участвует
function SignedDataChildren(const CmsDer: TBytes): TDerByteArrays;
var
  Root, Ci, Explicit0, Sd: TDerReader;
  Tlv: TDerTlv;
begin
  Result:= nil;
  Root.Initialize(CmsDer);
  if not Root.ReadNextTlv(Tlv) or not Root.EnterConstructed(Tlv, Ci) then
    raise Exception.Create('ContentInfo SEQUENCE expected');
  if not Ci.SkipTlv then                            // OID contentType
    raise Exception.Create('contentType OID expected');
  if not Ci.ReadNextTlv(Tlv) or not Ci.EnterConstructed(Tlv, Explicit0) then
    raise Exception.Create('[0] EXPLICIT content expected');
  if not Explicit0.ReadNextTlv(Tlv) or not Explicit0.EnterConstructed(Tlv, Sd) then
    raise Exception.Create('SignedData SEQUENCE expected');
  while not Sd.AtEnd do
  begin
    if not Sd.ReadNextTlv(Tlv) then
      raise Exception.Create('SignedData child malformed');
    SetLength(Result, Length(Result)+ 1);
    Result[High(Result)]:= Sd.EncodedBytes(Tlv);   // например A0 82 05 DC ...
  end;
end;
Для случаев, когда какой-то другой API даёт вам не что иное, как смещение содержимого и длину, прямой вывод короток. DerHeaderStart, показанный со своей граничной проверкой в следующем разделе, — ваш собственный код; он зеркалит правило из пункта 10.1 и возвращает -1 для смещений, которые не могут быть согласованы, так что у вызывающего есть значение, которое можно отвергнуть, а не правдоподобный на вид стартовый байт
Почему короткие тестовые сертификаты скрывают ошибку?
Маленький сертификат-заполнитель держит набор сертификатов в короткой форме, и обратный обход корректен ровно для того случая. Набор в 32 байта кодируется как A0 20, в 64 байта — как A0 40. Шаг назад от содержимого садится на тот одиночный октет длины, а его старший бит сброшен, потому что он первый и единственный. Правильный ответ по неверной причине. Тест метки времени, построенный на таких маленьких сертификатах, может перепарсить результат, найти атрибут, доложить B-T — и ни разу не прогнать через вырезку набор сертификатов реалистичного размера
Любой кодовый путь, зависящий от того, как кодируется длина, нуждается в тестовом входе, пересекающем границу кодирования. Для DER это содержимое в 128 байт и больше, что вынуждает длинную форму, и в 256 байт и больше, что вынуждает второй последующий октет. Проверка ниже сравнивает DerHeaderStart с заголовком, измеренным ридером при парсинге, на обеих границах и на случае в 1500 байт из начала статьи. Несортированный SET OF в signedAttrs проскальзывает мимо round trip того же происхождения по той же структурной причине: тест подаёт лишь входы, на которых неверный код и верный сходятся
// Ваш собственный помощник для API, докладывающих лишь смещение и длину содержимого.
// Допускает однооктетный идентификатор — верно для каждого тега в CMS SignedData
function DerHeaderStart(ContentOffs, ContentLen: Integer): Integer;
var
  LengthOctets, Remaining: Integer;
begin
  LengthOctets:= 1;                  // короткая форма, X.690 8.1.3.4
  if ContentLen>= 128 then
  begin
    Remaining:= ContentLen;          // длинная форма, X.690 8.1.3.5
    while Remaining> 0 do
    begin
      Inc(LengthOctets);             // по одному на значимый байт
      Remaining:= Remaining shr 8;
    end;
  end;
  Result:= ContentOffs- LengthOctets- 1;
  if Result< 0 then
    Result:= -1;                     // несогласованные смещения: пусть вызывающий бросает
end;

// Граничная проверка, написанная как ваш собственный тестовый код: выведенное
// смещение тега обязано равняться смещению, измеренному TDerReader при парсинге заголовка
procedure CheckHeaderDerivation;
const
  Lens: array[0..6] of Integer= (127, 128, 255, 256, 1500, 65535, 65536);
var
  W: TDerWriter;
  R: TDerReader;
  Tlv: TDerTlv;
  Content: TBytes;
  I: Integer;
begin
  W:= TDerWriter.Create;
  try
    for I:= Low(Lens) to High(Lens) do
    begin
      SetLength(Content, Lens[I]);
      R.Initialize(W.Wrap($A0, Content));   // A0 7F / A0 81 80 / A0 82 05 DC ...
      W.Clear;
      if not R.PeekTlv(Tlv) then
        raise Exception.CreateFmt('unreadable TLV for %d bytes', [Lens[I]]);
      if DerHeaderStart(Tlv.ContentOffset, Tlv.ContentLength)<> Tlv.Offset then
        raise Exception.CreateFmt('header start wrong for %d bytes', [Lens[I]]);
    end;
  finally
    W.Free;
  end;
end;
Та же граница достижима насквозь через экспортированные функции. Подайте BuildSignedData цепочечные сертификаты, чей суммарный размер ставит набор сертификатов чуть ниже и чуть выше 128 и 256 байт, прогоните AddSignatureTimestampToCms на каждом результате, затем идите по выводу через SignedDataChildren и сравните элемент набора сертификатов побайтно с тем, что в CMS до добавления метки времени
Что принимает AddSignatureTimestampToCms
AddSignatureTimestampToCms написана для CMS, который выпускает BuildSignedData: один SignerInfo, опциональный набор certificates [0], без crls [1] и пока без unsignedAttrs. Скормите ей SET signerInfos с более чем одним SignerInfo — она бросит исключение вместо того, чтобы оставить первого подписанта и выбросить остальных. CMS с набором crls [1] останавливается на исключении CMS: signerInfos SET expected, потому что элемент после сертификатов — не тот SET, который ищет обход. Оба отказа случаются прежде, что-либо записывается обратно в CmsDer
Новый unsignedAttrs держит ровно один атрибут, так что правило упорядочения SET OF из пункта 11.6 X.690 удовлетворяется без сортировки. Подписанная часть SignerInfo, от версии до OCTET STRING подписи, копируется одним блоком, что означает: валидатор, заново считающий дайджест signedAttrs, видит одни и те же байты до и после добавления токена. Когда валидатор всё равно заворачивает документ, причины обычно сидят в другом и разобраны в этом чек-листе причин отказов PAdES. Что токен даёт со временем и как на нём строятся B-LT и B-LTA, — в разборе меток времени RFC 3161 и DSS
Ридер и райтер DER в FPdfAsn1.pas, строитель CMS и шаг метки времени в FPdfCms.pas — всё это исходники Pascal, поставляемые с PDFium Component for Delphi. Когда пересобранный SignedData отказывается парситься в валидаторе, вы можете прошагать код, вырезавший каждый элемент, и сверить его с пунктом X.690, на который тот ссылается