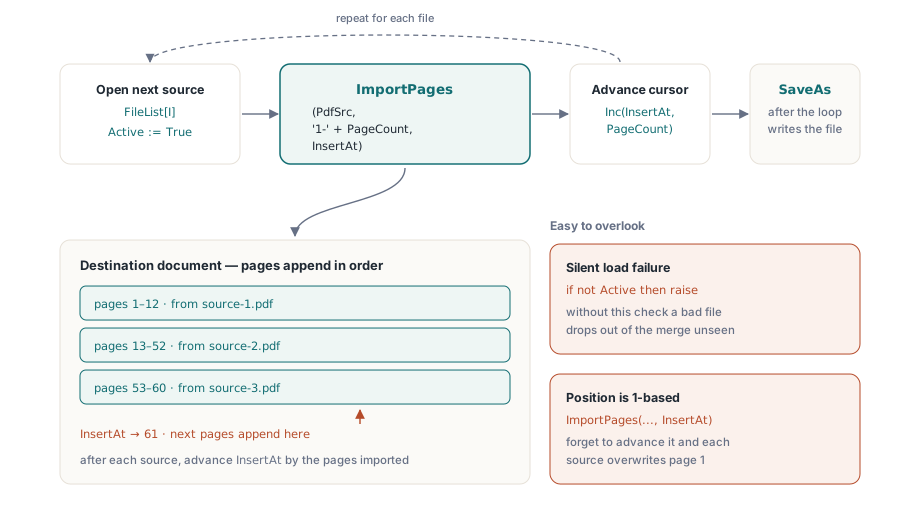
Цикл слияния, передающий 1 в качестве позиции вставки при каждом вызове, выдаёт файл с правильным числом страниц и документами в обратном порядке. Последний файл списка оказывается на странице 1, потому что позиция 1 значит «вставить перед текущей первой страницей», и каждый новый источник отодвигает предыдущие дальше. Ничего не потеряно — именно почему ошибка переживает быструю проверку числа страниц и всплывает, когда кто-то реально читает сборку
Постраничный цикл с ImportPages
PDFium Component собирает объединённый PDF в Delphi из двух экземпляров TPdf: целевого, созданного пустым через CreateDocument, и исходного, который по очереди открывает каждый входной файл. TPdf.ImportPages(Pdf, Range, PageNumber) копирует страницы, названные в Range, из Pdf в целевой и возвращает True при успехе. PageNumber отсчитывается с единицы и по умолчанию 1. Он называет позицию в целевом, куда ляжет первая импортированная страница, поэтому 1 — приставить спереди, а PageCount + 1 — дописать в конец
Чистейший способ держать файлы в порядке списка — вообще перестать вести курсор и спросить целевой, где его конец. Бегущий счётчик InsertAt тоже сработает, но его надо двигать на число реально импортированных страниц, а это число легко испортить, как только появляются диапазоны. PdfDest.PageCount + 1 прав всегда:
procedure MergeFileList(const FileList: TStrings; const OutputPath: string);
var
  PdfDest, PdfSrc: TPdf;
  I: Integer;
begin
  PdfDest := TPdf.Create(nil);
  PdfSrc  := TPdf.Create(nil);
  try
    PdfDest.CreateDocument;
    for I := 0 to FileList.Count - 1 do
    begin
      PdfSrc.FileName := FileList[I];
      PdfSrc.Active   := True;            // не бросает при неудаче
      if not PdfSrc.Active then
        raise Exception.CreateFmt('Cannot open %s', [FileList[I]]);

      // позиция с единицы: PageCount + 1 дописывает после последней страницы
      if not PdfDest.ImportPages(PdfSrc,
        '1-' + IntToStr(PdfSrc.PageCount), PdfDest.PageCount + 1) then
        raise Exception.CreateFmt('Page import failed for %s', [FileList[I]]);

      PdfSrc.Active := False;             // FileName можно менять только при неактивном
    end;

    if not PdfDest.SaveAs(OutputPath) then
      raise Exception.Create('Cannot write ' + OutputPath);
  finally
    PdfSrc.Free;
    PdfDest.Free;
  end;
end;
Две проверки в том цикле несут реальный вес. Установка Active := True никогда не бросает: если файл отсутствует, повреждён или требует пароль, TPdf перехватывает ошибку загрузки и оставляет Active в False. Компонент остаётся в согласованном закрытом состоянии, и форма не падает на плохом файле. Цикл слияния, пропустивший проверку, однако, просто выдаёт более короткий вывод. Вторая проверка — булев результат ImportPages, возвращающий False, когда строка диапазона не разобралась или позиция ушла за PageCount + 1. Заметьте также, что FileName и Password можно присваивать только при неактивном компоненте — почему источник закрывается внизу каждого прохода
Строки диапазонов: что принимает парсер
Аргумент диапазона — список через запятую из отдельных страниц и замкнутых промежутков, нумерованных с 1 в исходном документе. '1-3' берёт первые три страницы, '2,4,6' — три конкретные, а '1,3-5' — обложку плюс трёхстраничное резюме. Числа всегда относятся к источнику; куда эти страницы лягут в целевом, решает только позиционный аргумент
Открытые промежутки — где спотыкаются. Строка вроде '7-' выглядит как «страница 7 до конца», но парсер диапазонов PDFium требует оба конца промежутка и отвергает всю строку. То же с перевёрнутым промежутком ('5-3'), номером страницы 0 или любой страницей за числом страниц источника. Один плохой элемент валит весь вызов: ImportPages возвращает False, и ни одна страница из той строки не копируется. Поэтому цикл выше собирает '1-' + IntToStr(PdfSrc.PageCount), а не пишет '1-'
Когда индексы страниц уже лежат в массиве, ImportPagesByIndex(Source, PageIndices, InsertAt) пропускает строковый шаг. Только следите за сменой конвенции: там и индексы, и InsertAt отсчитываются с нуля, так что дописывание — это InsertAt = PdfDest.PageCount, а выборка «обложка плюс резюме» становится [0, 2, 3, 4]. Пустой массив импортирует все страницы
Есть ли слияние списка файлов одним вызовом?
Да. TPdf.MergeFiles(Sources, Options, Report) принимает массив записей TPdfBatchMergeSource, каждый из которых строится через TPdfBatchMergeSource.FromFile(FileName, PageRange, Password), открывает их по одному и заполняет TPdfBatchMergeReport тем, что произошло. Пустой PageRange значит все страницы. Синтаксис диапазонов — тот же формат «запятые и промежутки», а кривой диапазон становится ошибкой по файлу в отчёте, а не тихим пропуском
Дефолты из TPdfBatchMergeOptions.Default стоит знать до всякой правки. CreateDestination = True, поэтому неактивный целевой создаётся сам. InsertAt = -1 — значит дописать; любое другое значение — индекс с нуля, в ногу с ImportPagesByIndex, а не с ImportPages. ErrorPolicy = bmepStop, а RollbackOnCancelOrFailure = True, поэтому один нечитаемый файл заканчивает прогон и убирает каждую страницу, которую прогон добавил. CopyViewerPreferences копирует предпочтения просмотрщика первого источника, импортировавшегося успешно
procedure BuildBundle(const OutputPath: string; Log: TStrings);
var
  Dest: TPdf;
  Sources: TPdfBatchMergeSources;
  Options: TPdfBatchMergeOptions;
  Report: TPdfBatchMergeReport;
  I: Integer;
begin
  SetLength(Sources, 3);
  Sources[0] := TPdfBatchMergeSource.FromFile('cover.pdf');
  Sources[1] := TPdfBatchMergeSource.FromFile('annual-report.pdf', '1,3-5');
  Sources[2] := TPdfBatchMergeSource.FromFile('appendix.pdf', '', 'user-password');

  Options := TPdfBatchMergeOptions.Default;
  Options.ErrorPolicy := bmepSkip;        // идти дальше сквозь нечитаемые файлы

  Dest := TPdf.Create(nil);               // неактивный: MergeFiles создаст сам
  try
    if not Dest.MergeFiles(Sources, Options, Report) then
      raise Exception.Create('Merge failed: ' + Report.ErrorMessage);

    for I := 0 to High(Report.Issues) do
      Log.Add(Format('%s: %s',
        [Report.Issues[I].FileName, Report.Issues[I].MessageText]));
    Log.Add(Format('%d pages from %d of %d files',
      [Report.ImportedPageCount, Report.ImportedSourceCount, Report.SourceCount]));

    Dest.SaveAs(OutputPath);
  finally
    Dest.Free;
  end;
end;
Какую политику ошибок брать, зависит от того, что значит отсутствующий файл для вывода. Для пакета договора или прогона счетов сборка без одной из частей — неправильный документ: держите дефолтный bmepStop с откатом. Переключайтесь на bmepSkip только для подборок по остаточному принципу — например, еженедельного дайджеста отчётов — и тогда трактуйте bmrsCompletedWithErrors в Report.Status как то, на что обязан посмотреть человек. Что бы вы ни взяли, читайте Report.Issues: каждая запись несёт индекс источника, имя файла и сообщение — это отвечает на вопрос «кто виноват», который рукописный цикл отвечает собственными исключениями
Для долгих прогонов важны ещё две опции. OnProgress и CancellationToken позволяют интерфейсу показывать текущий файл и остановить прогон, а отменённый прогон откатывается как провалившийся. ResourcePolicy по умолчанию bmrpSourceScoped — импортирует выбранные страницы каждого источника одним нативным вызовом, так что шрифты и картинки, общие для тех страниц, копируются однажды. bmrpChunked импортирует партиями по PageChunkSize страниц, что даёт более тонкие точки отмены ценой повторного копирования общих ресурсов на каждую партию
Что несёт импортированная страница и что остаётся в источнике
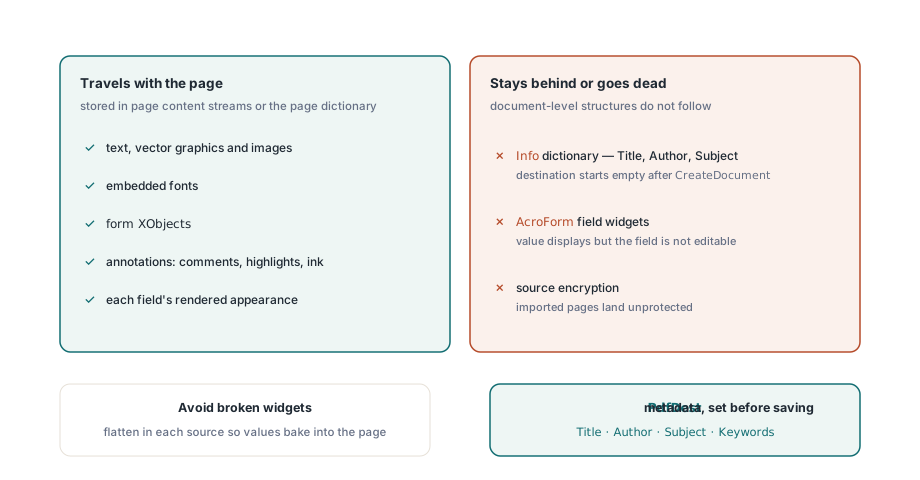
Импортированная страница приносит всё достижимое из своего словаря страницы: поток содержимого, шрифты, изображения и form XObjects в её ресурсах, и свои аннотации, включая комментарии, выделения и чернила. Всё, что живёт на уровне документа в источнике, не приходит, потому что ISO 32000-1 держит это вне дерева страниц
- Словарь информации о документе (ISO 32000-1 §14.3.3) остаётся позади, поэтому в объединённом файле нет ни Title, ни Author, ни Keywords источников. Свойства
TitleиAuthorуTPdfтолько для чтения — удобно для протоколирования того, что каждый источник объявил, прежде чем вы его закроете - Закладки (§12.3.3) при дефолтном
OutlinePolicy=bmopDiscardотбрасываются;bmopRejectпревращает источник с закладками в ошибку по файлу. Чтобы сохранить закладки, блокFPdfMergeдобавляетMergeFilesWithNavigation, который перестраивает закладки, переименовывает конфликтующие именованные назначения с префиксомImported_по умолчанию и перемаркирует ссылки между страницами; как переписываются те назначения — в статье редактирование закладок и перемаркировка страниц - Шифрование (§7.6) принадлежит файлу-источнику. Защищённый источник открывается со своим
Password, но целевой, созданныйCreateDocument, не зашифрован — как и страницы, скопированные в него. Если объединённый файл обязан быть защищён, пишите его черезSaveAsEncryptedвместоSaveAs
Почему поля форм перестают работать после слияния?
Поля форм разрезаны между двумя уровнями PDF. Виджет-аннотация, рисующая текстовое поле, сидит на странице, а само поле с именем и значением перечислено в массиве /Fields словаря интерактивной формы каталога (ISO 32000-1 §12.7.2). Нативный импорт страницы копирует виджет вместе с прочими аннотациями страницы, но никто не добавляет его в дерево полей целевого. Бокс всё ещё рисует последний вид. Зато просмотрщик, строящий модель форм из /AcroForm, не имеет поля, к которому прикрепить виджет, — значение не редактируется, и любая формная операция, идущая по дереву полей, его пропускает
TPdfBatchMergeOptions.FormPolicy даёт три ответа для простого слияния. bmfpPreserveNative — дефолт — оставляет нативный результат импорта, описанный выше. bmfpFlatten генерирует виды и сводит выбранные страницы каждого формоносного источника в памяти перед импортом, так что значения становятся обычным содержимым страницы; файл источника на диске не меняется. bmfpReject превращает любой источник с формой AcroForm или XFA в ошибку по файлу
Когда поля обязаны остаться заполняемыми, используйте MergeFilesWithForms из блока FPdfFormMerge. Он импортирует содержимое страниц, перестраивает виджеты из дерева полей каждого источника и прививает те поля к форме целевого. Имена полей — трудная часть. По §12.7.3.2 два поля с одинаковым полностью квалифицированным именем — одно поле и делят одно значение, поэтому поле Total в счёте и поле Total в накладной перезаписали бы друг друга. Дефолтный CollisionPolicy — pagcpReject, останавливающий слияние на первом же конфликте:
uses
  PDFium, FPdfCompress, FPdfFormMerge;

procedure MergeFillableForms(Dest: TPdf;
  const Sources: TPdfBatchMergeSources; Log: TStrings);
var
  Options: TPdfFormMergeOptions;
  Report: TPdfFormMergeReport;
begin
  Options := TPdfFormMergeOptions.Default;
  // Конфликтующие имена получают RenamePrefix ('Imported_', если не поменять)
  Options.GraftOptions.CollisionPolicy := pagcpRename;

  if Dest.MergeFilesWithForms(Sources, Options, Report) then
    Log.Add(Format('%d fields grafted, %d renamed',
      [Report.GraftedFieldCount, Report.RenamedFieldCount]))
  else
    Log.Add('Form merge failed: ' + Report.ErrorMessage);
end;
pagcpNamespace кладёт поля каждого источника под собственный префикс (Imported плюс номер источника), а pagcpMergeCompatible соединяет одноимённые поля, только когда их типы и опции совпадают. MergeFilesWithForms работает с источниками и целевыми AcroForm без полей подписи. XFA-формы и подписанные файлы он отвергает сразу, поскольку переписывание подписанного файла инвалидирует подписанный диапазон байтов из ISO 32000-1 §12.8.1. Открытый целевой также обязан быть незашифрованным: слияние в защищённый паролем файл проваливается, так что добавляйте защиту после — через SaveAsEncrypted. Страница, выбранная дважды в одном источнике, как в '1,1', требует явного RepeatedPagePolicy
Целевой документ подменяется только после того, как подготовленный результат переоткрыт и проверен. Имена полей, значения и типы сравниваются страница за страницей, и провалившееся слияние форм оставляет Dest как был. Глубже про обработку конфликтов — в статье прививка AcroForm между документами
Сохранение результата
SaveAs имеет перегрузку с файлом и перегрузку с TStream, обе берут необязательный TSaveOption (дефолт saNone) и TPdfVersion (дефолт pvUnknown, оставляющий заголовок библиотеке). Обе возвращают Boolean, и в пакетном задании тот результат заслуживает той же проверки, что Active. Закрепляйте версию чем-то вроде pv17 только когда нижестоящая система настаивает на конкретном заголовке
Обратная работа — нарезка одного файла на несколько — использует те же строки диапазонов и те же позиции с единицы; статья о нарезке проводит через неё
Импортированные здесь ImportPages, MergeFiles и формосознающее слияние поставляются с PDFium Component, приносящим эти операции над страницами в приложения Delphi и C++Builder