Откройте один и тот же PDF со счётом на Windows и на телефоне — переносы строк, шрифты и логотип встанут в одни и те же места. PDF-файл — это набор пронумерованных объектов плюс индекс байтовых смещений, и читатель вроде движка PDFium внутри PDFium Component открывает его с конца: startxref, таблица xref, каталог, дерево страниц, потоки содержимого, затем пиксели
Так что такое PDF-файл и почему он выглядит одинаково везде? Документы Word и RTF хранят текст и стили, оставляя раскладку машине, которая их открывает, поэтому пропавший шрифт или другой драйвер принтера перестраивает страницы. PDF вместо этого хранит готовый результат. У каждого глифа и каждой строки есть абсолютная позиция в координатном пространстве, измеряемом в пунктах, шрифтовые программы едут внутри файла, а изображения несут собственные данные о цвете и фильтры сжатия. Ничего не раскладывается в момент просмотра — вот почему любой корректный рендерер на любой операционной системе нарисует одну и ту же страницу. Формат начался как PDF 1.0 с Acrobat в 1993 году, построенный на модели изображения PostScript, и каждая ревизия добавляла часть описанной ниже механики:
- PDF 1.1–1.4 принесли шифрование, интерактивные формы, цифровые подписи с логической структурой и прозрачность
- PDF 1.5 добавил объектные потоки и потоки перекрёстных ссылок; PDF 1.6 добавил шифрование AES
- PDF 1.7 стал ISO 32000-1:2008, а PDF 2.0 стал ISO 32000-2:2017, с пересмотром 2020 года
- PDF/A (ISO 19005), PDF/X (ISO 15930) и PDF/UA (ISO 14289) ограничивают эту базу для архивирования, печатного производства и доступности
Что происходит, когда читатель открывает PDF-файл?
Открытие PDF — цепочка поисков, которая начинается с последних байтов файла и заканчивается растровым изображением. Почти каждое звено этой цепочки — словарь, один из базовых типов объектов в ISO 32000-1 §7.3, а словари указывают друг на друга косвенными ссылками вроде 7 0 R (объект 7, поколение 0). Поэтому файл ведёт себя как граф объектов, а не как последовательность страниц. Заголовок, тело, таблица перекрёстных ссылок и трейлер разложены по полочкам в обзоре структуры PDF-файла, а минимальный PDF с построчной разметкой показывает, как obj, endobj и stream выглядят в текстовом редакторе. Вот порядок, которому следует каждый читатель
- Выйти в конец файла и прочитать байтовое смещение, записанное после ключевого слова
startxref - Загрузить по этому смещению данные перекрёстных ссылок, отображающие каждый номер объекта в позицию в файле
- Прочитать трейлер и пойти по
/Rootк каталогу документа - Идти по записи
/Pagesкаталога вниз по дереву страниц к запрошенному объекту страницы - Декодировать поток содержимого страницы и интерпретировать его операторы по порядку
- Разрешить через
/Resourcesшрифты, изображения и form XObject, которые называют эти операторы - Растеризовать контуры, контуры глифов и изображения в пиксели с разрешением устройства
Шаг первый: startxref и таблица перекрёстных ссылок
Читатель никогда не сканирует PDF с начала. Корректный файл кончается ключевым словом startxref, десятичным числом вроде 48211 и %%EOF, и это число — байтовое смещение данных перекрёстных ссылок. Наивный обратный поиск по слову xref остановится внутри startxref, поэтому ищите полное ключевое слово. Классическая таблица использует записи фиксированной ширины (§7.5.4), что позволяет читателю прыгнуть к записи любого номера объекта, не разбирая остальные; байтовая компоновка каждой записи разобрана в обзоре структуры. Трейлер после таблицы называет /Size, /Root и опционально /Encrypt, /ID и /Prev
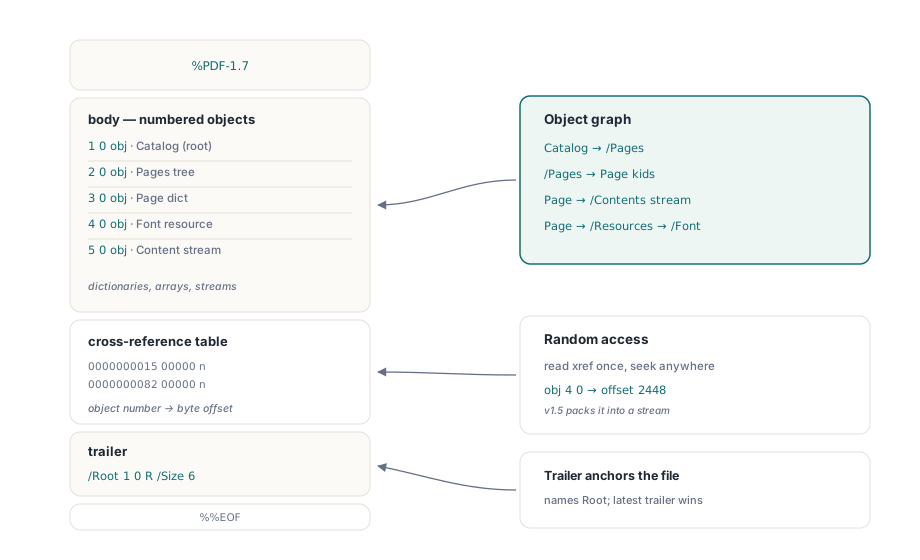
Каждая запись — абсолютная байтовая позиция, поэтому всё, что сдвигает байты, например редактор, переписывающий концы строк, оставляет индекс указывающим не туда. Читатели с проходом ремонта перестраивают индекс сканированием ключевых слов obj; читатели без него отвергают файл — вот почему повреждённый PDF может открыться в одном просмотрщике и отказать в другом. То, что сидит на смещении startxref, подскажет, какой у вас случай: ключевое слово xref — классическая таблица, заголовок N 0 obj — поток перекрёстных ссылок PDF 1.5, что-либо другое — устаревшее смещение. Хелпер ниже — ваш собственный код на обычных RTL-потоках
uses
  System.SysUtils, System.Classes;

// Ваш собственный хелпер: Offset — число, записанное после startxref.
// Классифицирует то, что читатель найдёт на этой позиции
function DescribeXrefAt(const FileName: string; Offset: Int64): string;
var
  FS: TFileStream;
  Buf: TBytes;
  Head: string;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if Offset >= FS.Size then
      Exit('offset beyond end of file: the file needs a repair pass');
    FS.Position := Offset;
    SetLength(Buf, 32);
    SetLength(Buf, FS.Read(Buf[0], Length(Buf)));
  finally
    FS.Free;
  end;
  Head := TEncoding.ASCII.GetString(Buf);
  if Head.StartsWith('xref') then
    Result := 'classic cross-reference table'
  else if Head.Contains(' obj') then
    Result := 'cross-reference stream (PDF 1.5 or later)'
  else
    Result := 'stale offset: the file needs a repair pass';
end;
Поток перекрёстных ссылок (§7.5.8) — сжатый объект с /Type /XRef, массивом /W, задающим ширину каждого столбца в байтах, и двоичными строками, указывающими либо на байтовое смещение, либо внутрь объектного потока (§7.5.7). Ключи трейлера переезжают в его словарь, поэтому в файле вообще нет ключевого слова trailer. HotPDF пишет эту форму, когда у THotPDF установлен UseXRefStream. Для файлов, покидающих вашу зону контроля, — вложений в почте или загрузок в типографию — классическая таблица остаётся более безопасным выбором, потому что читатели старше PDF 1.5 всё ещё её разбирают. Для архивов вопрос закрывает PDF/A-1: ISO 19005-1 построен на PDF 1.4, и его §6.1.4 гласит, что потоки перекрёстных ссылок не должны использоваться, поэтому HotPDF пишет классическую таблицу всякий раз, когда активен профиль PDF/A-1
48 0 obj
<< /Type /XRef /Size 49 /Root 1 0 R
   /W [1 3 1] /Index [0 49]
   /Filter /FlateDecode /Length 162 >>
stream
...binary rows: 1 + 3 + 1 bytes each...
endstream
endobj
startxref
48211
%%EOF
От /Root к нужной странице: каталог и дерево страниц
/Root трейлера указывает на каталог документа, а /Pages каталога — на корень дерева страниц. Каждый промежуточный узел /Pages несёт /Count листовых страниц под ним, поэтому читатель, ищущий страницу 5000, вычитает счётчики при спуске и пропускает целые поддеревья неоткрытыми. ISO 32000-1 §7.7.3 не требует сбалансированного дерева; единственный массив /Kids с 10 000 записей легален, просто медленнее в поиске. Код, читающий только лист, попадает в одну ловушку. /Resources, /MediaBox, /CropBox и /Rotate наследуемы (§7.7.3.4), поэтому страница без собственного /MediaBox всё равно валидна — значение живёт на предке
12 0 obj
<< /Type /Page
   /Parent 3 0 R
   /MediaBox [0 0 612 792]
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 13 0 R
>>
endobj
Медиабокс задаёт координатное пространство для всего нарисованного на странице: начало в левом нижнем углу, Y растёт вверх, единица равна 1/72 дюйма, если её не масштабирует PDF 1.6 /UserUnit. PDFium Component проделывает весь спуск, когда вы запрашиваете страницу по номеру. TPdf.PageMetrics возвращает размер страницы в пунктах с уже разрешёнными унаследованными боксами плюс поворот страницы, поэтому листинг ниже сообщает правильные размеры даже для файлов, чьи листовые страницы не несут собственного бокса
uses
  System.SysUtils, PDFium;

// Печатает число страниц и размер каждой страницы в пунктах
procedure ListPages(const FileName: string);
const
  Degrees: array[TRotation] of Integer = (0, 90, 180, 270);
var
  Pdf: TPdf;
  I: Integer;
  M: TPdfPageMetrics;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;           // разбирает данные xref, трейлер и каталог
    if not Pdf.Active then        // неудачная загрузка оставляет Active = False
      raise Exception.Create('Cannot open ' + FileName);
    Writeln(Pdf.PageCount, ' pages');
    for I := 1 to Pdf.PageCount do
    begin
      M := Pdf.PageMetrics[I];    // с 1; грузит страницу через дерево
      Writeln(Format('Page %d: %.1f x %.1f pt, /Rotate %d',
        [I, M.Width, M.Height, Degrees[M.Rotation]]));
    end;
  finally
    Pdf.Free;
  end;
end;
Как PDF рисует страницу на экране?
Видимое содержимое страницы — маленькая программа: постфиксные операторы в одном или нескольких потоках содержимого, интерпретируемые по порядку после того, как читатель запустит декодер, названный в /Filter, чаще всего /FlateDecode. BT открывает текстовый объект, Tf выбирает шрифтовой ресурс и размер, Td двигает текстовую позицию, Tj рисует строку, а ET закрывает объект. Контуры строятся операторами m, l, c и re, затем заливаются f или обводятся S. Графическое состояние (§8.4) хранит то, что эти операторы читают неявно: матрицу трансформации, цвета, путь отсечения. q кладёт копию в стек, Q снимает её, поэтому трансформация, выставленная внутри пары, не может протечь в последующий контент
q
1 0 0 1 72 700 cm     % сдвигает начало координат в (72, 700)
BT
  /F1 12 Tf           % шрифтовой ресурс F1 в 12 пунктов
  0 0 Td
  (Invoice 2026-0417) Tj
ET
0.2 0.2 0.8 RG        % цвет обводки, ограничен парой q/Q
0 -6 m 140 -6 l S
Q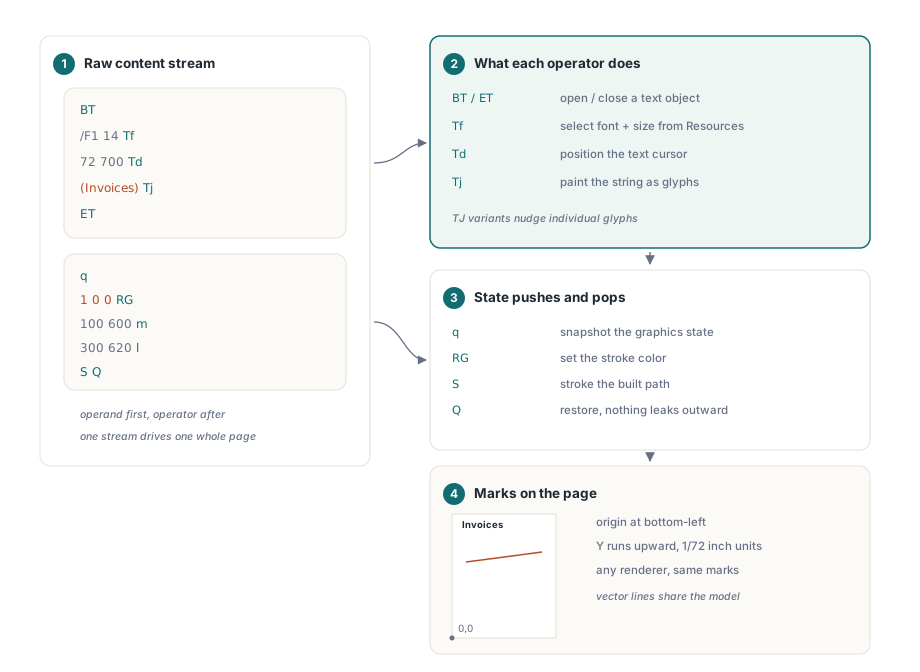
Имена вроде /F1 — ключи в /Resources страницы. Словарь шрифта ведёт через его дескриптор шрифта (§9.8) к встроенной шрифтовой программе, а изображение рисуется одним Do после декодирования его JPEG- или Flate-данных. Растеризация — последней. Рендерер применяет матрицу трансформации к каждому контуру и контуру глифа, отображает пункты в пиксели устройства и заливает результат со сглаживанием. Поскольку страница в этот момент всё ещё векторные данные, зум до 400 процентов заново прогоняет поток содержимого в большем масштабе вместо растяжения растра. Целевое разрешение выбирает вызывающий: 96 или 150 пикселей на дюйм для экрана, 300 и больше для печати. В PDFium Component эта стадия — TPdf.RenderPage, принимающая размер вывода в пикселях
uses
  System.SysUtils, Vcl.Graphics, PDFium;

// Рендерит страницу 1 файла FileName с разрешением Dpi пикселей на дюйм и сохраняет в BMP
procedure RenderFirstPage(const FileName: string; Dpi: Integer);
var
  Pdf: TPdf;
  Bmp: TBitmap;
  W, H: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;
    if not Pdf.Active then
      raise Exception.Create('Cannot open ' + FileName);
    Pdf.PageNumber := 1;        // с 1
    // PageWidth и PageHeight в пунктах (1/72 дюйма)
    W := Round(Pdf.PageWidth * Dpi / 72);
    H := Round(Pdf.PageHeight * Dpi / 72);
    Bmp := Pdf.RenderPage(0, 0, W, H, ro0, [reAnnotations]);
    try
      Bmp.SaveToFile(ChangeFileExt(FileName, '-p1.bmp'));
    finally
      Bmp.Free;                 // функциональная форма возвращает новый битмап
    end;
  finally
    Pdf.Free;
  end;
end;
Почему копипаст возвращает мусор, хотя страница выглядит нормально?
Копипаст ломается, когда файл записывает, какой глиф нарисовать, но не какой символ тот означает. Рендерингу нужны только формы глифов из встроенной шрифтовой программы. Извлечению нужен Unicode, который приходит из стандартной кодировки или CMap /ToUnicode в словаре шрифта (§9.10.3). Составной шрифт с /Encoding /Identity-H пишет сырые ID глифов прямо в поток содержимого, и без карты ToUnicode эти ID не имеют определённой связи ни с каким символом. Экран выглядит безупречно, пока буфер обмена заполняется символами. Сабсет-шрифты делают это вероятнее: они держат только глифы, которые использует документ, и легко опознаются по шестибуквенному префиксу в именах вроде /BaseFont /AAAAAA+ArialMT (§9.6.4). Руководство по работе со шрифтами в PDF подробно разбирает CJK-шрифты и сломанное извлечение
Инкрементные обновления и байтовый диапазон подписи
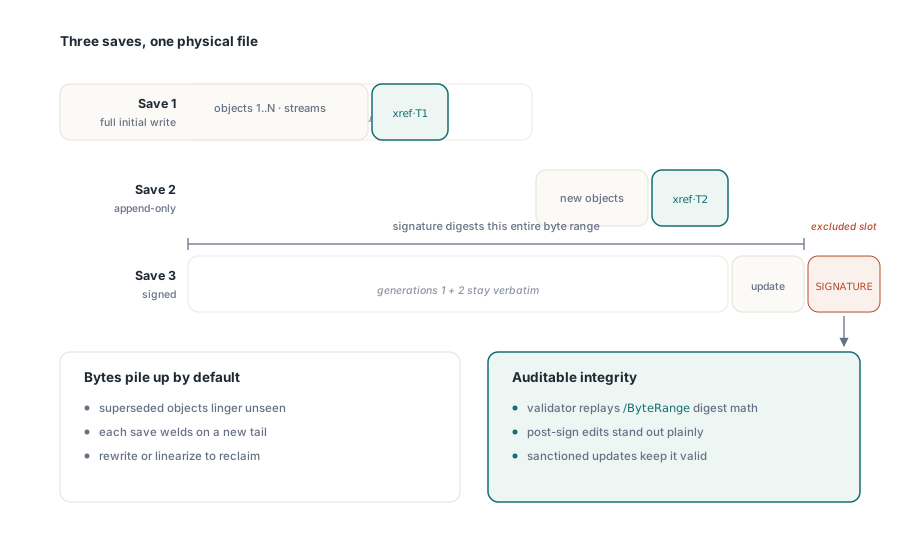
Подписи зависят от дописывающего способа правки PDF: инкрементное обновление (§7.5.6) добавляет объекты и новый раздел перекрёстных ссылок после последнего %%EOF, а обзор структуры объясняет цепочку /Prev и почему удалённый контент выживает в более ранних ревизиях. /ByteRange словаря подписи, записанный как [0 a b c], хеширует всё, кроме hex-строки /Contents, в которой лежит CMS-подпись, поэтому подписанная ревизия кончается на байте b + c, и валидатор восстанавливает её, обрезая файл там. Поздние ревизии садятся после этой точки, а полная перезапись, линеаризатор или проход оптимизации двигают байты, которые хешировал подписывающий, и разом аннулируют каждую существующую подпись
Когда Delphi- или Lazarus-приложению нужен весь этот конвейер — от разбора данных перекрёстных ссылок и прохода по дереву страниц до рендеринга и извлечения текста, — PDFium Component for Delphi and Lazarus оборачивает его в документный компонент TPdf из листингов выше и контрол просмотра TPdfView для показа на экране