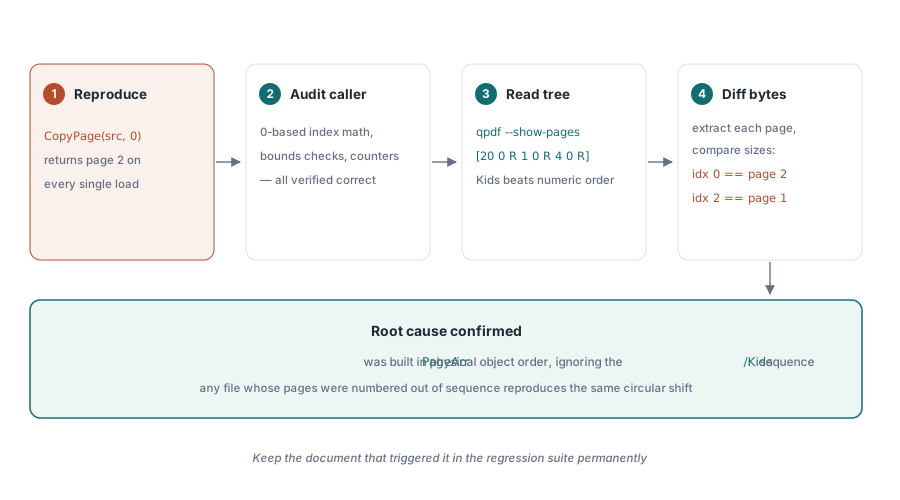
Классический симптом выглядит как ошибка на единицу: процедура копирования страниц запрашивает страницу 1 трехстраничного документа и стабильно получает страницу 2. Логика индексации в порядке. В вызове используется логический индекс с нулевой базой, арифметика верна, граничные условия соблюдены. И все же каждый раз выдается не та страница
Причина вовсе не в коде копирования. Она в том, как загрузчик строит массив страниц, и это одна из тех ловушек при разборе PDF, в которые проще всего попасть
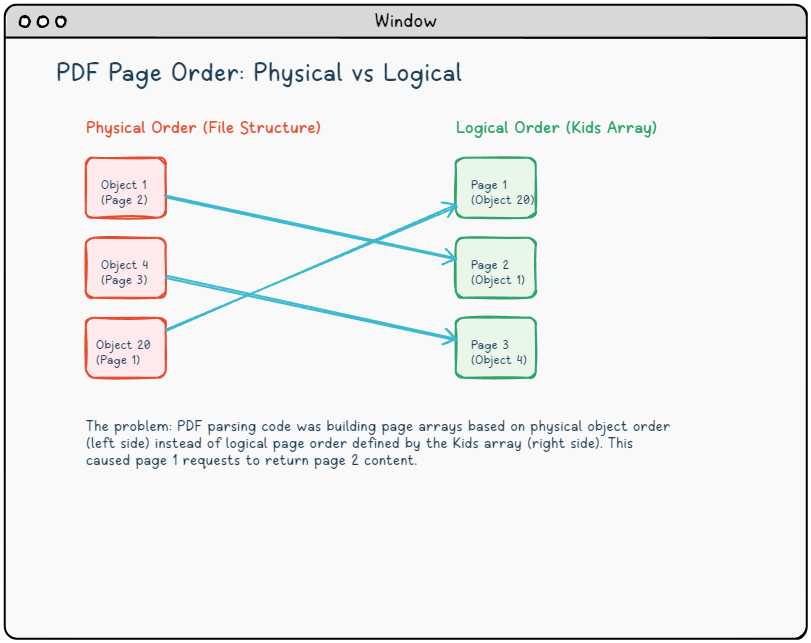
Два порядка, один источник путаницы
Файл PDF — это коллекция косвенных объектов, каждый из которых идентифицируется номером. Структура файла не обязывает эти номера отражать порядок чтения. Объект 1 может содержать страницу 2; объект 20 может содержать страницу 1. То, что на самом деле определяет порядок чтения, — это дерево страниц: иерархия словарей /Pages, чьи массивы /Kids перечисляют ссылки на страницы в той последовательности, в которой программа просмотра должна их отображать (ISO 32000-1 §7.7.3)
Вот дерево страниц, в котором и прячется эта ловушка:
{ Корень дерева Pages, объект 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
Случилось так, что объект 1 и объект 4 в потоке байтов файла находились перед объектом 20. Любой парсер, перебирающий косвенные объекты в физическом порядке файла и записывающий их в PageArr по мере обнаружения словарей типа page, поместит объект 1 под индексом 0, объект 4 под индексом 1 и объект 20 под индексом 2. Логическая страница 1 оказывается в PageArr[2]. Запрос страницы с индексом 0 извлекает вместо нее логическую страницу 2
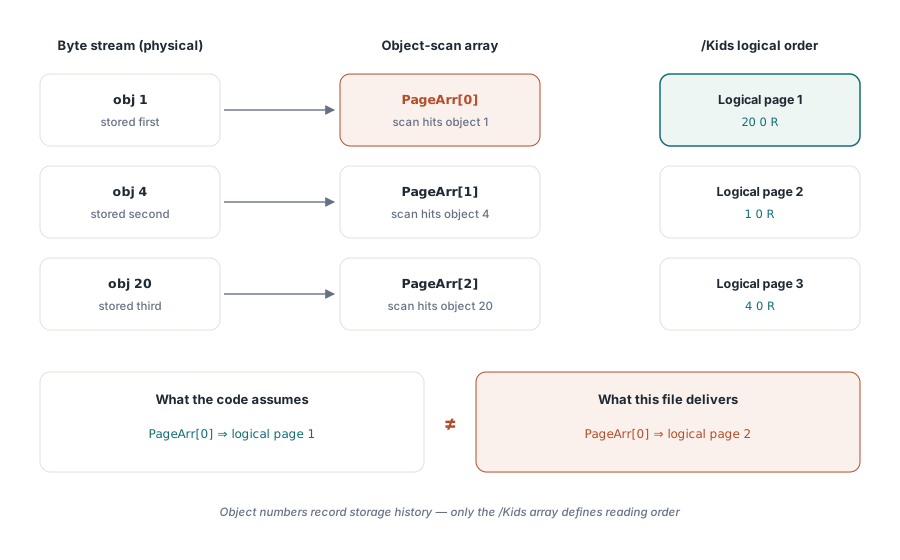
Подтверждение гипотезы
Прежде чем менять код, докажите несоответствие, а не полагайтесь на догадку. Утилита командной строки qpdf делает это совсем несложным:
{ shell }
qpdf --show-pages input.pdf
{ Вывод показывает порядок Kids: 20 0 R, затем 1 0 R, затем 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Показывает словарь Pages с /Kids в порядке чтения }
Извлечение каждой страницы по отдельности и сравнение размеров файлов подтверждает картину: то, что объектный скан выдает как PageArr[0], является содержимым логической страницы 2, а в PageArr[2] лежит логическая страница 1. Циклический сдвиг — неопровержимое доказательство. Он же объясняет, почему симптом проявляется на множестве разных исходных документов: любой PDF, в котором объекты страниц случайно получили номера меньше, чем у более ранней логической страницы, запускает эту ловушку
У этого состояния есть прямолинейное объяснение. Инкрементное обновление сохраняет номера объектов, которые оно меняет, но все, что оно добавляет, — например титульную страницу, вставленную в начало, — получает новый номер выше всех уже имеющихся в файле, а его ссылка попадает в начало массива Kids. Инструменты слияния или реорганизации документов перенумеровывают объекты в любом удобном им порядке. Некоторые генераторы просто записывают страницы в порядке, удобном для потоковой передачи контента, а не в логической последовательности страниц. Формат PDF не требует от них иного
Правильный подход: следовать массиву Kids
Стройте список страниц, проходя по цепочке /Kids от корневого каталога, а не сканируя косвенные объекты. Обход должен быть рекурсивным, поскольку большой документ обычно раскладывает страницы по промежуточным узлам /Pages, и он должен подстраховываться на случай поврежденного дерева, которое ссылается на одного из собственных предков. В наброске ниже TPdfDict и TPdfArray обозначают те типы словарей и массивов, которые использует ваш парсер:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // цикл или патологически глубокое дерево
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // переходим по косвенной ссылке
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // промежуточный узел
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // лист: следующая страница в порядке отображения
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Использование: начинаем с записи /Pages каталога
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Две детали сделаны намеренно. Лист без записи /Type все равно считается страницей, поскольку некоторые генераторы ее опускают, а программы просмотра открывают такие файлы. И финальное сравнение с /Count ничего не стоит, но ловит усеченные или редактированные вручную деревья до того, как вызывающий код начнет индексировать страницы
Если вы загружаете документы через HotPDF, этот порядок уже разрешен в момент загрузки: индексы страниц следуют порядку отображения дерева страниц, включая вложенные узлы /Pages, поэтому индекс 0 — это всегда первая страница, которую показывает программа просмотра. Обход, показанный выше, нужен тогда, когда структуру PDF разбирает ваш собственный код
Копирование по логическому индексу с CopyPageFromDocument
Поскольку HotPDF разрешает порядок страниц при загрузке, логические индексы означают именно то, чего ожидает вызывающий код. Высокоуровневая функция CopyPageFromDocument принимает логический индекс с нулевой базой и копирует правильную страницу в целевой документ:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Скопировать логическую страницу 0 (первую страницу, которую видит пользователь) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Поскольку индекс является индексом порядка отображения, CopyPageFromDocument ведет себя корректно даже с документами, где физический и логический порядки расходятся. Для пакетных операций InsertPagesFromDocument принимает массив логических индексов и копирует их за один проход
О чем это говорит при парсинге PDF
Спецификация PDF однозначна: логический порядок страниц определяется массивом /Kids дерева страниц, а не номерами объектов или смещениями байтов (ISO 32000-1 §7.7.3.2). Любой парсер, использующий иной порядок в качестве ярлыка, будет выдавать правильные результаты для большинства документов, с которыми сталкивается, поскольку большинство генераторов записывают страницы в естественном порядке и присваивают последовательные номера объектов. Ошибка скрывается до тех пор, пока кто-нибудь не загрузит PDF-файл, который был инкрементно отредактирован, реорганизован другим инструментом или сгенерирован программой, выбравшей другую компоновку
Тестирование только на самостоятельно сгенерированных PDF вообще пропускает этот класс проблем. Для обработки порядка страниц нужен корпус тестовых документов из разных источников: инкрементные сохранения, отсканированные документы со вставленными титульными страницами, PDF, созданные инструментами, которые иначе линеаризуют или оптимизируют граф объектов. Любой документ, у которого физический и логический порядки расходятся, заслуживает постоянного места в этом корпусе
Страница компонента HotPDF Delphi Component описывает весь API для операций со страницами, включая CopyPageFromDocument, InsertPagesFromDocument и MovePage