Две минуты на копирование трёх страниц из 40-страничного PDF — не задача настройки производительности. Это сигнал, что используется неверный путь API. Когда я впервые увидел это время на коде копирования страниц поверх HotPDF Delphi Component, инстинкт велел мне сначала смотреть на структуру документа и лишь потом на код. Этот порядок оказался обратным
Что на самом деле было медленным
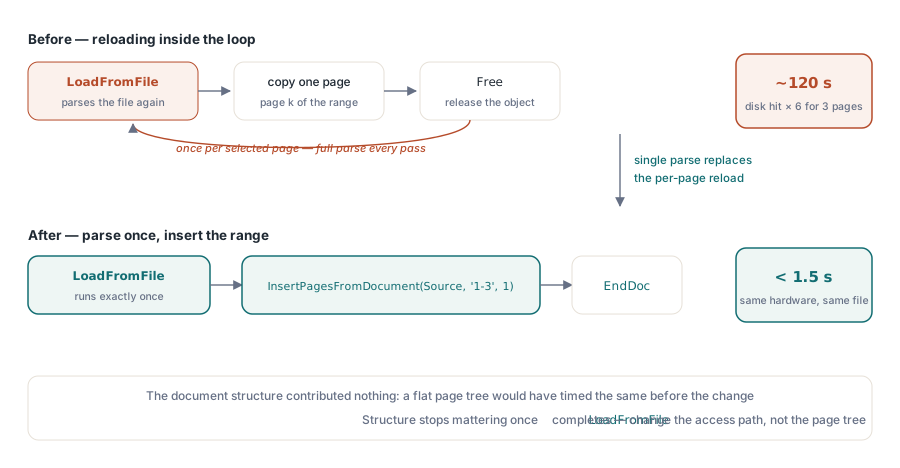
PDF, о котором идет речь, представлял собой 40-страничный справочный документ с нетривиальным деревом страниц: несколько промежуточных узлов /Pages вместо одного плоского массива. Оригинальный пример кода вызывал LoadFromFile, затем создавал новый документ с помощью BeginDoc, выполнял цикл по выбранным номерам страниц и на каждой итерации снова загружал исходный документ с диска, чтобы извлечь страницу. Это полная стоимость разбора, умноженная на столько страниц, сколько вы хотите. Файл размером 12 МБ обращался к диску шесть раз для извлечения трех страниц, потому что никто не посмотрел, нужно ли было файлу оставаться открытым между итерациями
Второй фактор был невидим в коде: LoadFromFile HotPDF строит объектную модель в памяти, на которой работает editing API. Для документа, который вы собираетесь изменять, это правильное поведение, но работы здесь больше, чем нужно, если вам требуется только количество страниц и их подмножество. Для доступа к структуре только на чтение DAOpenFileReadOnly избегает десериализации всего дерева объектов, что важно на сжатых файлах с большими ресурсами изображений
Обе сводятся к одному: API, созданный для одной задачи, использовался для другой
Использование ExtractPagesToFile для извлечения страниц
Правильный путь для копирования диапазона страниц из загруженного документа HotPDF в новый файл — ExtractPagesToFile, вызываемый после LoadFromFile источника. Вы грузите источник один раз, а вызов сам строит документ-адресат, копирует выбранные страницы в него и записывает на диск — всё из копии, уже находящейся в памяти:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Грузим источник один раз: полный разбор происходит здесь и только здесь
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Пишем запрошенный диапазон ('1-3', '1,5,7-9') прямо в новый файл
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
Параметр PageRange принимает тот же формат, что и образец командной строки: список номеров страниц или диапазонов через запятую, например '1-3' или '1,5,7-9'. Страницы отсчитываются от 1. ExtractPagesToFile копирует каждую выбранную страницу вместе с content streams и ресурсами, на которые она ссылается, поэтому для извлечения трех страниц из 40-страничного документа рабочий набор остается небольшим
Время на том же файле 12 МБ, который раньше работал две минуты: около 1,3 секунды с этим шаблоном. Большая часть этого времени — единственный вызов LoadFromFile. Структура документа не имеет значения, как только таблица объектов разрешена в первый раз
Когда LoadFromFile слишком много: Direct File API
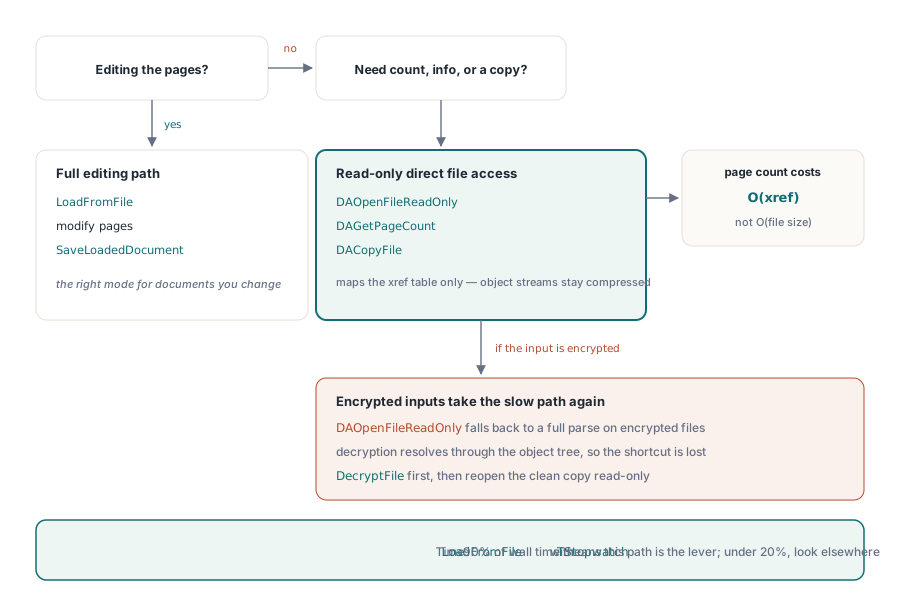
Если вам нужно только подсчитать страницы, проверить информацию о документе или скопировать файл, не затрагивая его содержимое, Direct File API вообще избегает полного анализа. DAOpenFileReadOnly отображает таблицу перекрестных ссылок без распаковки объектных потоков, поэтому количество страниц равно O (размер xref), а не O (размер файла):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile — это копирование с сохранением байтов, без повторной сериализации
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Предостережение: DAOpenFileReadOnly принимает параметр пароля, но возвращается к полному синтаксическому анализу для зашифрованных входов, поскольку для расшифровки требуется дерево объектов для разрешения словаря шифрования. Если исходные файлы зашифрованы, сначала расшифруйте их с помощью DecryptFile, чтобы получить незашифрованную копию, а затем откройте ее с помощью Direct File API. Функция DecryptFile уровня файла использует прямой путь перезаписи AES-256 для стандартного шифрования и выполняется быстрее, чем LoadFromFile, за которым следует SaveLoadedDocument для больших файлов, поскольку она не строит полную объектную модель в памяти
Память во время крупносерийной обработки
Пакетные задания, обрабатывающие десятки файлов в цикле, имеют схему, которая выглядит правильно, но накапливает память: создание THotPDF внутри цикла, вызов LoadFromFile, выполнение работы, вызов Free. Конструктивно это прекрасно. Проблема возникает, когда внутренняя работа распределяет рабочие объекты, перехватывает исключения и оставляет эти рабочие объекты активными в путях ошибок. Диспетчер памяти Delphi не выполняет сжатие, поэтому сотня утечек путей ошибок за весь пакетный запуск может привести к тому, что объем памяти возрастет настолько, что замедлит распределение для всего остального
Исправление не является экзотическим. Каждый THotPDF и каждый промежуточный TStream или TBitmap, участвующий в работе с PDF, принадлежит к блоку try/finally, где Free является последним утверждением. Установите локальные указатели на nil перед try, чтобы ветвь finally могла безопасно использовать if Assigned(x) then x.Free, если инициализация не удалась на полпути. Это стандартная дисциплина владения Delphi, и это полная история для этого класса проблем
Ещё одно, что стоит знать в пакетных контекстах: AddImage регистрирует каждое изображение в строящемся документе, и HotPDF снимает эти регистрации, когда EndDoc завершает этот файл. Реестр следует циклу BeginDoc/EndDoc, а не LoadFromFile, поэтому чистый шаблон для пакета — один экземпляр THotPDF на документ: создать, сделать работу, сохранить, освободить
Измерение перед внесением изменений
Прежде чем тянуться к любому из этих шаблонов, измерьте. TStopwatch Delphi из System.Diagnostics оборачивает QueryPerformanceCounter и достаточно точен для профилирования файлового ввода-вывода по фактическому времени. Оберните только LoadFromFile и посмотрите, сколько он занимает. Если это 90% общего времени, исправлением будет API Direct File или уменьшение количества синтаксических анализов одного и того же файла. Если это меньше 20%, узкое место находится где-то в другом месте, и вы гоняетесь не за тем, что нужно
Двухминутное извлечение, с которого начался этот пост, оказалось целиком повторяющейся загрузкой. Структура документа не внесла никакого вклада; плоское дерево страниц работало бы так же. Переход к одному LoadFromFile с одним последующим вызовом ExtractPagesToFile снизил время до примерно 1,3 секунды на том же оборудовании, не трогая ничего другого
API управления страницами, показанный здесь, является частью HotPDF Delphi Component для Delphi и C++Builder