Две копии одной квартальной книги могут показывать в ячейке D2 одни и те же 1,250.00 и при этом расходиться в том, что эта ячейка такое: в одной это введённый литерал, в другой — =SUM(A2:C2). Рецензент, переключающийся между файлами, видит одинаковые экраны. Побайтовое сравнение двух .xlsx-пакетов скажет обратное и объявит разным почти всё, потому что zip-архив, записанный дважды, редко совпадает байт в байт. Ни та ни другая проверка не отвечает на вопрос, который люди после раунда рецензирования задают на самом деле: какие ячейки, формулы и листы изменились
Вопрос этот всплывает в нескольких предсказуемых местах. Финансовая книга возвращается после проверки, ночной экспорт перегенерирован после изменения кода, или два отдела присылают свои правки одного шаблона. Сверка бок о бок хороша для одного листа и беспомощна для двадцати, а промахиваются уставшие глаза ровно по показанной выше подмене формулы литералом
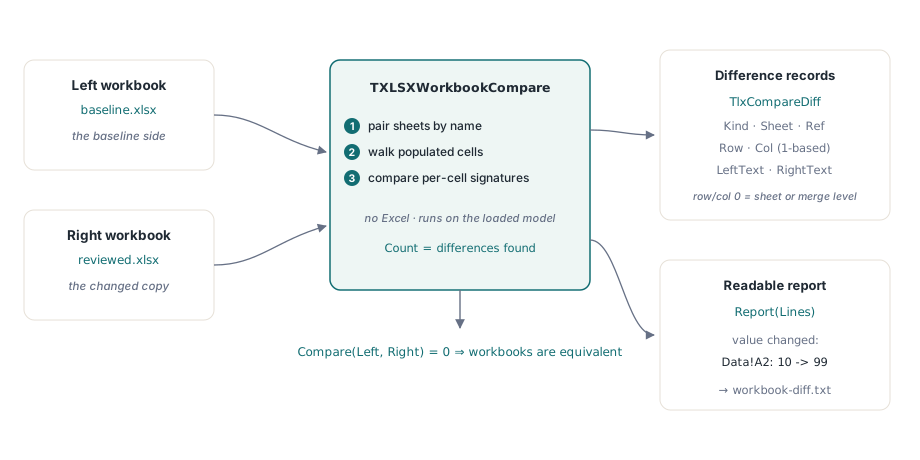
Сравнение двух книг через TXLSXWorkbookCompare
HotXLS сравнивает книги через TXLSXWorkbookCompare из модуля lxCompare. Compare(Left, Right) принимает два загруженных объекта TXLSXWorkbook и возвращает число найденных различий. Список различий затем доступен по индексу через Diff(I) и Count, а Report дописывает в любой TStrings по одной читаемой строке на различие. Excel не участвует ни на каком шаге: сравнение идёт по объектной модели, которую HotXLS уже загрузил, поэтому одинаково работает в консольной задаче, службе или приложении C++Builder
uses
  SysUtils, Classes, lxHandleX, lxCompare;

var
  Left, Right: TXLSXWorkbook;
  Cmp: TXLSXWorkbookCompare;
  Lines: TStringList;
begin
  Left := TXLSXWorkbook.Create;
  Right := TXLSXWorkbook.Create;
  Cmp := TXLSXWorkbookCompare.Create;
  Lines := TStringList.Create;
  try
    // Open возвращает 1 при успехе; при неудачном открытии надо остановиться здесь,
    // иначе будут сравнены пустые книги и результат не будет ничего значить
    if Left.Open('baseline.xlsx') <> 1 then
      raise Exception.Create('cannot open baseline.xlsx');
    if Right.Open('reviewed.xlsx') <> 1 then
      raise Exception.Create('cannot open reviewed.xlsx');

    if Cmp.Compare(Left, Right) = 0 then
      Writeln('workbooks are equivalent')
    else
    begin
      Cmp.Report(Lines);              // одна читаемая строка на различие
      Lines.SaveToFile('workbook-diff.txt');
      Writeln(Format('%d difference(s) written', [Cmp.Count]));
    end;
  finally
    Lines.Free;
    Cmp.Free;
    Right.Free;
    Left.Free;
  end;
end;
Явные проверки открытия значат больше, чем кажется. Compare возвращает 0 и чистит свой список, если любой из аргументов — nil, а две пустые книги тоже сравниваются как равные, поэтому нулевой результат означает "эквивалентность", только когда оба файла реально загрузились. Типичная строка в workbook-diff.txt выглядит как value changed: Data!A2: 10 -> 99
Что считается различием по умолчанию?
Без установленных опций TXLSXWorkbookCompare сообщает о восьми видах различий: лист добавлен или удалён, ячейка добавлена или удалена, значение изменилось, формула изменилась, объединённый диапазон добавлен или удалён. Значения перечисления — lckSheetAdded, lckSheetRemoved, lckCellAdded, lckCellRemoved, lckValueChanged, lckFormulaChanged, lckMergeAdded и lckMergeRemoved. Всё меряется относительно левой книги как базовой, поэтому добавленный элемент существует только справа, а удалённый — только слева
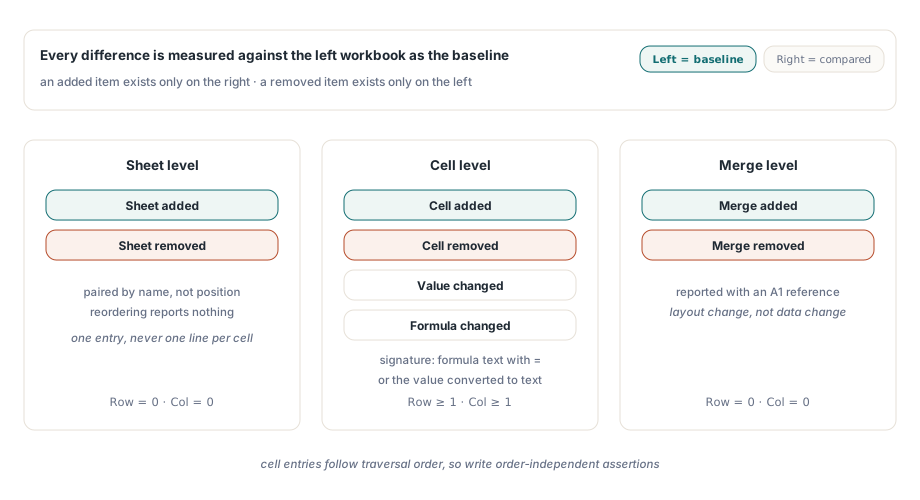
Листы сводятся по имени, причём совпадение без учёта регистра: Data слева сходится с DATA справа. Перетаскивание вкладки на новое место поэтому не даёт ни одной записи. Переименование листа — другая история: Q3, переименованный в Q3 Final, выдаёт строку sheet removed и строку sheet added, потому что в файле никак не записано, что это один и тот же лист. Лист, существующий только с одной стороны, даёт одну запись уровня листа, а не по строке на каждую ячейку внутри, что сохраняет читаемость отчёта, когда две книги различаются структурой
Ячейки сводятся по позиции. Сравнение обходит сохранённые ячейки каждого сопоставленного листа, и это включает ячейки, хранящие только форматирование. Отформатированная, но пустая ячейка, которая есть слева и которой нет справа, сообщается как cell removed: Data!C4 was (blank). Объединённые диапазоны сравниваются по своему тексту A1, поэтому A1:D1, расширенный до A1:E1, даёт один merge removed и один merge added
Почему формула и литерал с тем же числом сообщаются как изменение?
Потому что формула — это авторское содержимое. Когда хотя бы одна сторона пары ячеек держит формулу, TXLSXWorkbookCompare сравнивает текст формулы, и формула с одной стороны против литерала с другой — это запись lckFormulaChanged, даже если обе показывают 1,250. Строка отчёта для примера из начала статьи: formula changed: Data!D2: 1250 -> =SUM(A2:C2), а запись несёт LeftKind = lcvNumber и RightKind = lcvFormula. Текст формулы сравнивается ровно в том виде, в каком хранится, с ведущим знаком равенства, добавляемым для отображения
Литералы сравниваются как введённые значения. Число сравнивается с числом, текст с текстом, а число 10 против текста "10" — это изменение, даже если обе ячейки печатают одни и те же символы. Отчёт показывает метки типов, когда виды различаются: value changed: Data!B7: [number] 10 -> [text] 10. Такой случай обычен для файлов, прошедших через CSV-циклы или пользовательский copy-paste, и именно он позже ломает функции поиска
Формула с неизменным текстом по умолчанию не сообщает ничего, даже если её кешированный результат разошёлся. Для рецензирования авторского содержимого это правильно. Для регрессионного тестирования генератора — слишком мягко, ведь изменившийся лист входных данных может сдвинуть все итоги, не тронув ни одной формулы. Установка lcoFormulaCachedResults в Options добавляет запись lckFormulaCacheChanged всякий раз, когда кешированные результаты различаются, или когда у одной стороны кешированное значение есть, а у другого его нет — такое сообщается как (missing cache). Для регрессионных тестов генератора включайте эту опцию: итог, дрейфующий при неизменных формулах, — ровно та ошибка, ради которой такие тесты существуют
Кешированные результаты свежи ровно настолько, насколько свеж последний расчёт, поэтому когда вопрос звучит как "что эти формулы выдают сегодня", сначала пересчитайте обе книги. TXLSXWorkbook.Recalculate возвращает lxOk при успехе; с выключенными итерациями ссылочный цикл даёт lxErrorRef. Второй источник ложных тревог — шум плавающей точки, и SetNumericTolerance(AbsoluteTolerance, RelativeTolerance) обрабатывает его одинаково для числовых литералов и кешированных результатов:
uses
  SysUtils, lxCalc, lxHandleX, lxCompare;

function CompareGeneratedReport(Expected, Actual: TXLSXWorkbook;
  Cmp: TXLSXWorkbookCompare): Integer;
begin
  // Обновите оба кеша перед сравнением результатов
  if (Expected.Recalculate <> lxOk) or (Actual.Recalculate <> lxOk) then
    raise Exception.Create('recalculation failed');

  Cmp.Options := [lcoFormulaCachedResults];
  // 1e-9 абсолютная или 1e-12 относительная; обе должны быть конечными
  // и неотрицательными, иначе выбрасывается EArgumentException
  Cmp.SetNumericTolerance(1e-9, 1e-12);

  Result := Cmp.Compare(Expected, Actual);
end;
Допуски по умолчанию нулевые, то есть точное сравнение. Применяются они только к числам. Даты, геометрия строк и столбцов и стили всегда сравниваются точно, так что допуск, настроенный под округление валют, никогда не спрячет дату, съехавшую на секунду
Управление логикой через структурированные отличия
Каждая запись TlxCompareDiff открывает Kind, Sheet, единичные Row и Col, ссылку A1 в Ref, LeftText и RightText, а для записей уровня ячейки — LeftKind и RightKind. Записи уровней листа и объединения несут ноль в Row и Col. Стоит включить необязательные проверки — записи геометрии строк несут только строку, записи геометрии столбцов только столбец, а признаки уровня книги вроде именованных диапазонов не несут ни того ни другого, поэтому ветвьтесь по Kind, а не по нулевым координатам:
var
  I, FormulaEdits: Integer;
  D: TlxCompareDiff;
begin
  FormulaEdits := 0;
  for I := 0 to Cmp.Count - 1 do
  begin
    D := Cmp.Diff(I);
    case D.Kind of
      lckFormulaChanged:
        begin
          Inc(FormulaEdits);
          Writeln(Format('%s!%s: %s => %s',
            [D.Sheet, D.Ref, D.LeftText, D.RightText]));
        end;
      lckValueChanged:
        if D.LeftKind <> D.RightKind then
          Writeln('type change: ' + D.Describe);
      lckSheetAdded, lckSheetRemoved:
        Writeln('structure: ' + D.Describe);
      lckMergeAdded, lckMergeRemoved:
        Writeln('layout: ' + D.Describe);
    end;
  end;

  // Политика проверки, блокирующая только на изменениях формул
  if FormulaEdits > 0 then
    raise Exception.CreateFmt(
      '%d formula change(s) need sign-off', [FormulaEdits]);
end;
Порядок списка фиксирован. Compare сортирует различия по имени листа, затем по строке, столбцу, виду и ссылке, поэтому два прогона на одной паре файлов дают одинаковый текст отчёта построчно. Имена листов сортируются обычным строковым сравнением, а не по позиции вкладки, и записи с нулевой строкой идут первыми внутри группы листа. Поэтому текст отчёта — честный 'golden file' для регрессионного теста: положите ожидаемый workbook-diff.txt в репозиторий и валите сборку, когда новый разойдётся. Для решений политики читайте поля записи напрямую, а описательную строку оставьте людям
Включение проверок форматирования, геометрии и объектов
Набор по умолчанию — сравнение данных, и ячейка, у которой числовой формат съехал с General на Currency, при нём не сообщает ничего. Свойство Options расширяет сравнение по одной категории за раз. lcoCellStyles сравнивает итоговый стиль каждой сопоставленной ячейки, а lcoBlankStyleRegions делает то же для отформатированных областей без сохранённых ячеек, склеивая соседние различия в прямоугольники, чей дальний угол сидит в LastRow и LastCol. lcoAxisGeometry сравнивает высоты строк и ширины столбцов вместе со скрытостью, уровнем структуры и свёрнутостью. lcoRichTextRuns сравнивает форматированные фрагменты внутри текстовых ячеек
Содержимое уровня объектов имеет собственные переключатели: lcoDefinedNames, lcoDataValidations, lcoConditionalFormats, lcoTables, lcoDrawings (куда входят и картинки внутри ячеек), lcoPivotTables, lcoPivotCaches, lcoSlicerState и lcoTimelineState. Такие записи кладут в Ref 'ключ' признака и сообщают через Change, добавлен он, удалён или изменён. Именованные диапазоны, кеши сводных таблиц и кеши slicer и timeline уровня книги несут пустой Sheet
Читайте вывод этих проверок с правильными ожиданиями. Записи стилей, rich text и признаков сообщают в LeftText и RightText дайджесты SHA-256 нормализованного определения, так что отчёт говорит, что у ячейки C5 сменился стиль, но не какое свойство. Записи геометрии читаемы, например size=15; hidden=0; outline=0; collapsed=0, а строка без явной высоты сравнивается по стандартной высоте листа, так что явные 15 пунктов совпадут с неустановленной высотой, если стандартная тоже 15. Для проверки содержимого держите lcoCellStyles выключенным. На большой книге он превращает каждый переформатированный столбец в стену хешей, за которой прячутся три правки ячеек, на согласование которых звали рецензента
// Проверка макета: только геометрия, объединения и условные форматы
Cmp.Options := [lcoAxisGeometry, lcoConditionalFormats, lcoDataValidations];
// Ограничьте, что проверки объектов могут захватить: 32 МиБ, 500 000 элементов
Cmp.SetFeatureLimits(32 * 1024 * 1024, 500000);
try
  Cmp.Compare(Left, Right);
except
  on E: EXLSXSemanticBudget do
    Writeln('workbooks too large for this check: ' + E.Message);
end;
Проверки объектов захватывают свои определения перед сравнением, и SetFeatureLimits ограничивает это захват. По умолчанию это 67 108 864 байта и 1 000 000 элементов; превышение любого из пределов выбрасывает EXLSXSemanticBudget. Когда Compare выбрасывает, список различий от предыдущего успешного вызова остаётся на месте, поэтому вызывающий, поймавший исключение, не должен читать Count как результат неудавшегося прогона
Даты, вставленные строки и где сравнение окупается
Ячейки, которые книга держит как даты, сравниваются как даты, точно, и печатаются как date(...) с лежащим в основе числовым значением даты. Дата с одной стороны против простого числа с другой показывает метки видов — обычный признак того, что колонка потеряла формат даты по пути через какой-то другой инструмент. Ловушка здесь — смешанные системы дат. Книга в системе дат 1904 и книга в системе 1900 хранят один и тот же календарный день серийными номерами с разницей в 1 462, поэтому проверяйте Date1904 с обеих сторон, прежде чем доверять колонке изменений дат. Подложка описана в статье серийные номера дат и система 1904
У позиционного сведения есть одно следствие, которое стоит планировать заранее. Вставьте строку у верха листа — и каждая ячейка ниже съедет, так что сравнение сообщит цепочку изменённых, добавленных и удалённых ячеек вниз по листу, а формулы, чьи ссылки были переписаны вставкой, сообщатся как изменённые. Когда конвейером управляете вы, выполните одно сравнение до структурной правки и одно после, чтобы каждый отчёт покрывал один тип изменений. Правила перезаписи описаны в статье корректировка ссылок формул при вставке и удалении
Три задачи оправдывают подключение этой функции. Регрессионное тестирование генератора отчётов: держите заведомо корректную книгу, перегенерируйте, сравните с включёнными кешированными результатами и падайте на любом различии. Проверка изменений: вручите рецензенту отсортированный отчёт вместо двух файлов. Проверки миграции: после конвертации партии устаревших книг сравните каждый результат с его источником, затем подсчитайте форматирование и признаки объектов с каждой стороны проходом инвентаризации из статьи рабочее место аудита и конвертации книг
Сравнение, пересчёт и конвертация делят один движок в HotXLS для Delphi и C++Builder, а на странице HotXLS Delphi spreadsheet component перечислено остальное из того, что этот движок читает и пишет