Отчётное задание исправно работает год. Оно собирает книгу, наполняет лист тем, что вернул запрос, и сохраняет его. Потом клиент с пятилетней историей просит полную выгрузку, число строк переваливает за миллион, и процесс умирает с ошибкой нехватки памяти задолго до того, как файл доберётся до диска. С кодом всё было в порядке. Он держал книгу целиком в оперативной памяти, чтобы сериализовать её в конце, и нужный ему объём памяти рос вровень с числом строк, которое ему велели записать
Лечится это не более мощной машиной. Лечится другой моделью записи. Потоковый прямой писатель в HotXLS выдаёт пакет OOXML постепенно, по мере поступления строк, поэтому используемая им память не зависит от того, сколько строк вы пишете. Это парный к потоковому читателю инструмент на стороне записи: читатель обходит огромный лист, не строя дерева ячеек, а писатель создаёт такой лист, тоже не строя дерева ячеек
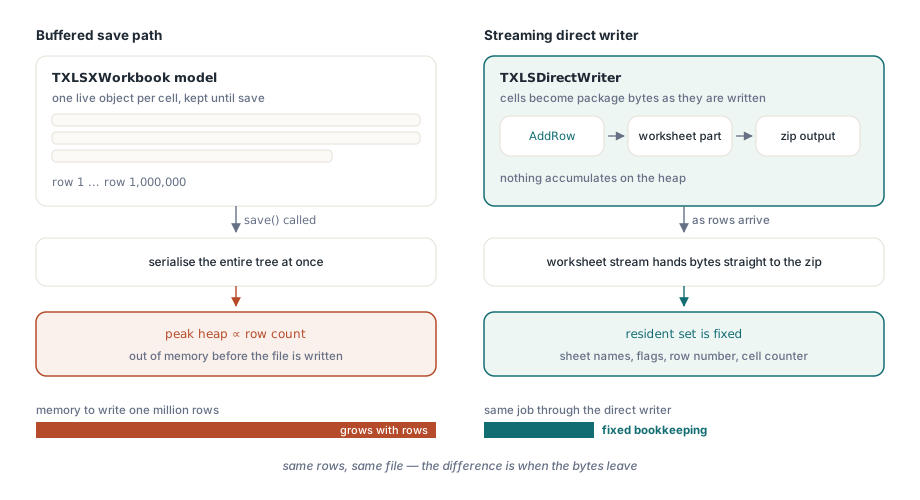
Почему обычный путь сохранения растёт вместе с данными
Обычный путь TXLSXWorkbook сначала строит полную объектную модель. Каждая ячейка со своим значением, типом и ссылкой на стиль живёт в памяти как объект до самого вызова сохранения, и лишь тогда всё дерево сериализуется в пакет. Эта модель верна, когда вы хотите прочитать лист, отредактировать его, пересчитать и записать обратно, потому что произвольный доступ к любой ячейке — ровно то, что нужно редактированию. И она неверна, когда вы льёте строки в одну сторону и никогда не оглядываетесь назад, потому что вы платите за резидентность каждой строки без всякой отдачи. Миллион строк объектов остаётся миллионом строк объектов независимо от того, вернётесь ли вы к ним хоть раз
Потоковый писатель убирает дерево. Как только ячейка записана, она становится байтами в части листа, и эти байты уходят в zip-вывод. Единственный буфер, который растёт, — поток листа, и растёт он на стороне вывода, а не живыми объектами Delphi в куче. В памяти остаётся фиксированный набор учётных данных: имена листов, несколько флагов, номер текущей строки, счётчик ячеек. Этот набор одинаков и на первой строке, и на десятимиллионной
Таблица общих строк — это ловушка, а выход — встроенные строки
Большинство потоковых писателей XLSX держатся молодцом, пока не встретят текст. Формат OOXML обычно хранит строки в таблице общих строк: каждая различная строка один раз записывается в отдельную часть, а всякая ячейка с этой строкой несёт вместо текста индекс в таблице. Для файлов, полных повторяющихся подписей, это хорошая экономия места, и именно так по умолчанию поступает стандартный путь сохранения. Для потокового писателя проблема жестокая. Чтобы убирать дубликаты, таблица обязана оставаться в памяти всё задание, ведь любая ещё не пришедшая строка может повторить строку из уже записанной, и только полная карта увиденных строк в памяти способна назначить правильный индекс. Выходит, единственная структура, которую потоковый писатель не может передавать потоком, — это как раз та структура, которая призвана уменьшить файл. Насыщенные текстом данные губят ту самую потоковость, ради которой вы пришли
Прямой писатель обходит таблицу целиком. Строки пишутся встроенными, как ячейки с t="inlineStr", чей текст лежит прямо внутри ячейки в элементе <is><t>. Нет ни таблицы, которую надо копить, ни карты увиденных строк, которую надо держать, поэтому текстовые колонки стоят не больше памяти, чем числовые. Компромисс здесь явный, и о нём стоит сказать прямо. Встроенные строки повторяют один и тот же текст везде, где он встречается, поэтому файл со множеством одинаковых подписей на диске крупнее своего эквивалента с общими строками. Вы тратите размер файла, чтобы купить постоянную память. Для однопроходной выгрузки это правильная сторона сделки, а сжатие zip на выходе всё равно поглощает большую часть повторов

Таблица стилей приходит в конце и с одним форматом даты
Со стилями та же напряжённость, что и со строками. Книга ссылается на своё оформление через часть стилей, а потоковый писатель не может держать растущую палитру стилей в согласии с уже сброшенными ячейками. Прямой писатель отвечает на это тем, что держит таблицу стилей маленькой и фиксированной и выдаёт её при закрытии, а не заранее. Один формат ячейки по умолчанию покрывает обычные ячейки. Один числовой формат даты покрывает даты и регистрируется с кодом формата yyyy-mm-dd в известной позиции списка форматов ячеек
Именно из-за этого формата даты WriteDateTime существует отдельным вызовом. У Excel нет нативного типа даты; дата — это число, надевшее формат даты. WriteDateTime пишет значение как обычный порядковый номер и помечает ячейку единственным стилем даты, чтобы таблица отрисовала её датой, а не пятизначным целым. Записываемый порядковый номер важен для обратного прохода. Значение TDateTime сохраняется напрямую по системе дат 1900 — по тому же соглашению, что и обычный путь сохранения TXLSXWorkbook. Поскольку оба пути согласны насчёт порядкового номера, файл, созданный потоковым писателем, читается обратно читателем HotXLS и открывается в Excel с теми датами, которые вы задумали, без сдвига на единицу и без сюрпризов с эпохой между писателем и читателем
Порядок обязателен, потому что байты уже ушли
Свой профиль памяти потоковость покупает одним правилом, которое надо соблюдать. Вывод выдаётся по ходу дела и не может быть пересмотрен, поэтому всё должно записываться в том порядке, в каком оно идёт в файле. Внутри строки ячейки идут по возрастанию колонок. Внутри листа строки идут по возрастанию. Нет никакого буфера, который позволил бы писателю отсортировать ваши ячейки задним числом, потому что строка, которую вы закрыли минуту назад, уже стала байтами в zip-потоке и больше недосягаема. Передайте ему в одной строке колонку 5, а затем колонку 2 — и вывод окажется некорректным, ведь писатель просто выдаёт то, что вы дали, в той последовательности, в какой вы это дали
У API строк есть небольшое удобство для частого случая. AddRow принимает индекс строки, считая с единицы, но передача 0 означает «взять следующую строку после предыдущей», так что последовательному заполнению не нужно вести и передавать растущий счётчик. Каждый AddRow закрывает предыдущую строку, а каждый AddSheet закрывает предыдущий лист, поэтому вы никогда не завершаете строку или лист явно. Вы начинаете следующие, а писатель сам финализирует открытую структуру

Экранирование делается там, где текст попадает в XML
Любой записанный вами текст становится частью XML-документа, поэтому пять предопределённых сущностей XML необходимо экранировать, иначе пакет станет некорректным в тот же миг, когда значение получит амперсанд или угловую скобку. Писатель экранирует за вас &, <, >, " и ' и во встроенном строковом тексте, и в тексте формулы — это два места, где заданные вызывающим кодом символы попадают внутрь разметки. Вы передаёте сырую WideString, а писатель делает её безопасной. Название продукта вроде Smith & Co <Ltd> или формула со ссылкой на имя листа в кавычках выходят корректным XML без всякого экранирования с вашей стороны
Жизненный цикл и почему Destroy всё-таки закрывает
Завершение пакета — это то, что записывает часть книги, часть стилей, части типов содержимого и связей, а в конце центральный каталог zip. Эта работа происходит в Close. Незакрытый пакет — это неполный zip, который не откроет ни одна табличная программа, поэтому закрытие — не факультативная уборка, а тот самый шаг, который делает файл корректным. Чтобы подстраховаться от забытого Close на пути обработки ошибки, Destroy выполняет закрытие по мере возможности, если пакет ещё открыт, поэтому освобождение писателя не теряет нижележащий объект zip даже тогда, когда исключение пропустило явный вызов. Надёжным шаблоном по-прежнему остаётся обычный для Delphi: пишите внутри try, вызывайте Close и освобождайте в finally
Потоковая запись большого листа от начала до конца
Форма задания такова: начать, добавить лист, лить строки, закрыть. Пример ниже пишет строку заголовков, а за ней длинную череду типизированных строк данных, где смешаны строки, числа, формула без кэшированного результата и дата. Память, которую он использует на десяти строках и на десяти миллионах строк, одинакова, потому что каждая ячейка уходит в zip-поток сразу, как только записана
uses
  lxDirectWrite;

procedure StreamReport(const Path: string; RowCount: Integer);
var
  W: TXLSDirectWriter;
  I: Integer;
begin
  W := TXLSDirectWriter.Create;
  try
    W.BeginFile(Path);
    W.AddSheet('Sales');

    // Строка заголовков, записанная по возрастанию колонок
    W.AddRow(1);
    W.WriteString(1, 'Item');
    W.WriteString(2, 'Qty');
    W.WriteString(3, 'Price');
    W.WriteString(4, 'Total');
    W.WriteString(5, 'Date');

    // Строки данных; передайте 0 в AddRow, чтобы взять следующую строку автоматически
    for I := 1 to RowCount do
    begin
      W.AddRow(0);
      W.WriteString(1, 'Item ' + IntToStr(I));
      W.WriteNumber(2, I);
      W.WriteNumber(3, 1.5 + (I mod 10));
      W.WriteFormula(4, Format('B%d*C%d', [I + 1, I + 1]));
      W.WriteDateTime(5, EncodeDate(2026, 1, 1) + I);
    end;

    W.Close;                       // финализирует пакет
  finally
    W.Free;
  end;
end;
Второй лист — это просто ещё один AddSheet перед продолжением, и писатель закрывает первый лист, открывая второй. Логические флаги используют WriteBoolean, который пишет типизированную логическую ячейку, а не текст «True». Если хочется убедиться, что файл цел и проходит обратный цикл, свойство CellCount сообщает, сколько ячеек было записано, и чтение результата потоковым читателем должно дать тот же итог
  // Второй лист с типизированными флагами после листа данных выше
  W.AddSheet('Flags');
  W.AddRow(1);
  W.WriteString(1, 'Name');
  W.WriteString(2, 'Active');
  W.AddRow(0);
  W.WriteString(1, 'alpha');
  W.WriteBoolean(2, True);

  WriteLn(Format('wrote %d cells', [W.CellCount]));
Запись в поток вместо файла — тот же код с BeginStream на месте BeginFile, что позволяет серверу отправить книгу в HTTP-ответ или в поток в памяти без временного файла на диске. Писатель не владеет переданным ему потоком, поэтому его временем жизни распоряжаетесь вы
Когда работа — это серверная точка входа, собирающая книги по запросу, шаблоны из статьи потоковая запись для серверных и пакетных заданий показывают, как встроить это в обработчик запроса и в выгрузку по расписанию. Когда вопрос шире и касается общей цены очень больших книг и при чтении, и при записи, статья производительность больших книг в Delphi разбирает, куда на самом деле уходят время и память. Потоковый прямой писатель входит в состав HotXLS Delphi Component для Delphi и C++Builder наряду с полными API чтения, редактирования и сохранения, которым посвящены другие статьи этого блога