Excel показывает «We found a problem with some content» на XLSX, который LibreOffice и любой самодельный читатель открывают без единой жалобы, потому что Excel требует двух вещей, которые эти читатели игнорируют: обязательных по схеме атрибутов и правил уникальности Open Packaging Conventions. Три из этих правил легко нарушить в любом писателе, который совмещает сгенерированные части с сохранёнными: <phoneticPr> требует своего fontId, каждое имя части получает ровно один Override в [Content_Types].xml, и две корневые связи никогда не должны делить идентификатор вроде rId4. Эта статья проходит по каждому правилу и показывает, как HotXLS, нативный компонент работы с электронными таблицами Excel для Delphi и C++Builder, пишет пакет так, чтобы ему соответствовать
Почему Excel отвергает пакет, который принимают все остальные читатели?
Потому что запрос на восстановление — это валидатор схемы и пакета, а не сбой парсера. Книга может пройти туда-обратно через вашу же библиотеку, через LibreOffice и через XML-валидаторы и быть структурно корректной в том смысле OPC, о котором говорит статья про разрешение связей OPC в XLSX: каждая часть достижима, каждая цель разрешается. Откройте её через Workbooks.Open в изолированном COM-экземпляре с выключенным DisplayAlerts — и вызов всё равно может упасть наглухо. Интерактивно тот же файл выдаёт знакомый диалог с предложением восстановить, а журнал восстановления, когда Excel вообще берёт на себя труд его записать, называет часть, но не правило. За одним этим запросом могут прятаться несколько независимых нарушений, и Excel не сообщает о них по одному: он отвергает книгу и оставляет вам искать и анализировать. Дальше — каждое правило, естественный способ его нарушить и то, как вместо этого пишет пакет HotXLS, потому что каждое из них — правило, на котором может споткнуться любой писатель XLSX на Delphi
Правило 1: fontId в phoneticPr обязателен, даже когда он равен нулю
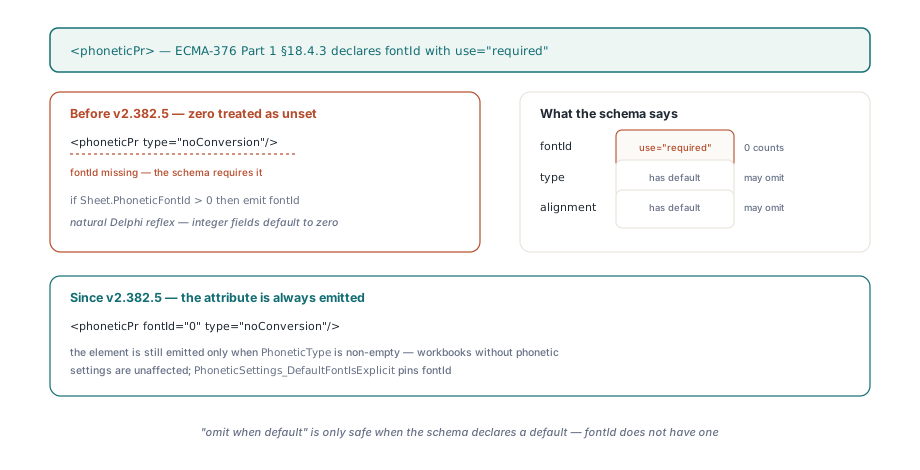
Элемент <phoneticPr> несёт атрибут fontId, объявленный как use="required" в ECMA-376 Part 1 §18.4.3, и значение 0 — это допустимый индекс шрифта, а не его отсутствие. Писатель, который считает ноль признаком «не задано» и выдаёт атрибут только при Sheet.PhoneticFontId > 0, следует естественному рефлексу Delphi — целочисленные поля по умолчанию равны нулю, — но получает <phoneticPr type="noConversion"/> для любой книги, чей фонетический шрифт случайно оказался первым шрифтом в styles.xml, а попасть в это легко: индекс 0 — просто первый шрифт. И Excel отвергает на обратном пути значение, которое записал сам же
// Естественный рефлекс: ноль считается «не задано», fontId выброшен
phoneticXml:= '<phoneticPr';
if Sheet.PhoneticFontId > 0 then
  phoneticXml:= phoneticXml+ ' fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';

// lxHandleX.pas, писатель рабочих листов — атрибут обязателен, ноль включительно
phoneticXml:= '<phoneticPr fontId="'+ IntToStr(Sheet.PhoneticFontId)+ '"';
phoneticXml:= phoneticXml+ ' type="'+ XlsxEscapeAttr(Sheet.PhoneticType)+ '"';
if Sheet.PhoneticAlignment<> '' then
  phoneticXml:= phoneticXml+ ' alignment="'+ XlsxEscapeAttr(Sheet.PhoneticAlignment)+ '"';
HotXLS выдаёт элемент только когда TXLSXWorksheet.PhoneticType непустой, так что книги, никогда не несшие фонетических настроек, не затрагиваются. Поставьте PhoneticFontId в ноль на новом листе, сохраните — и в xl/worksheets/sheet1.xml будет <phoneticPr fontId="0". Урок шире: «пропускай, если значение по умолчанию» безопасно только тогда, когда схема это умолчание объявляет; у type и alignment в этом элементе умолчания есть, у fontId — нет
Правило 2: один Override на имя части в [Content_Types].xml
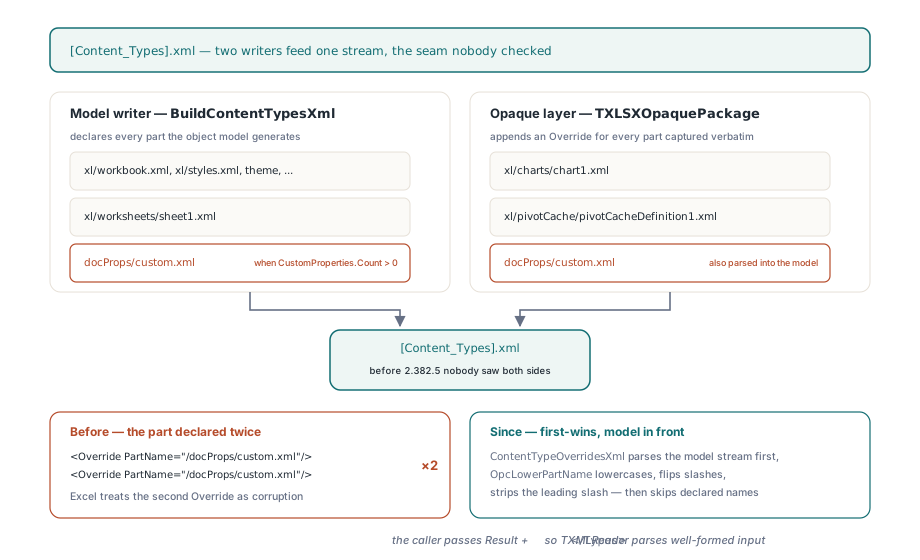
Поток типов содержимого может объявлять каждое имя части не более одного раза, и Excel считает второй Override для того же PartName повреждением, даже когда обе записи несут одинаковый ContentType. В этот поток пишут два писателя HotXLS. BuildContentTypesXml объявляет каждую часть, которую генерирует объектная модель: книгу, стили, общие строки, тему, рабочие листы и, при TXLSXWorkbook.CustomProperties.Count > 0, /docProps/custom.xml. Когда включён PreserveUnsupportedParts, TXLSXOpaquePackage затем добавляет Override для каждой части, захваченной из исходного пакета дословно, чтобы эти байты остались объявленными на выходе. Столкновение даёт часть, которая живёт с обеих сторон. Настраиваемые свойства документа разбираются в модель, но docProps/custom.xml исходного пакета тоже захвачен непрозрачно, поэтому наивное слияние объявляет его дважды, а части кешей диаграмм и сводных таблиц могут попасть в ту же точку, когда модель перегенерирует часть, которую непрозрачный слой тоже сохранил. Непрозрачный писатель, не видящий, что модель уже записала, знать этого не может, — именно поэтому ContentTypeOverridesXml и получают этот взгляд
<!-- Что выдаёт наивное слияние -->
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
...
<Override PartName="/docProps/custom.xml"
    ContentType="application/vnd.openxmlformats-officedocument.custom-properties+xml"/>
HotXLS передаёт сгенерированный XML в ContentTypeOverridesXml и даёт непрозрачному писателю разобрать его прежде, чем тот что-либо выдаст. Корректность держится на двух деталях. OpcLowerPartName приводит к нижнему регистру, меняет обратные слэши на прямые и срезает ведущие слэши перед сравнением, потому что имена частей OPC сравниваются без учёта регистра, а модель пишет их с ведущим слэшем, тогда как непрозрачный слой хранит имена элементов ZIP без него. И вызывающий код в BuildContentTypesXml передаёт Result + '</Types>', закрывая частично построенный документ, чтобы TXMLReader увидел корректный ввод, а не обрезанный поток. Возникающее правило — побеждает первый, и первый здесь модель: что объявила объектная модель, то и авторитетно, а непрозрачное воспроизведение только заполняет пробелы
// lxOpcPackage.pas — TXLSXOpaquePackage.ContentTypeOverridesXml
function TXLSXOpaquePackage.ContentTypeOverridesXml(const ExistingXml: WideString): WideString;
begin
  ...
  UsedNames.Sorted:= True;
  UsedNames.Duplicates:= dupIgnore;
  if ExistingXml<> '' then
    // Разбираем сгенерированный моделью поток и собираем все объявленные PartName.
    while Reader.Read do
      if (Reader.NodeType= xmlntElement)and (Reader.Name= 'Override') then
      begin
        Index:= Reader.AttributeIndex('PartName');
        if Index>= 0 then
          UsedNames.Add(String(OpcLowerPartName(Reader.Attribute[Index].Value)));
      end;
  for i:= 0 to FParts.Count- 1 do
  begin
    Part:= TXLSXOpaquePart(FParts[i]);
    if (Part.ContentType= '')or (LowerCase(ExtractFileExt(String(Part.PartName)))= '.rels')or
      (UsedNames.IndexOf(String(OpcLowerPartName(Part.PartName)))>= 0) then
      Continue;                       // уже объявлено или это часть rels
    UsedNames.Add(String(OpcLowerPartName(Part.PartName)));
    Result:= Result+ '<Override PartName="/'+ OpcXmlEscapeAttribute(Part.PartName)+
      '" ContentType="'+ OpcXmlEscapeAttribute(Part.ContentType)+ '"/>';
  end;
end;
Правило 3: идентификаторы связей уникальны внутри части связей
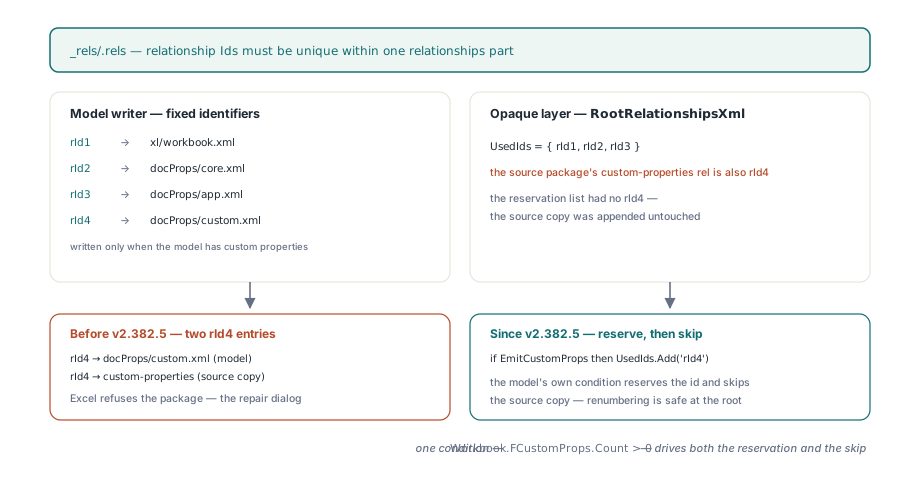
Каждый Relationship в части .rels нуждается в Id, уникальном внутри этой части, и Excel отказывается от пакета, когда два идентификатора совпадают. HotXLS пишет корневой _rels/.rels пакета с фиксированными идентификаторами: rId1 для книги, rId2 и rId3 для основных и расширенных свойств документа и rId4 для настраиваемых свойств, если они у модели есть. Затем непрозрачный пакет добавляет все корневые связи, сохранённые из источника, перенумеровывая любой идентификатор, уже сидящий в списке UsedIds. Если этот список знает только rId1–rId3 и не знает, что модель вот-вот выдаст собственную связь настраиваемых свойств, исходный пакет, чья связь настраиваемых свойств тоже была rId4 — а именно это Excel пишет по умолчанию, — выходит с двумя записями rId4, указывающими на одну цель. Поэтому RootRelationshipsXml резервирует rId4 и пропускает исходную копию всякий раз, когда модель выдаёт настраиваемые свойства. Вызывающий код, BuildRootRelsXml, передаёт Workbook.FCustomProps.Count > 0 вторым аргументом, так что и резервирование, и пропуск управляются тем же условием, которое решает, выдаст ли модель rId4 вообще. Перенумерация в корне пакета безопасна: ничто внутри книги не ссылается на корневые идентификаторы связей по имени. Тот же приём был бы ошибкой на уровень ниже, где атрибуты r:id в workbook.xml привязаны к идентификаторам в части связей книги, поэтому MergeWorkbookRelationshipsXml и держит отдельную карту идентификаторов
// lxOpcPackage.pas — TXLSXOpaquePackage.RootRelationshipsXml
UsedIds.CaseSensitive:= False;
UsedIds.Add('rId1');
if EmitCustomProps then UsedIds.Add('rId4');   // зарезервировано писателем модели
if EmitDocProps then
begin
  UsedIds.Add('rId2');
  UsedIds.Add('rId3');
end;
for i:= 0 to FRootRelationships.Count- 1 do
begin
  Rel:= TXLSXOpaqueRelationship(FRootRelationships[i]);
  // Настраиваемые свойства принадлежат модели; исходную копию не воспроизводим.
  if EmitCustomProps and OpcEndsWith(LowerCase(Rel.RelType), '/custom-properties') then
    Continue;
  Id:= Rel.Id;
  if (Id= '')or (UsedIds.IndexOf(String(Id))>= 0) then
    Id:= AllocateRelationshipId(UsedIds);      // наименьший свободный rIdN
  UsedIds.Add(String(Id));
  ...
end;
Что общего у трёх правил?
Все три защищают от писателя с двумя источниками и без единого хозяина инвариантов пакета. Объектная модель генерирует части, которые понимает; непрозрачный слой воспроизводит те, которых не понимает, чтобы круговой рейс сохранял диаграммы, кеши сводных таблиц, настраиваемый XML и всё остальное, о чём говорят заметки про рейс без потерь для theme, extLst и calcChain. Каждая сторона может быть по отдельности согласована. Ограничения, которые OPC накладывает на пакет целиком — уникальные имена частей в Override и уникальные идентификаторы связей внутри части, — существуют только на стыке, где эти две стороны склеиваются, значит, у стыка должен быть хозяин. Правило fontId — та же форма на уровень ниже: писатель может знать, что хочет пропустить, и ни разу не свериться со схемой, которая говорит, что пропускать нельзя. HotXLS решает это жёстким приоритетом, а не эвристикой слияния. Первой пишет модель, непрозрачный слой видит записанное и уступает при любом столкновении. Инварианты и снаружи дёшево проверить: прочитайте [Content_Types].xml и каждый элемент .rels в сохранённом пакете и вались на любом дубликате PartName, Extension или Id. Эта проверка Excel не требует и покрывает оба правила уникальности; правилу fontId всё ещё нужен валидатор схемы
Области печати, которые формулы, а не диапазоны
Область печати — вторая вещь, которую Excel сравнивает на сохранённой копии: шаблон, чей _xlnm.Print_Area Excel показывает как $A$1:$J$29, обязан показать то же самое после кругового рейса. За этим сидят две ловушки. При импорте срезание префикса, отрезающее всё до первого неэкранированного !, превращает динамическую область печати вроде OFFSET('Print Data'!$A$1,0,0,2,2) в $A$1,0,0,2,2), а квалифицированное объединение вроде 'Print Data'!$A$1:$B$2,'Print Data'!$D$1:$E$2 заставляет потерять префикс только у первого сегмента. При экспорте однократная приставка имени листа ко всей сохранённой PrintArea даёт простому объединению $A$1:$B$2,$D$1:$E$2 квалифицированный первый сегмент и голый второй, а такое Excel не принимает как определение _xlnm.Print_Area по ECMA-376 Part 1 §18.2.5
// Импорт: срезаем префикс, только если остаток — простой sqref
function XlsxPrintAreaFromDefinition(const Formula: WideString): WideString;
begin
  Result:= Formula;
  if not XlsxReadFormulaSheetPrefixAt(Formula, 1, Prefix, SheetPart, Start) then
    Exit;
  Area:= Copy(Formula, Start, Length(Formula));
  if XlsxParseSqrefPart(Area, R1, C1, R2, C2) then
    Result:= Area;                    // 'Sheet'!$A$1:$J$29 -> $A$1:$J$29
end;                                  // OFFSET(...) возвращается нетронутым

// Экспорт: квалифицируем каждый сегмент через запятую либо ни один
function XlsxPrintAreaDefinition(const SheetName, Area: WideString): WideString;
begin
  Result:= Area;
  ... split Area on ',' with StrictDelimiter ...
  for I:= 0 to Parts.Count- 1 do
    if not XlsxParseSqrefPart(WideString(Trim(Parts[I])), R1, C1, R2, C2) then
      Exit;                           // это формула: выдаём дословно
  Result:= '';
  for I:= 0 to Parts.Count- 1 do
  begin
    if I> 0 then Result:= Result+ ',';
    Result:= Result+ XlsxQuoteSheetName(SheetName)+ '!'+ WideString(Trim(Parts[I]));
  end;
end;
Правило парности одинаково с обеих сторон: область печати — голый диапазон только тогда, когда каждый сегмент разбирается как диапазон, иначе это формула и она едет дословно. С таким правилом именованная база, база с квалификацией листа и объединение переживают повторяющиеся циклы сохранения и повторного открытия. О том, как области печати взаимодействуют с параметрами страницы и остальной моделью печати, рассказывает статья про защиту листа, параметры страницы и печать
Как найти, против какого правила возражает Excel?
Исходите из того, что ваш собственный валидатор врёт, потому что он ведь прошёл. Валидатор Open XML SDK назовёт нарушение схемы вроде отсутствующего fontId вместе с частью и XPath, а слой упаковки под ним вообще откажется открыть пакет с дублирующимися записями типов содержимого, так что запускайте его первым делом. Когда он молчит, а Excel всё равно восстанавливает, делите пакет пополам: распакуйте, удалите часть, её связь и её Override, запакуйте заново и снова откройте, каждый раз вдвое сужая набор кандидатов, пока запрос не исчезнет. Три нарушения выше выпадают именно в таком порядке, и ни одно из них не было бы видно в восстановленном файле, который Excel предлагает сохранить, потому что восстановление молча выбрасывает или перенумеровывает проблемные записи. Два проектных решения писателя HotXLS стоит знать. Дедупликация — это победа первого с моделью впереди, поэтому если исходный пакет объявлял другой тип содержимого для части, которую модель тоже генерирует, побеждает объявление модели, а исходное отбрасывается: для частей, которые HotXLS перегенерирует, это правильно, и это не общее слияние. А дополнительный проход TXMLReader по сгенерированному потоку типов содержимого выполняется при каждом сохранении с включённым PreserveUnsupportedParts — небольшая цена за поток, который редко бывает больше нескольких килобайт. Со всеми этими правилами шаблон кредита на 4805 формул, сохранённый и сборкой Win32, и сборкой Win64, открывается в Excel без запроса, пересчитывается без единого расхождения и показывает ту же область печати, что и оригинал
Если вы сами пишете XLSX из Delphi, чек-лист короткий: выдавайте каждый атрибут, помеченный в схеме обязательным, независимо от его значения; объявляйте каждое имя части один раз; и держите один список использованных идентификаторов на каждую часть связей во всех писателях, которые к ней прикасаются. Если вам удобнее, чтобы такой список уже существовал и проверялся против Excel, а не только против вашего собственного читателя, описанный здесь писатель пакетов поставляется в составе компонента HotXLS Delphi для работы с электронными таблицами — вместе с круговым рейсом непрозрачных частей, из-за которого стык и стал стоить охраны