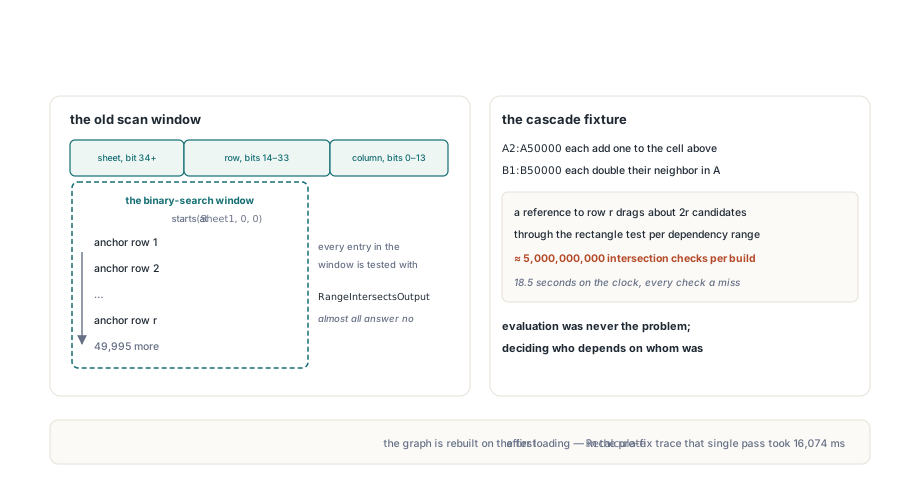
Лист с 50 000 формул в столбце A, каждая прибавляет единицу к ячейке выше, и еще 50 000 в столбце B, удваивающие соседа, — примерно настолько простым, насколько вообще бывает модель электронной таблицы. Вычисление стоит 100 000 сложений и умножений. Выяснение порядка вычисления стоит куда больше, если строитель рёбер написан очевидным способом: искать каждую формулу от верха сосланного листа вниз до сосланной строки, проверять каждую на пересечение и оставлять попадания. Для этого одного листа выходит порядка пяти миллиардов проверок прямоугольников, и почти каждая отвечает «нет»
Пять миллиардов — это арифметика, а не показание секундомера. Ссылка на строку r тащит в поисковое окно около 2r кандидатов, по одному на столбец для каждой строки выше, и суммирование по 100 000 ссылок попадает в миллиарды. Интересно то, что окно действительно обязано начинаться с верха листа, и по причине, не имеющей ничего общего с ленью
Куда уходит время при перестройке зависимостей
Движок пересчёта HotXLS перестраивает граф зависимостей формул при каждом изменении топологии формул: первый Recalculate после загрузки или генерации книги и первый после перезаписи формул, добавления или удаления листов или клонирования блока ячеек. Оба класса книг, TXLSWorkbook и TXLSXWorkbook, строят для этого TXLSDepGraph из модуля lxDepGraph. Каждая ячейка с формулой становится одним узлом с якорем (Row, Col) и выходным прямоугольником, идущим до (OutRow2, OutCol2). Для обычной формулы прямоугольник — сама ячейка-якорь
Узлы упорядочены упакованным 64-битным ключом из XLSDepMakeKey: столбец сидит в битах 0–13, строка в битах 14–33, индекс листа с бита 34 и выше. Сортировка по этому ключу даёт порядок «лист, затем строка», так что поиск последней формулы, которая может иметь значение для ссылки, — один бинарный поиск по (Sheet2, Row2, 16383). Первая — проблема. Нижней границей приходится брать (Sheet1, 0, 0), самый верх сосланного листа, и всё между двумя границами становится кандидатами
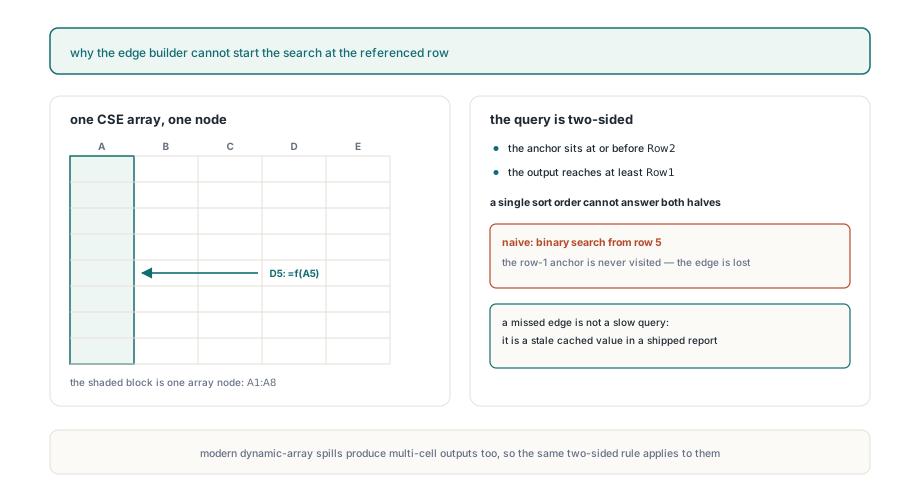
Почему поиск не может начаться со сосланной строки?
Формула массива, заякоренная выше диапазона, может владеть ячейками внутри него. В TXLSXWorkbook CSE-массив, введённый в A1:A8, — один узел, чей якорь A1 и чей выход достаёт до строки 8, как описывает статья про инкрементальный пересчёт и граф зависимостей. Формула в D5, читающая только A5, всё равно нуждается в ребре от этого узла. Начните бинарный поиск со строки 5 — якорь в строке 1 никогда не будет посещён, ребро не будет записано, и D5 может быть вычислена раньше массива, от которого зависит. Симптом — протухшее кэш-значение в сохранённой книге, что заметить куда труднее, чем медленный пересчёт
Так что настоящий запрос двусторонний. Узел — кандидат, когда его якорь не позже Row2 и его выход достаёт минимум до Row1, на листе внутри ссылки и с пересекающимися столбцами. Сортировка по якорю отвечает на первую половину. Ничто в порядке якорей не говорит ничего о второй половине, потому что формула на строке 3 может вывести одну ячейку или тысячу строк. What-if таблицы данных имеют ту же форму: TXLSXWorkbook регистрирует каждую таблицу данных как один узел, покрывающий всю свою область результатов. Формулы динамических массивов идут другим маршрутом и помечены как volatile, поэтому пересчитываются на каждом проходе; статья про формулы разлива динамических массивов рассказывает, как ведут себя разлитые диапазоны
TXLSDepGraph — публичный класс, так что случай легко воспроизвести без книги. Индексы листов считаются с единицы, строки и столбцы — с нуля, совпадая с координатами вычислителя. Проба ниже регистрирует корень массива и читателя, строит рёбра, а также гоняет цепочку обращённых точечных ссылок через тот же тип графа, чтобы показать счётчик, на который опираются следующие разделы
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE-массив: якорь A1 (строка 0, столбец 0), выход до A8 (строка 7)
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5 (строка 4, столбец 3) читает только A5
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, корень A1
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: корень A1 и сама D5
  finally
    G.Free;
  end;

  // Цепочка A1..A100000, каждая ячейка читает ту, что выше, добавление снизу вверх
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
Отсечение поддеревьев по их наибольшей выходной строке
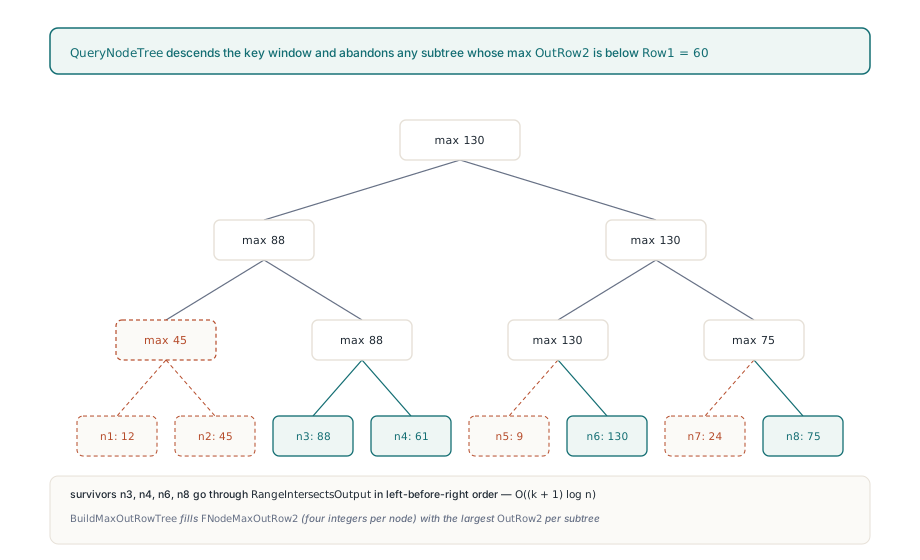
TXLSDepGraph.BuildEdges оставляет сортировку по якорю для верхней границы и отвечает на нижнюю расширенным по максимуму деревом отрезков, разложенным поверх отсортированного порядка. Каждая запись дерева хранит наибольший OutRow2 всех узлов под ней. Запрос спускается только внутри ключевого окна и бросает любое поддерево, чей сохранённый максимум выше Row1, потому что ни одна формула в этом поддереве не может достать до сосланных строк. Пережившие узлы всё равно проходят полный тест прямоугольника, так что диапазон листов и столбцы проверяются точно как раньше
Техника достаточно мала, чтобы показать её целиком. Эскиз ниже — минимальная версия, написанная для этой статьи, с собственными именами; ни одно из них не является API HotXLS, а заполнить массивы из списка выходных строк, уже отсортированного по ключу якоря, предстоит самому читателю
uses
  System.Math, System.Generics.Collections;

// Только эскиз: дерево отрезков с расширением по максимуму поверх узлов, отсортированных по якорю.
// OutRow2[i] — последняя выходная строка i-го узла в отсортированном порядке.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// Собирает слева направо каждый узел в [Lo, Hi), чей выход достаёт до Row1
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // вне окна, или ничто не достаёт до Row1
  if L = R then
  begin
    Hits.Add(L);                 // вызывающий всё равно выполняет полный тест прямоугольника
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // сначала левое
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // сохраняет порядок сканирования
end;

// Постройте один раз вызовом BuildMax(Ix, 1, 0, Count - 1),
// затем на каждую ссылку вызывайте Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)
На ссылку работа падает с размера окна до O((k + 1) log n), где k — число узлов, чей выход реально достаёт до сосланных строк. Возвращаясь к модели из вступления: ссылка из Br в Ar теперь проверяет два прямоугольника, Ar и саму Br, а ссылка из Ar в ячейку выше проверяет два узла этой строки. Вручную это около 200 000 проверок на полную сборку вместо пяти миллиардов
Те же рёбра, в том же порядке
Рекурсия «левое раньше правого» значит больше, чем кажется. Пережившие узлы посещаются ровно в том порядке, в каком их посетил бы простой цикл по окну, так что массивы Dependents и Precedents каждого узла заполняются в той же последовательности, и построенный из них топологический порядок выходит одинаковым при каждом запуске. Этот порядок — не только внутренняя бухгалтерия: когда граф актуален, XLSX-райтер пишет xl/calcChain.xml в порядке, который возвращает FullTopoOrder, так что недетерминированный порядок обхода показался бы шумными диффами между двумя сохранениями неизменённой книги
Виды рёбер тоже сохраняют свои правила. Ссылки, сидящие в аргументе lookup-массива функций VLOOKUP, MATCH, XLOOKUP и подобных, дают lookup-scan рёбра, которые распространяют «грязность», но остаются вне детектора циклов. Когда у узла есть и жёсткая ссылка, и lookup-ссылка на одного и того же предшественника, жёсткое ребро, записанное первым, подавляет позднейшее скановое, а скановое, записанное первым, сохраняет свой слот, при этом жёсткое ребро всё равно добавляется. Именно этот порядок не даёт lookup-диапазонам плодить ложные циклические ссылки, и он держится, только если отсечённый обход посещает кандидатов в порядке сканирования
Свойство EdgeCandidateChecks делает отсечение наблюдаемым. Оно считает выходные прямоугольники, которые последний вызов BuildEdges реально проверил, и сбрасывается в начале каждой сборки. В пробе выше обращённая цепочка сообщает 99 999 — по одной проверке на ссылку, — хотя узлы добавлялись снизу вверх и сортировке пришлось переставить их все. AddNode помечает устаревшими и сортировку, и рёбра, так что следующий BuildEdges или NodeIndexOf перестраивает индекс, а не латает его
Где сидит оставшаяся цена
Дерево отсекает только по строкам, и этот выбор определяет, за что большая модель всё еще платит
- Промахи по столбцам оплачиваются на листьях: 2 626 формул, заполняющих
A100:Z200, все достают до строки 100, так что ссылка наAA100:AA200проверит каждую из них, прежде чем отвергнуть по столбцам - Ссылки в целый столбец и другие широкие ссылки действительно имеют много предшественников; индекс убирает холостые проверки, а построение настоящих рёбер остаётся пропорциональным их числу
- Ссылка, накрывающая несколько листов, открывает окно на весь первый лист, так что формулы на нём с глубокими выходами доходят до листового теста; рёбра выходят те же, слабее лишь отсечение
- Дерево стоит четыре целых числа на узел, около 1.6 МБ на 100 000 формул, и любое изменение топологии платит полную пересортировку O(n log n) плюс построение дерева O(n) при следующей сборке рёбер
Строки — правильное единственное измерение для индексации. Сгенерированные отчёты, гроссбухи и финансовые модели растут вниз, так что расстояние по строкам — то место, откуда приходят почти все холостые кандидаты, а промах по столбцу отвергается тестом прямоугольника за горстку целочисленных сравнений. Второе измерение в дереве усложнило бы каждый запрос ради экономии проверок, которые и так дешевы
На стороне вызывающего дорогой шаг — перестройка, и правки значений её не запускают. Recalculate строит граф при первом вызове; поздние вызовы пересчитывают только формулы ниже по потоку от изменённых значений, плюс volatile. Писать все формулы сначала и пересчитывать один раз — вот паттерн, к которому стоит стремиться. Стенд ниже замеряет оба вида проходов на классическом движке, где Recalculate возвращает число ячеек с формулами, которые он не смог вычислить; запускайте его на железе, где будет жить батч, потому что абсолютные времена сильно зависят от машины
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // цепочка из 49 999 звеньев в столбце A
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // 50 000 зависимых в столбце B
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // строит граф, вычисляет всё
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // правка значения: граф переиспользуется
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // только грязный подграф
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
В этой модели проход по значению всё еще пересчитывает все 99 999 формул, поскольку весь столбец A висит на A1; что он пропускает, так это построение графа. Перезапись ячейки с формулой обычным значением — другое дело, потому что это меняет топологию, и следующий Recalculate строит граф с нуля
Тот же квадратичный профиль в клонированных определённых именах
Репорт-бэнды прячут тот же паттерн в другом месте. TXLSXWorksheet.CloneRangeTo копирует определённые имена, указывающие прямо на диапазон внутри клонируемого блока, и каждой копии нужно имя, уникальное в своей области видимости: Total_2, Total_3 и так далее. Поиск, который для каждой копии стартует заново с _2, щупает на одного кандидата больше каждый раз, так что лист, собранный из сотен клонированных бэндов, тратит квадратичное число поисков имён на одно только именование
TXLSXDefinedNames избегает этого подсказкой суффикса, хранимой в индексе имён, по одной на пару «базовое имя, область». Следующий поиск стартует с суффикса, возвращённого в прошлый раз, и перепроверяет его первым, потому что вызывающий волен это имя не добавлять. Удаление имени, переименование через Name, перенос через SheetIndex или очистка коллекции роняют индекс вместе со всеми подсказками, так что следующий клон возвращается к первому свободному суффиксу и заполняет любую дыру, которую проделало изменение
Для приложений на Delphi и C++Builder, которые генерируют или пересчитывают большие таблицы, Excel-компонент HotXLS для Delphi и C++Builder использует этот индексированный граф зависимостей в движке пересчёта обоих своих классов книг, классического и XLSX