Когда PDF не встраивает шрифт, компонент HotPDF рисует этот текст установленным шрифтом Windows, который выбирает HPDFMapBaseFontToSystem: он декодирует имя /BaseFont, отрезает стилевую часть, пробует несколько написаний, пока GDI не подтвердит, что гарнитура установлена, мерит отсутствующие ширины standard 14 по метрически совместимым шрифтам и конвертирует однобайтовые коды в Unicode перед рисованием. Каждый из этих шагов существует потому, что очевидный подход проваливается на настоящих файлах. Рендерер страниц RenderLoadedPageToBitmap хорошо справляется с встроенными программами; это история о шрифтах, которых в файле нет вовсе
Почему GDI молча рисует не ту гарнитуру для невстроенного шрифта?
GDI никогда не сообщает об отсутствии шрифта: подсуньте CreateFontIndirect имя гарнитуры, которого он не знает, и он тихо выберет замену, часто другой serif без жирного начертания. Передайте PDF-имя почти дословно — и TimesNewRoman,Bold, TimesNewRomanPS-BoldMT и SegoeUI-Semibold не совпадут ни с чем и выйдут тем, что GDI подберёт. Имена бывают и хуже. ISO 32000-1 §7.3.5 позволяет имени писать любой байт как #xx, и CJK-производители регулярно записывают имена шрифтов эскейпленным UTF-8 или байтами легаси-кодовой страницы; маппер, пропускающий шаг декодирования, спрашивает у GDI гарнитуру, названную самими эскейпами. HPDFMapBaseFontToSystem декодирует эскейпы сперва, возвращает валидную последовательность байтов UTF-8 как символы и читает прочие старшие байты в системной кодовой странице
Отрезание стиля — место, где кусают эвристики. Запятая всегда кончает гарнитуру (Arial,Bold даёт Arial), а дефис — только когда слово после него стиль: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra или Condensed. Это правило оставляет MS-Mincho целым, превращая Calibri-Light в Calibri. Затем HotPDF пробует написания гарнитуры, за ними — написания с отрезанным суффиксом PSMT, MT или PS. Те написания покрывают каждый выбор пробелов в местах, где может начинаться слово: перед заглавной, следующей за строчной (MyriadPro становится Myriad Pro), на последней заглавной серии, за которой идёт строчная (UIGothic), и после ведущего MS (MSPGothic) — от полностью раздельного вида до имени как написано; после четырёх таких мест пробуются лишь полностью раздельное и слитное имена. Расставлять пробелы вслепую нельзя, потому что Windows держит некоторые слова слитно: SimSun установлен ровно под таким написанием, тогда как MicrosoftYaHei, MicrosoftJhengHei и MSPGothic принадлежат Microsoft YaHei, Microsoft JhengHei и MS PGothic. Маппер, ставящий пробел перед каждой внутренней заглавной, ищет MicrosoftYaHei как Microsoft Ya Hei и никогда его не находит. Кандидат считается установленным, когда CreateFontIndirect с последующим GetTextFace возвращает запрошенное имя или когда таблица name выбранного шрифта перечисляет его как семейство — полное или типографское, на любом языке; ответ кэшируется по имени, так что документы со множеством неустановленных шрифтов не щупают Windows по каждому имени на каждой странице
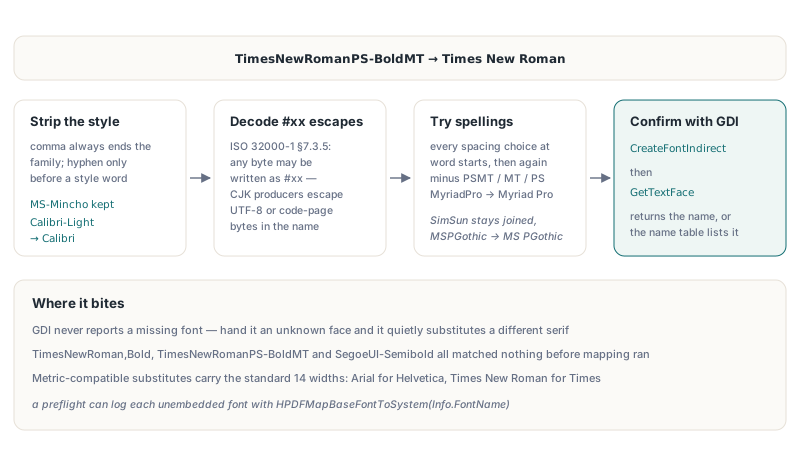
Поскольку функция отображения публична в юните HPDFRenderFontMetrics, префлайт-отчёт может показать, с какой установленной гарнитурой отрисуется каждый невстроенный шрифт, пользуясь перечислением шрифтов, которое THotPDF уже выставляет для загруженных документов:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Как HotPDF мерит шрифты standard 14 без /Widths?
HotPDF мерит недостающие advance на установленном шрифте с теми же метриками, потому что ISO 32000-1 §9.6.2.2 разрешает шрифтам standard 14 опускать /Widths, а библиотека AFM-таблиц не возит. Arial несёт метрики Helvetica, Times New Roman — Times, а Courier New — Courier, поэтому HPDFMeasureBaseFontWidths создаёт парную гарнитуру на lfHeight = -1000 и зовёт GetCharWidth32W; на той высоте результат уже в единицах 1/1000 em, которыми пользуются PDF-ширины. Рендерер сперва переводит каждый код в Unicode через /Encoding, /BaseEncoding и /Differences, с дефолтом StandardEncoding. SVG-экспорт и извлечение текста делят ещё одну ловушку: стандартный шрифт Type 1 вовсе без /Encoding всё равно имеет подразумеваемый StandardEncoding, а декодер, построенный без него, не несёт информации о кодировке, так что каждая измеренная ширина пропадает впустую. HotPDF подставляет подразумеваемый StandardEncoding и помечает его как предопределённую кодировку; маршрут по пути CMap-имён вместо этого декодировал бы каждый код в 0, и за ним последовали бы все ширины
Bold, italic и биты дескриптора шрифта, считаемые с единицы
Запись /Flags дескриптора шрифта нумерует биты с 1, а не с 0, поэтому ForceBold — бит 19 ($40000), а Italic — бит 7 ($40), по ISO 32000-1 Table 123. Ошибку на единицу сделать легко: считайте с нуля, и $20000 покажется ForceBold, хотя это бит 18, SmallCap, и проверка веса на нём отрисует каждую гарнитуру с капителью жирным. Ловушка ещё и хорошо прячется, потому что /FontDescriptor почти всегда косвенная ссылка: код, читающий только прямые объекты, вообще не добирается до флаговой ветки, и та же слепота игнорирует /Widths 12 0 R, выкладывая текст fallback-advance. Разрешение косвенных ссылок и привязка констант битов к Table 123 — вещи одного куска:
const
  // ISO 32000-1 Table 123 нумерует позиции битов с 1
  FD_ITALIC     = $00040;  // бит 7
  FD_SMALLCAP   = $20000;  // бит 18, не насыщенность
  FD_FORCEBOLD  = $40000;  // бит 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;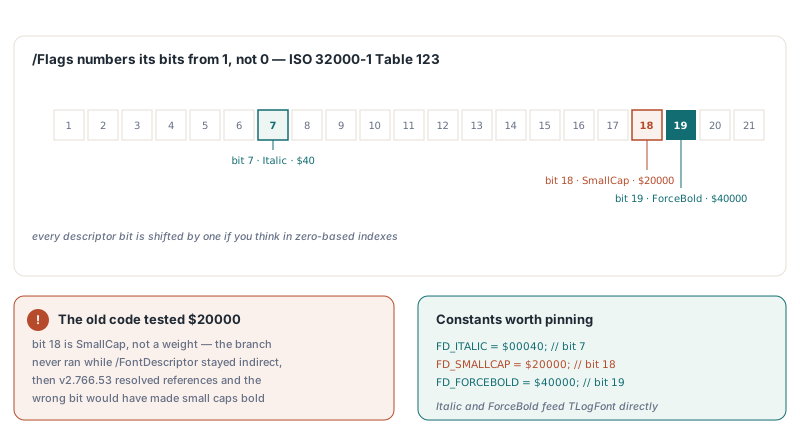
Почему CJK-шрифты с UCS2 CMap получают неверные ширины?
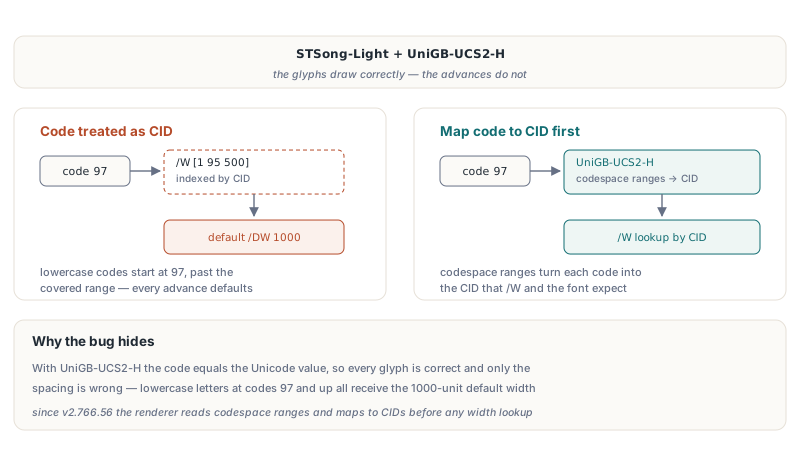
CJK-текст с предопределённым UCS2 CMap рисует правильные глифы, но неверный интервал, когда рендерер принимает код за CID, потому что /W индексируется по CID, а не по коду символа. С STSong-Light и UniGB-UCS2-H код совпадает со значением Unicode, так что GDI рисует правильные символы, и ошибка прячется в advance: строчные буквы приезжают кодами 97 и выше, выпадают из записи /W вроде [1 95 500] и все получают дефолтную ширину /DW в 1000. Рендерер HotPDF читает коды через codespace-диапазоны CMap (ISO 32000-1 §9.7.6.2) и проецирует их в CIDs, прежде чем искать ширины. Он работает от встроенных таблиц UCS2 и UTF16 и встроенных CMap-потоков; identity-аппроксимация для чего-то вроде GBK-EUC-H лишь делала бы вид поддержки, выдавая неверный вывод, поэтому она намеренно не используется
Почему символы с диакритикой превращаются в вопросики на китайском Windows?
Однобайтовые коды никогда не должны доходить до ANSI («A») функций GDI, потому что GetGlyphOutlineA и GetGlyphIndicesA толкуют байты в системной кодовой странице, а TextOutA использует набор символов выбранного шрифта. На китайской системе байт Arial $A9 (знак копирайта в Windows-1252) становится lead-байтом GBK и рисуется как «?», и любой контурный путь, зовущий A-функции, шагает прямо в неё. HotPDF спрашивает у реализованного шрифта его набор символов через GetTextCharset, переводит его в кодовую страницу через TranslateCharsetInfo, гонит байт через MultiByteToWideChar и зовёт W-функции; символные шрифты вместо этого используют U+F000 плюс код. Кодировки, расходящиеся с Windows-1252, — /Differences, StandardEncoding, MacRomanEncoding — проецируются в Unicode до того, как их увидит хоть какой-то системный шрифт
Как далеко идёт рисование системными шрифтами?
Рисование системными шрифтами — аппроксимация по своей природе, а локализованный Windows добавляет поворот: GetTextFace отчитывает имя семейства на языке системы, так что сравнение только по имени сочло бы Microsoft YaHei на китайском Windows или Yu Mincho на японском отсутствующими. Поэтому гарнитура, вернувшаяся под другим именем, дополнительно ищется в таблице name шрифта. Метрическая совместимость существует для семейств Helvetica, Times и Courier; Symbol проецируется на Symbol, а ZapfDingbats на Wingdings, что затычка, а не совпадение. Префлайт выше обходит словарь /Resources каждой страницы, так что шрифты, упомянутые только внутри form XObject, нуждаются в собственном проходе. Когда код всё же не рисуется, об этом отчитывается трекинг неразрешённых глифов во время рисования — сигнал получше разглядывания миниатюр
Прочный ответ сидит на стороне авторинга. Сам HotPDF пишет с FontEmbedding, выставленным в True по умолчанию, подставляя встроенный Arial, даже если код зовёт SetFont с Helvetica, а встроенный текст идёт через рендерер глифов встроенных шрифтов вместо всей описанной выше гадательной машинерии. Дешёвый предохранитель для входящих файлов — предупреждать перед рендерингом, когда отображённой гарнитуры нет в списке экранных шрифтов:
// VCL: Screen.Fonts перечисляет имена установленных семейств (юнит Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
О полном компоненте — с рендерингом страниц, извлечением текста и субсеттингом шрифтов на пишущей стороне — читайте на странице продукта HotPDF Delphi PDF component