HotPDF конвертирует HTML в страницы PDF через THPDFHTMLImporter.RenderHTML5 — версионированный профиль постраничных носителей с настоящим DOM, настоящим каскадом CSS, таблицами, разрывами страниц и опциональной генерацией AcroForm из элементов управления HTML-форм. Он работает полностью в рамках одного процесса: без движка браузера, без Chromium, без внешнего конвертера и по умолчанию вообще без доступа к файлам или сети
Причина, по которой существует отдельная точка входа, а не улучшенный RenderHTML, — совместимость. Старый метод годами рендерит счета и письма в промышленных приложениях, а нестрогий DOM с полным каскадом меняет вывод документов, настроенных под старое поведение. Поэтому старый метод сохраняет свою точную семантику, а всё новое находится за RenderHTML5, чью версию профиля сообщает HTML5ProfileVersion, а поддерживаемые вехи перечисляет HTML5ProfileMilestones
Что на самом деле добавляет профиль HTML5?
На практике важны четыре возможности. Структурный DOM, в котором html и body — контейнеры, а не текстовые узлы. Каскад CSS с корректным приоритетом. Вёрстка таблиц. И явное управление разрывами страниц — именно это и означает «постраничные носители»: HTML был задуман для прокручиваемой области просмотра, и превращение его в страницы требует решить, где содержимому разрешено разрываться
Пункт про контейнеры звучит как деталь реализации, а на деле это разница между «работает» и «не работает». Если корневые элементы трактуются как текстовые контейнеры, весь DOM схлопывается в один текстовый блок ещё на этапе разбора, и каждое правило таблицы стилей, разрыв страницы, таблица и поддерево формы впоследствии применяются ни к чему. Любой HTML-рендерер, выдающий из структурированного документа одну недифференцированную стену текста, совершил именно эту ошибку
Порядок каскада по шагам
Приоритет CSS — это не одна простая сортировка. HotPDF применяет обычные объявления из подходящих правил в порядке специфичности, а затем в порядке следования в источнике, затем поверх них — встроенные обычные объявления, затем объявления !important из подходящих правил и, наконец, встроенные !important. Четыре прохода именно в таком порядке
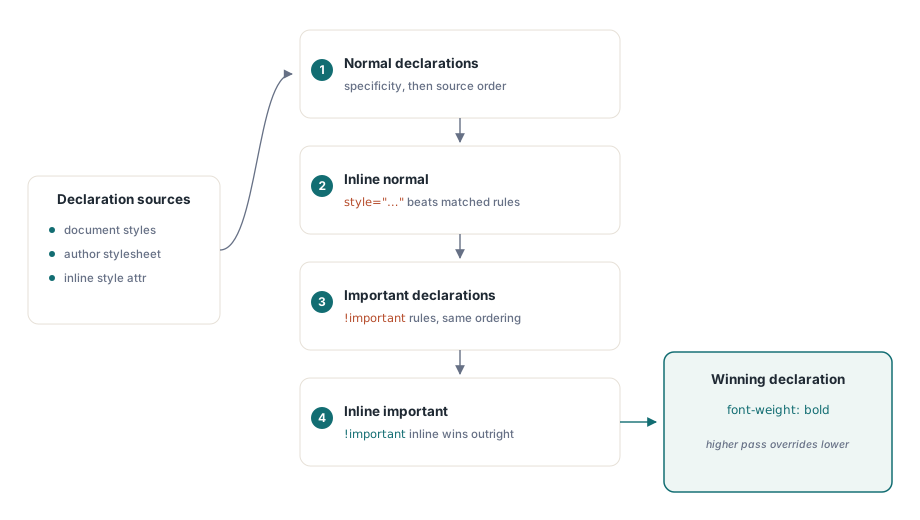
Реализации, сводящие это к правилу «побеждает последний», верно обрабатывают типичные случаи и неверно — интересные, а это хуже, чем ошибаться равномерно, потому что сбой проявляется только в шаблонах, использующих !important для переопределения базовой таблицы стилей — именно в тех шаблонах, что писали люди, ожидающие, что каскад будет работать правильно:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // пункты
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // отрисовывать элементы управления, не создавать поля формы

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
Второй аргумент — это авторская таблица стилей, применяемая вместе с тем, что несёт сам документ, и это чистый способ навязать внутренние правила — например, поля страницы и контроль висячих строк — не редактируя каждый шаблон
Почему импортёр никогда ничего не загружает по сети?
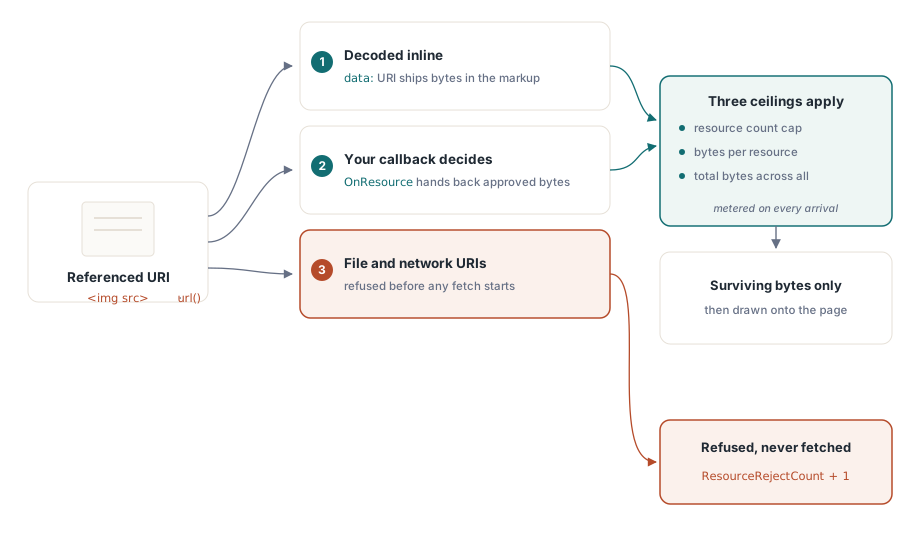
Конвертер HTML в PDF, разрешающий внешние ссылки, — это движок подделки серверных запросов (SSRF), переодетый в генератор документов. Направьте его на разметку, предоставленную пользователем, и он с готовностью обратится к http://169.254.169.254/ или к file-URL на вашем сервере приложений и встроит результат в PDF, который кто-то потом скачает
Поэтому по умолчанию HotPDF не читает ни файлы, ни сеть. Изображения и другие ресурсы поступают ровно двумя способами: как data: URI внутри разметки или через обратный вызов OnResource, где ваш код решает, что означает URI, и предоставляет байты:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Отдавать ресурсы только из локального каталога, включённого в белый список. Никогда
  // не передавайте URI HTTP-клиенту и никогда не соединяйте его с путём
  // без предварительной проверки
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Каждый поступивший ресурс всё равно засчитывается против трёх отдельных потолков: сколько ресурсов, сколько байт у каждого и сколько байт в сумме. Обратный вызов, который добросовестно возвращает всё, о чём его просят, невозможно обмануть и заставить исчерпать память документом, который двести раз ссылается на одно и то же изображение весом 50 МБ
Четыре бюджета, один режим сбоя
Узлы парсера, правила CSS, операции вёрстки и ресурсы учитываются независимо, потому что и отказывают они независимо. Документ может быть маленьким и патологически дорогим в вёрстке; другой может быть неглубоким, но с таблицей стилей, специально устроенной так, чтобы взорвать сопоставление селекторов. Исчерпание любого из них вызывает исключение EHPDFHTMLImportBudget — выделенный класс исключений, чтобы исчерпание бюджета можно было перехватывать отдельно от некорректного входа
Статистика сбрасывается в начале каждого вызова RenderHTML5, поэтому цифры описывают один импорт, а не время жизни объекта импортёра. В сервисе, рендерящем недоверенные шаблоны, логируйте ParsedNodeCount, LayoutOperationCount и ResourceRejectCount по каждому документу: растущее число отказов обычно означает, что автор шаблона ссылается на ресурсы, которые ваш обратный вызов не распознаёт, а число операций вёрстки около потолка означает, что следующий чуть больший документ завершится ошибкой
Выбор между импортом HTML и API вёрстки
Импорт HTML выигрывает, когда содержимое создают в виде HTML люди, не являющиеся разработчиками на Delphi, когда шаблоны меняются чаще, чем код, или когда то же самое содержимое нужно ещё и отправлять по почте. Декларативное дерево вёрстки, описанное в статье декларативная вёрстка PDF с тегированным выводом, выигрывает, когда документ генерирует из данных ваш собственный код, когда нужна автоматическая генерация структуры PDF/UA или когда точный контроль над разбиением на страницы важнее удобства авторинга
Они не исключают друг друга. Типичная схема — импорт HTML для тела отчёта, а колонтитулы и блок подписи рисуются напрямую, поскольку это фиксированная геометрия, которой не должен владеть ни один шаблон. Таблицы — единственная область, где стоит измерить оба варианта: сложные финансовые таблицы иногда лучше разбиваются на страницы через выделенный путь для таблиц, описанный в статье генерация таблиц в PDF
Задавайте CreateAcroForms осознанно. При значении «выключено» элементы управления HTML-форм отрисовываются как статичная графика — именно это нужно для печатной выписки. При «включено» они становятся настоящими интерактивными полями AcroForm — именно это нужно для заполняемой формы, а связанное с этим поведение полей описано в статье добавление полей формы в загруженный PDF
Импорт HTML, декларативная вёрстка и API прямой отрисовки работают с одним и тем же объектом документа в Delphi и C++Builder; полный список возможностей — на странице компонента HotPDF Delphi PDF Component