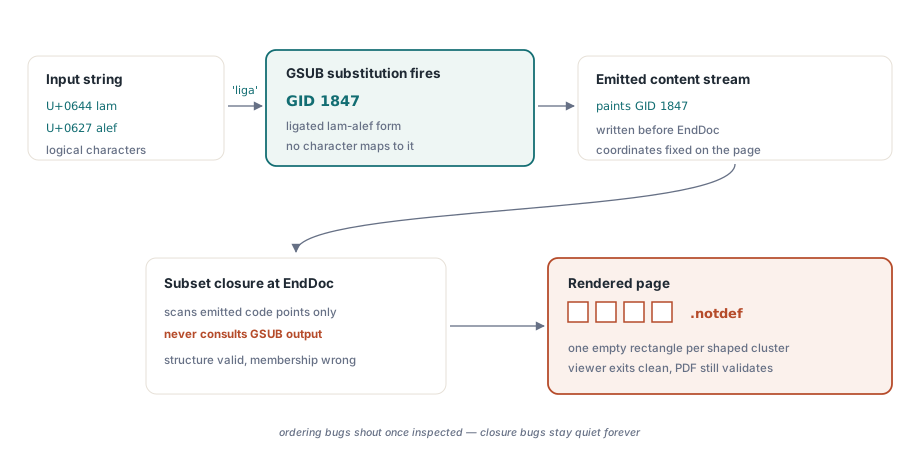
Сформированные глифы рендерятся как рамки .notdef, когда субсеттер шрифта сохраняет только глифы, достижимые из выпущенных кодовых точек. HotPDF, нативный VCL-компонент PDF для Delphi и C++Builder, нёс в себе ровно этот дефект вплоть до версии 2.435.0: вывод OpenType GSUB записывался в внутренний битовый массив использования, который субсеттер декларировал, что будет учитывать, а затем фактически никогда не читал
Это другой сбой, чем описанный в баге EndDoc, молча отключавшем субсеттинг шрифтов. Тот баг был о когда субсеттинг запускался относительно сериализации, и он отключал субсеттинг целиком. Этот — о что содержит субсет, когда субсеттинг запускается точно по расписанию. Конвейер срабатывает в нужный момент, шестибуквенный префикс субсета появляется в /BaseFont в точности как требует ISO 32000-1 §9.6.4, файл становится меньше, каждая латинская страница вычитывается чисто, а арабская страница выходит рядом пустых прямоугольников. Ошибки порядка громки, стоит только присмотреться. Ошибки замыкания молчат вечно, потому что субсет структурно валиден и неверен только в своём собственном списке членства
Почему сформированные глифы рендерятся как .notdef?
Потому что множество кодовых точек, которые выпускает документ, не является множеством глифов, которые документ рисует, а субсеттер, смешивающий эти два, отбрасывает каждый глиф, произведённый формированием. Формирование текста превращает логическую последовательность символов в позиционированную последовательность глифов, и вся его цель — произвести глифы, к которым не отображается ни один единственный входной символ: арабская срединная heh, лигатура fi, деванагари-конъюнкт, контекстная альтернатива, выбранная функцией rclt. Каждый из них — это ID глифа, изготовленный подстановкой GSUB, а не тот, что таблица cmap отдаёт вам для любого символа в вашей строке. Субсеттер, управляемый исключительно cmap, поэтому обходит неверный индекс. Он добросовестно сохраняет каждый глиф, который текст мог бы использовать до формирования, и отбрасывает именно те глифы, которые текст использует после формирования. Затем рендерер запрашивает у встроенного шрифта GID 1847, субсет обнулил эту запись в loca, и вместо неё возвращается индекс глифа 0. Индекс глифа 0 по определению OpenType — это .notdef, поэтому сигнатура сбоя — это пустая рамка, а не неверная буква или сбой. Ничто в PDF не повреждено; шрифт просто не содержит глиф, который запросил поток содержимого
Кодовые точки — не глифы: три источника субсета
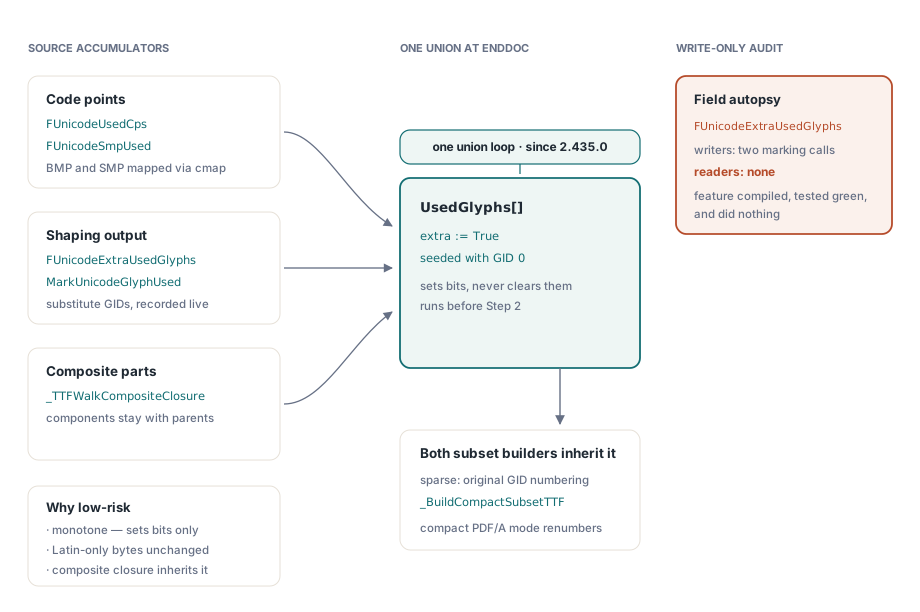
Корректное замыкание субсета должно объединить три независимых источника, каждый со своим накопителем. Первый — множество, производное от кодовых точек: HotPDF накапливает FUnicodeUsedCps по мере выпуска символов BMP и FUnicodeSmpUsed для символов дополнительной плоскости, достигнутых через суррогатные пары, затем отображает каждый через FUnicodeCpToGid в ID глифа. Второй — множество, производное от формирования, ID глифов, произведённых подстановкой GSUB, записанные через MarkUnicodeGlyphUsed и EnableShapingFeatureForSubset в FUnicodeExtraUsedGlyphs. Третий — замыкание составных глифов: глиф, чей numberOfContours равен -1 в glyf, собирается из компонентных ID глифов, и сохранение составного при отбрасывании его компонентов даёт пустой контур вместо .notdef, что, пожалуй, ещё хуже, потому что читается как баг интервалов
HotPDF всегда обрабатывал первый и третий источники. BuildAndApplyUnicodeFontSubset, точка входа субсеттинга, которую EndDoc вызывает перед сериализацией, засеивает массив используемых глифов GID 0, обходит кодовые точки BMP, обходит список использования SMP и передаёт массив построителю субсета, который внутренне разрешает компоненты составных глифов. Второй источник был написан, но никогда не потреблялся, и поскольку эти три источника отказывают на разном содержимом, пробел может скрываться годами в кодовой базе, чей регрессионный корпус в основном латинский
Массив, который был записан и никогда не прочитан
Контракт был задокументирован в трёх местах и соблюдён ни в одном из них. Декларация FUnicodeExtraUsedGlyphs заявляла, что субсеттер EndDoc объединяет его с использованием, производным от кодовых точек; комментарий заголовка на ApplyArabicGSUBRefinement обещал, что каждый выпущенный подставленный GID пропускается через MarkUnicodeGlyphUsed, так что субсеттер втягивает глиф во встроенный шрифт; то же обещание появляется дословно на ApplyArabicGSUBContextualRefinement для пути rclt. Оба вызывающих кода выполнили свою половину. Grep по каждой ссылке на это поле разрешил другую половину примерно за девяносто секунд: одна декларация, одно выделение SetLength внутри RegisterUnicodeTTF, и записи в двух маркирующих процедурах. Ни одного чтения. Это диагностика, которую стоит усвоить, потому что она хорошо обобщается далеко за пределы шрифтов. Когда поле записывается несколькими точками вызова и не читается ни одной, представленная им функциональность не существует, как бы тщательно она ни была прокомментирована. Шаг 1 субсеттера достаточно мал, чтобы прочитать на одном экране, и пробел очевиден, как только знаешь, куда смотреть
// Шаг 1: вывести набор используемых глифов (как это выглядело до 2.435.0)
SetLength(UsedGlyphs, FUnicodeNumGlyphs);
for I := 0 to FUnicodeNumGlyphs - 1 do
  UsedGlyphs[I] := False;
UsedGlyphs[0] := True;                       // .notdef присутствует всегда

for Cp := 0 to $FFFF do                      // источник 1a: кодовые точки BMP
  if (Cp < Length(FUnicodeUsedCps)) and FUnicodeUsedCps[Cp]
     and (Cp < Length(FUnicodeCpToGid)) then
  begin
    GID := FUnicodeCpToGid[Cp];
    if (GID > 0) and (GID < FUnicodeNumGlyphs) then
      UsedGlyphs[GID] := True;
  end;

for I := 0 to High(FUnicodeSmpUsed) do       // источник 1b: кодовые точки SMP
begin
  GID := FUnicodeSmpUsed[I].GID;
  if (GID > 0) and (GID < FUnicodeNumGlyphs) then
    UsedGlyphs[GID] := True;
end;

// источник 2 здесь отсутствовал: ничто никогда не обращалось к FUnicodeExtraUsedGlyphs
Исправление в один цикл и маркировка глифов самостоятельно
Исправление — это объединение, и аргумент его безопасности идёт от направления операции: оно только устанавливает биты, никогда не сбрасывает их, так что ни один глиф, ранее переживавший субсет, не может начать отбрасываться
// v2.435.0: втянуть в субсет дополнительные глифы, порождённые GSUB.
// MarkUnicodeGlyphUsed / EnableShapingFeatureForSubset записывают GID, которые
// произвело формирование, но на которые ни одна выпущенная кодовая точка не отображается напрямую.
for I := 0 to FUnicodeNumGlyphs - 1 do
  if (I < Length(FUnicodeExtraUsedGlyphs)) and FUnicodeExtraUsedGlyphs[I] then
    UsedGlyphs[I] := True;
Три свойства делают это низкорисковым изменением, а не переписыванием шрифтового движка. Оно монотонно, как выше. Оно является пустой операцией на шрифтах, которые никогда ничего не формировали, поскольку FUnicodeExtraUsedGlyphs остаётся полностью False, а байтовый вывод для документа только на латинице не меняется. И оно попадает перед шагом 2, так что оба построителя субсета наследуют его: разреженный построитель, сохраняющий исходную нумерацию GID, и компактный построитель _BuildCompactSubsetTTF, который HotPDF выбирает под PDF/A, чтобы перенумеровать сохранённые глифы в плотный диапазон, уменьшить maxp.numGlyphs и выпустить старо-новое отображение как поток /CIDToGIDMap, требуемый ISO 32000-1 §9.7.4.2. Оба вызывают _TTFWalkCompositeClosure внутренне, так что сформированный глиф, который оказывается составным, теперь тоже тащит за собой свои компоненты. Замыкание составных никогда не было сломано; оно просто никогда не достигалось для этих ID глифов, потому что эти ID глифов не входили в множество, которое оно обходит. Если вы управляете движком GSUB напрямую вместо того, чтобы полагаться на встроенные проходы уточнения, замыкание становится вашей ответственностью, и каждый выпускаемый вами подставленный ID глифа должен быть помечен до того, как EndDoc заморозит множество используемых глифов
var
  Pdf: THotPDF;
  GIDs: array[0..1] of Word;
  LigGID: Word;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'shaped.pdf';
    Pdf.BeginDoc;
    Pdf.RegisterUnicodeTTF('C:\Fonts\NotoNaskhArabic-Regular.ttf');
    Pdf.ShapingFeatures := [sfArabicGSUB, sfStandardLigatures,
                            sfContextualAlternates];

    GIDs[0] := Pdf.GetUnicodeGlyphForCodepoint($0644);   // lam
    GIDs[1] := Pdf.GetUnicodeGlyphForCodepoint($0627);   // alef
    if Pdf.ApplyLigatureSubstitution(GIDs, 0, 'liga', LigGID) then
      Pdf.MarkUnicodeGlyphUsed(LigGID);   // пропустите это, и получите .notdef

    Pdf.EnableShapingFeatureForSubset('rclt');
    Pdf.CurrentPage.RtLTextOut(50, 700, 0, WideString(ArabicText));
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
EnableShapingFeatureForSubset — это пакетный аналог одиночного вызова по GID, и он намеренно консервативен. Он обходит список подстановок GSUB для подстановок, привязанных к одному четырёхбайтовому тегу функции в текущем выбранном пути скрипта и языка, и помечает ID глифов подстановки, которые эти подстановки могут произвести. Это защитная пустая операция, когда шрифт не несёт таблицы GSUB или когда функция отсутствует в этом пути, так что вызывать его безусловно безопасно. Это также переоценка по замыслу: он может сохранять глифы, которые данный документ никогда не рисует. Для субсеттинга избыточное включение стоит байтов, а недостаточное включение стоит корректности, что делает этот компромисс лёгким. Структура этих подстановок и таблиц покрытия, решающих, какие глифы участвуют, разбирается в обзоре стилистических альтернатив GSUB на чистом Delphi
Как доказать, что глиф действительно в субсете?
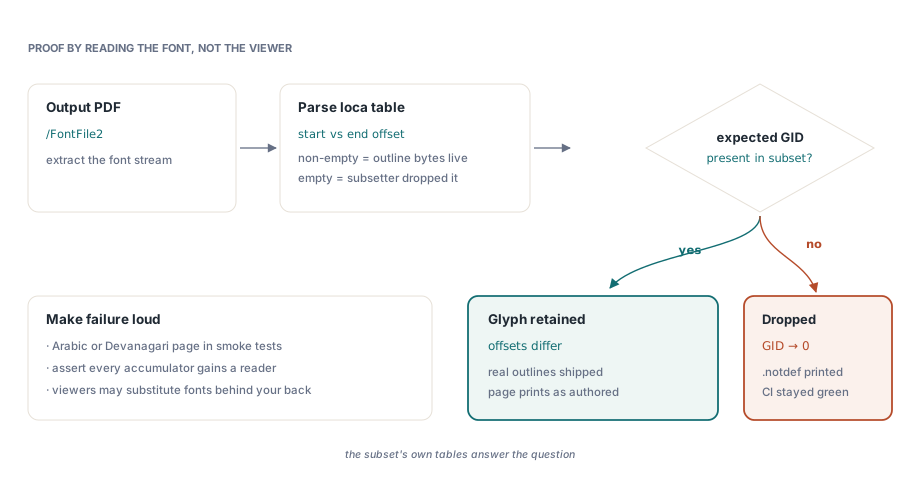
Читая выпущенный шрифт, а не разглядывая страницу в просмотрщике, который может подменять системный шрифт у вас за спиной. Проверка, которая ловит весь этот класс багов, механическая: извлечь поток /FontFile2 из выходного PDF, распарсить loca и подтвердить, что ожидаемый ID глифа несёт непустую запись, то есть его начальное и конечное смещения различаются. Пустая запись — это субсеттер, решивший, что глиф не используется. Две привычки затем сильно затрудняют повторный выпуск этого сбоя. Держите страницу со сформированным скриптом в автоматизированном дымовом корпусе, а не только в наборе ручной вычитки, потому что арабский, деванагари и кхмерский задействуют пути замыкания, которых не затронет никакое количество латинского покрытия. И всякий раз, когда существует накопитель, утверждайте, что что-то его потребляет, поскольку поле только для записи — это функция, которая компилируется, тестируется зелёным на неверном корпусе и ничего не делает
Где исправление останавливается
Замыкание субсета необходимо для рендеринга сформированного глифа, и недостаточно. Глиф также должен быть адресуем из потока содержимого, а это отдельная проблема со своей собственной границей. Встроенные проходы уточнения арабского в HotPDF фиксируют подстановку, только когда каждый подставленный ID глифа достижим через кодовую точку формы представления Unicode посредством обратного скана cmap примерно по 690 кодовым точкам в U+FB50–U+FDFF и U+FE70–U+FEFF. Когда подстановка попадает на ID глифа вне этого диапазона, окно ввода проходит без изменений, вместо выпуска чего-то, что читатель не может адресовать; специфичные для шрифта альтернативы на произвольных ID глифов нуждаются в синтетической кодовой точке частного использования, выделенной в U+E000–U+F8FF, чтобы пронести их через путь выпуска. Так что честный итог в том, что исправление 2.435.0 убрало жёсткий блокер, а не завершило историю. До него глиф мог быть корректно сформирован, корректно выпущен и всё же исчезнуть на этапе субсеттинга, что означало, что движку формирования нельзя было доверять от начала до конца, сколь бы хороши ни были его подстановки. То, что осталось, — это адресуемость, и это ограничение по крайней мере отказывает видимо в точке выпуска, а не молча на этапе сборки, выполняющемся после всего, за чем вы наблюдали. Для стороны выпуска того же конвейера см. руководство по формированию арабского и RTL-текста в PDF на Delphi
Субсеттинг шрифтов, движок GSUB и формирование сложных скриптов, описанные здесь, поставляются в стандартном компоненте HotPDF для Delphi и C++Builder; страница продукта содержит полный справочник API для названных выше вызовов шрифтов Unicode и формирования