PDFlibPas, PDF Library for Delphi, импортирует TIFF-изображения, чьё JPEG-сжатие выходит за рамки 8-битного baseline: 12-битный extended sequential (SOF1), lossless по Хаффману (SOF3), арифметическое кодирование (SOF9 и SOF10) и JPEG старого стиля TIFF 6.0 со смещениями таблиц. Поскольку PDF-фильтр DCTDecode переносить такие процессы не может, PDFlibPas декодирует их в нативном Pascal и встраивает отсчёты без потерь, по 8 или 16 бит на компоненту
Полный набор требует v3.724.0 и выше, и нацелен он прямо на TIFF от сканеров, медицинского и научного захватывающего софта и архивных систем, замороженных в 1990-х. Ниже — почему эти варианты нельзя скопировать в PDF как есть, как PDFlibPas их приземляет и какие Pascal-ловушки попались по дороге
Почему 12-битный JPEG нельзя передать в PDF напрямую?
12-битный JPEG нельзя пропустить насквозь, потому что в PDF нет фильтра, который обязан его декодировать. ISO 32000-1 §7.4.8 определяет DCTDecode вокруг baseline-формата JPEG с прогрессивным расширением, добавленным в PDF 1.3. Ничто в этом пункте не покрывает 12-битную точность отсчётов, lossless-процесс из приложения H ITU-T T.81 или арифметический энтропийный кодер из приложения D. Ридер, встретивший SOF1 12-битный кадр или маркер SOF9 внутри DCTDecode-потока, вправе не нарисовать ничего, и большинство вьюеров поступает именно так
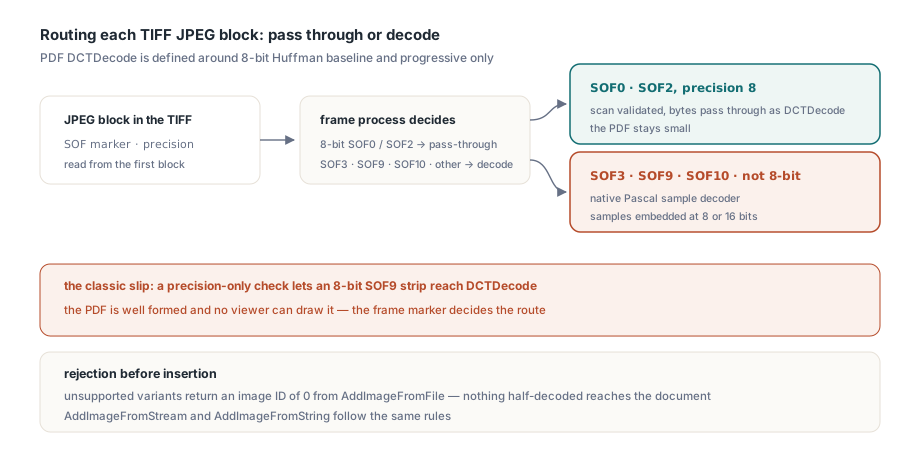
Для 8-битных baseline- и прогрессивных сканов по Хаффману, из которых состоят большинство JPEG-в-TIFF файлов, PDFlibPas по-прежнему валидирует каждый скан и передаёт сжатые байты насквозь как DCTDecode — это держит PDF компактным. Всё остальное декодируется. PDFlibPas читает маркер кадра и точность отсчётов первого JPEG-блока, и, найдя SOF3, SOF9, SOF10 или точность, отличную от 8, прогоняет страницу через сэмпловый декодер вместо сквозного пути. Обнаружение арифметического кодирования по маркеру кадра важнее, чем звучит: проверка, смотрящая только на точность отсчётов, пропустит классический TIFF с 8-битной полосой SOF9 в путь DCTDecode — и на выходе PDF, который ридеры не смогут показать
Что PDFlibPas вместо этого записывает в PDF
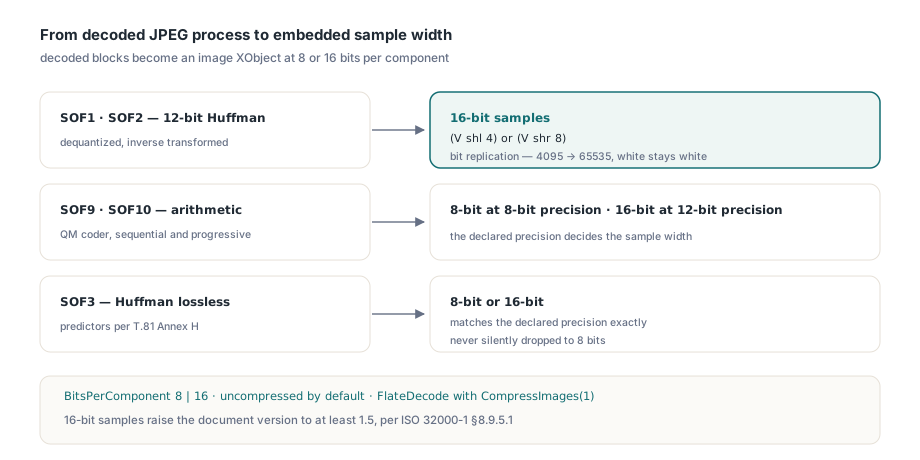
PDFlibPas превращает декодированные JPEG-блоки в обычный image XObject с BitsPerComponent 8 или 16. По умолчанию отсчёты хранятся без сжатия; вызовите CompressImages(1) до добавления изображения, и PDFlibPas запишет их с FlateDecode. ISO 32000-1 §8.9.5.1 разрешает 16 бит на компоненту с PDF 1.5, поэтому PDFlibPas поднимает версию документа хотя бы до 1.5 всякий раз, когда добавляется изображение с 16-битными отсчётами. Это касается и много-полосных, и тайловых изображений, чей корневой объект — Form XObject без собственного BitsPerComponent, который можно было бы осмотреть
Отображение фиксировано для каждого JPEG-процесса:
- 12-битный JPEG по Хаффману (sequential SOF1, прогрессивный SOF2) деквантуется, подвергается обратному преобразованию и расширяется до 16-битных отсчётов
- JPEG с арифметическим кодированием (sequential SOF9, прогрессивный SOF10) даёт 8-битные отсчёты при 8-битной точности и 16-битные при 12-битной
- lossless JPEG по Хаффману (SOF3) даёт 8-битные или 16-битные отсчёты, в точности совпадающие с заявленной точностью
Расширение с 12 до 16 бит использует репликацию битов, (V shl 4) or (V shr 8), поэтому 4095 отображается в 65535, а белый остаётся белым вместо упора в 65520. PDFlibPas никогда за спиной не бросает такие изображения до 8 бит. Когда библиотека растеризует такую страницу под собственную поверхность вывода, она берёт старший байт каждого отсчёта, но встроенное изображение в PDF хранит все шестнадцать
Цена — размер файла: даже с CompressImages(1) 16-битные отсчёты во Flate тяжелее исходных DCT-данных, а без него тяжелее ещё. Для диагностических и архивных сценариев такой размен обычно верен. Если для конкретной задачи размер важнее, гид по уменьшению размера PDF-файлов на Delphi показывает, куда реально уходят байты
Импорт этих TIFF через TPDFlib
Вызывающий код не меняется вообще. TPDFlib.AddImageFromFile(Const FileName: WideString; Options: Integer): Integer принимает номер TIFF-страницы с 1 в Options и возвращает идентификатор изображения или 0, когда страницу импортировать нельзя. Неподдерживаемые JPEG-варианты отвергаются до вставки изображения, так что 0 означает: ничего полудекодированного в документ не попало
uses
  PDFlibrary;

function TiffToPdf(const TiffName, PdfName: WideString): Boolean;
var
  Lib: TPDFlib;
  Page, PageCount, ImageID: Integer;
  DPI, W, H: Double;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    Lib.SetMeasurementUnits(0);   // пространство пользователя по умолчанию, 1/72 дюйма
    Lib.SetOrigin(1);             // начало сверху-слева для DrawImage
    Lib.CompressImages(1);        // Flate для декодированных отсчётов
    PageCount := Lib.GetImagePageCount(TiffName);
    if PageCount = 0 then
      Exit;
    for Page := 1 to PageCount do
    begin
      ImageID := Lib.AddImageFromFile(TiffName, Page);  // Options = страница TIFF
      if ImageID = 0 then
        Exit;                     // неподдерживаемые или повреждённые данные
      Lib.SelectImage(ImageID);
      case Lib.ImageResolutionUnits of
        2: DPI := Lib.ImageHorizontalResolution;          // точек на дюйм
        3: DPI := Lib.ImageHorizontalResolution * 2.54;   // точек на см
      else
        DPI := 0;
      end;
      if DPI <= 0 then
        DPI := 300;
      W := Lib.ImageWidth * 72 / DPI;
      H := Lib.ImageHeight * 72 / DPI;
      if Page > 1 then
        Lib.NewPage;
      Lib.SetPageDimensions(W, H);
      Lib.DrawImage(0, 0, W, H);
    end;
    Result := Lib.SaveToFile(PdfName) = 1;
  finally
    Lib.Free;
  end;
end;
Ветвления по форматам не нужно, и AddImageFromStream с AddImageFromString следуют тем же правилам для TIFF-данных в памяти
JPEG старого стиля: таблицы по смещениям, полосы без заголовков
С v3.713.0 PDFlibPas импортирует TIFF со старым JPEG (Compression = 6), чьи таблицы приходят из тегов-смещений JPEGQTables, JPEGDCTables и JPEGACTables или из потока только-таблиц JPEGInterchangeFormat. Секция 22 TIFF 6.0 определяла эту раскладку, а TIFF Technical Note 2 позже заменила её на Compression = 7 с общим тегом JPEGTables, но сканеры годами продолжали писать старую форму
Сторона контейнера — BigTIFF и тайловые раскладки — раскрыта в разборе укрепления TIFF-декодера; здесь фокус на JPEG-полезной нагрузке. Каждый тег-смещение таблицы указывает на сырую 64-байтовую таблицу квантования или на таблицу Хаффмана из 16 счётчиков и её значений, по записи на компоненту. PDFlibPas превращает их в сегменты DQT и DHT внутри синтезированного потока JPEGTables. Каждая полоса голых энтропийно-кодированных данных получает собственный заголовок: SOI, маркер кадра с числом строк этой полосы, DRI, если задан JPEGRestartInterval, SOS, энтропийные данные и EOI. Полосы нельзя склеить в один скан: JPEG старого стиля сбрасывает DC-предсказание на каждой границе полосы
Две детали легко сделать неправильно. Три компоненты YCbCr-изображения часто указывают смещениями таблиц на одни и те же байты, поэтому PDFlibPas дедуплицирует таблицы по содержимому, прежде чем раздавать номера таблиц. Если у одного класса остаётся больше двух таблиц Хаффмана, синтезированный кадр берёт SOF1 вместо SOF0: baseline-кадр может ссылаться лишь на две DC- и две AC-таблицы. Когда JPEGInterchangeFormat указывает на полный JPEG-поток со сканами, PDFlibPas трактует его как целое изображение и импортирует одной полосой нового стиля. Lossless, тайловый и раздельно-плоскостной старый JPEG отвергается с явной ошибкой, а не угадывается — конвертируйте такие файлы в JPEG нового стиля выше по конвейеру
Почему CMYK JPEG внутри TIFF выходит инвертированным?
CMYK JPEG внутри TIFF выходит инвертированным, когда импортёр применяет Adobe-соглашение APP14, принадлежащее самостоятельным JPEG-файлам. Photoshop пишет в самостоятельные JPEG инвертированный CMYK, поэтому производители PDF традиционно добавляют /Decode [1 0 1 0 1 0 1 0] для компенсации. TIFF PhotometricInterpretation 5 определяет отсчёты как количества краски, где 0 означает «краски нет», а массовые TIFF-ридеры берут декодированные JPEG-отсчёты как есть, не глядя на APP14
PDFlibPas встраивает JPEG-сжатые CMYK-полосы TIFF без инвертированного массива Decode — есть маркер APP14 или нет. Флаг трансформации в APP14 по-прежнему решает, конвертировать ли YCCK в CMYK, и DCTDecode делает этот шаг сам. Самостоятельные JPEG-файлы с четырьмя компонентами сохраняют инвертированное Adobe-соглашение: одни и те же JPEG-байты обрабатываются по-разному в зависимости от контейнера, как того требуют оба формата
Почему lossless-декодирование JPEG ломается на Pascal-сдвиге?
Lossless-декодирование JPEG ломается в Pascal, потому что предикторам 5 и 6 нужен арифметический сдвиг вправо, а Pascal-овский shr — логический. SOF3 предсказывает каждый отсчёт по соседям слева (Ra), сверху (Rb) и сверху-слева (Rc) и кодирует только разность. Из семи предикторов таблицы H.1 в T.81 предиктор 5 — это Ra + ((Rb - Rc) >> 1), предиктор 6 — Rb + ((Ra - Rc) >> 1), и разность в скобках уходит в минус всякий раз, когда верхне-левый сосед ярче. Скормите отрицательный Integer оператору shr — знаковый бит станет битом мантиссы, и изображение рассыплется в шум
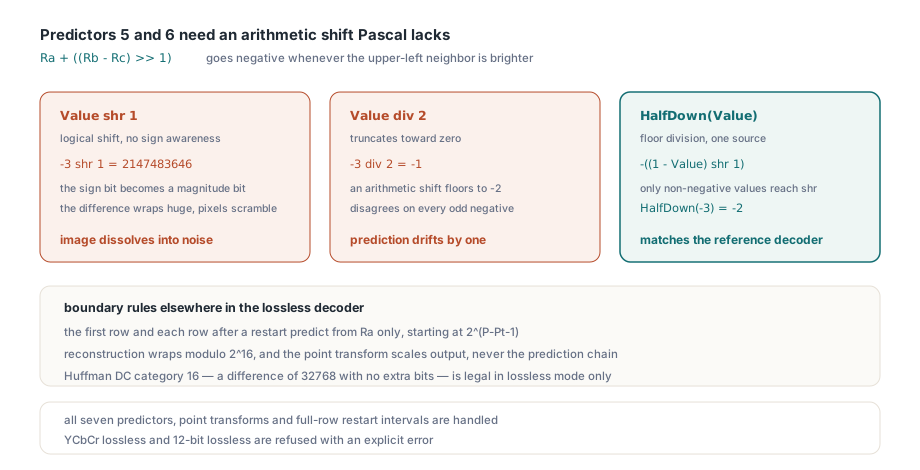
Замена сдвига на div 2 тоже не лечит. div усекает к нулю, а арифметический сдвиг округляет к минус бесконечности, и на каждом нечётном отрицательном значении они расходятся. В Free Pascal есть SarLongint в юните System; в Delphi аналога нет, поэтому PDFlibPas использует хелпер, компилирующийся одинаково на обоих:
// Арифметический сдвиг вправо на один разряд: floor(Value / 2)
// shr — логический сдвиг, а div 2 усекает к нулю
function HalfDown(Value: Integer): Integer;
begin
  if Value >= 0 then
    Result := Value shr 1
  else
    Result := -((1 - Value) shr 1);
end;

// Value = -3:  -3 shr 1 = 2147483646,  -3 div 2 = -1,  HalfDown(-3) = -2
Про сторону разрядностей той же серии проблем — ловушки Longint и указателей на Delphi Linux64
У остального lossless-декодера свои правила границ. Первая строка — и первая строка после каждого маркера перезапуска — предсказывает только по левому соседу и стартует с 2^(P−Pt−1) для точности P и точечного преобразования Pt; каждая следующая строка стартует с отсчёта выше. Реконструкция заворачивается по модулю 2^16, а точечное преобразование масштабирует только вывод, никогда цепочку предсказания. DC-категория 16 по Хаффману — разность 32768 без дополнительных бит — легальна только в lossless-режиме, поэтому парсер таблиц должен принять её ещё до того, как узнает, какой процесс объявит кадр
PDFlibPas поддерживает все семь предикторов, точечные преобразования и интервалы перезапуска, покрывающие целые строки. Точность JPEG обязана равняться BitsPerSample и быть 8 или 16, каждая компонента обязана иметь сэмплирование 1x1. Lossless-данные YCbCr и 12-битный lossless JPEG отвергаются с явной ошибкой
12-битный DCT и арифметическое кодирование на чистом Pascal
12-битный и арифметический декодеры в PDFlibPas делят одно обратное DCT и различаются только энтропийным декодированием. В 12-битном JPEG по Хаффману DC-категории достигают 15, AC — 14, таблицы квантования могут нести 16-битные записи, а DC-предсказание сбрасывается на каждом скане и каждом перезапуске. Коэффициенты держатся в зигзаг-порядке до деквантования, которое обязано использовать значение квантования на том же зигзаг-индексе, и лишь затем переходят в естественный порядок для разделяемого двухпроходного IDCT. Декодированные отсчёты ложатся в пределах ±1 от независимого референс-декодера с плавающей точкой
Арифметическое кодирование заменяет Хаффмана QM-кодером из приложения D к T.81: таблица вероятностных состояний на 114 записей, DC-область статистики на 64 корзины и AC-область на 256, управляемые параметрами кондиционирования из сегмента DAC (умолчания L = 0, U = 1, Kx = 5). Статистика, DC-контекст и предсказание сбрасываются на каждом интервале перезапуска и в начале каждого скана. Вот почему PDFlibPas сохраняет сегменты DAC при нормализации общего JPEGTables для арифметических изображений: выбросите их — и каждая полоса декодируется с неверной моделью статистики
v3.723.0 добавил в эти декодерные пути субдискретизированные компоненты и конверсию YCbCr в RGB по уравнениям JFIF, а v3.724.0 добавил прогрессивные сканы для 12-битного Хаффмана (SOF2) и арифметики (SOF10). Субдискретизированная хрома реплицируется до полного разрешения, а не сглаживается — ровно то, что выдаёт референс-декодер с выключенным сглаживанием хромы. Иерархический JPEG и lossless JPEG с арифметическим кодированием (SOF11) отвергаются с явной ошибкой
Тестирование бинарных JPEG-фикстур на Delphi
Собранные вручную JPEG-фикстуры в unit-тестах Delphi могут падать так, что выглядит в точности как баг декодера. Строковая константа из символов #$xx длиннее 255 символов типизируется как UnicodeString, и присваивание её AnsiString конвертирует её через активную кодовую страницу. Байты $80–$9F, рядовые в энтропийно-кодированных данных, переписываются на входе. Сборка заголовков маркеров в рантайме несёт ту же ловушку: в Delphi AnsiChar + AnsiChar даёт UnicodeString, поэтому добавляйте одиночные байты к AnsiString или пишите их через SetLength и индексное присваивание. Для фикстур храните hex-текст и декодируйте его в рантайме:
uses
  SysUtils, PDFlibrary;

function HexToBytes(const Hex: AnsiString): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Hex) div 2);
  for I := 1 to Length(Result) do
    Result[I] := AnsiChar(StrToInt('$' + string(Copy(Hex, I * 2 - 1, 2))));
end;

// Фикстура остаётся чистым ASCII, так что ни одна кодовая страница её не тронет
ImageID := Lib.AddImageFromString(HexToBytes(TiffHex), 1);
Генерируя тестовые изображения, учтите: jpegtran -arithmetic пишет sequential SOF9, для SOF10 нужен ещё -progressive. И ненулевой идентификатор изображения доказывает только, что импорт принят. Отрендерьте страницу и сравните пиксели: ошибка сквозного пропуска выдаёт корректный по форме PDF, который ни один вьюер не нарисует
Перенос архивов старых сканов в PDF
Такие JPEG-варианты имеют привычку всплывать разом при миграции архива. PDFlibPas читает 12-битный, lossless, арифметический и старый JPEG в TIFF через тот же вызов AddImageFromFile, что и всё остальное, сохраняет полную точность в PDF и отвергает редкие процессы за пределами этого набора с явной ошибкой. О лицензировании, полном списке возможностей и пробных загрузках — на странице продукта PDFlibPas PDF Library for Delphi