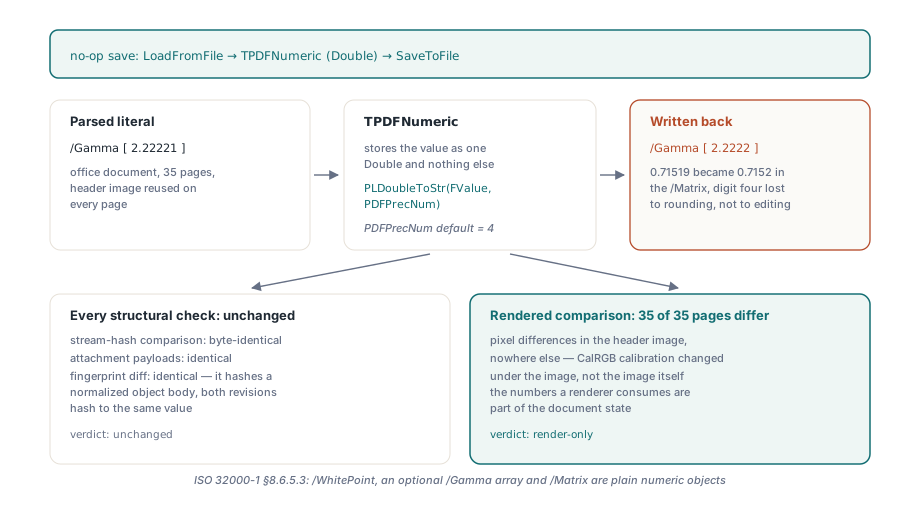
Загрузите калиброванный PDF, ничего не меняйте, сохраните под новым именем и сравните словарь цветового пространства: вошли /Gamma [2.22221 2.22221 2.22221], вышли /Gamma [2.2222 2.2222 2.2222]. Писатель переформатировал число, которого никогда не должен был касаться, и страница теперь рендерится в чуть других цветах. Лекарство — трактовать каждое разобранное десятичное как две вещи сразу: значение для арифметики и литерал для вывода, и продолжать выдавать литерал, пока кто-то реально не присвоит новое значение
Почему сохранение без правок может сдвинуть цвета CalRGB
Пиксели сдвигаются, потому что рендереру достаются чуть другие калибровочные данные при идентичных байтах изображения. ISO 32000-1 §8.6.5.3 определяет цветовое пространство CalRGB через обязательный /WhitePoint, опциональный трехэлементный массив /Gamma и опциональный девятиэлементный /Matrix, и все они — простые числовые объекты в словаре цветового пространства. Пропустите их через Double и форматтер, зафиксированный на четырех знаках, и 2.22221 становится 2.2222, а элемент матрицы 0.71519 становится 0.7152. Значение гаммы — экспонента, применяемая к каждой компоненте каждого пикселя, проходящего через это пространство, так что изменение вылезает всюду, где пространство используется
Для файла, объявляющего одно пространство CalRGB для изображения шапки, переиспользуемого на 35 страницах, все 35 шапок рендерятся со сдвинутыми цветами, и больше ничего на этих страницах не меняется. Проверки, за которые люди тянут первыми, возвращаются чистыми. Хэш декодированных байтов потока сравнивает данные изображения, а данные изображения действительно идентичны; повреждение сидит в словаре. Ревизионный диф, описанный в статье об уровне модификации, снимает отпечаток нормализованного тела объекта, так что обе ревизии хэшируются там в одно значение тоже. Сравнение отрендеренных страниц — вот что это ловит. Для любого конвейера, переписывающего PDF, порожденные чужим софтом, мы бы поставили постраничное сравнение рендера впереди всех структурных проверок
Как вещественное число PDF вообще может выглядеть
ISO 32000-1 §7.3.3 определяет вещественное число как десятичную строку: опциональный знак, цифры, точка, еще цифры. Никакой радиексной записи. Никакой экспоненты. Приложение C, перечисляющее пределы реализаций, ожидает, что примерно пять значащих десятичных цифр в дробной части будут соблюдены. Умолчание вывода в четыре знака, следовательно, уже сидит на цифру ниже того, что спецификация велит читателям хранить, и файл ничем не провинился, использовав пять
Возле нуля наивный форматтер работает хуже, чем теряет цифру. Обычный способ напечатать Double на N знаков — умножить на 10^N, округлить до целого и выписать цифры, и когда это целое — ноль, на выходе 0. Подайте ему первый операнд 0.00001 0 0 1 0 0 cm на четырех знаках, и результат — 0 0 0 1 0 0 cm, сингулярная матрица, от которой все нарисованное под ней исчезает. Элемент /Matrix из -0.000012345 идет тем же путем
Когда PDF Library for Delphi (PDFlibPas) приходится форматировать Double самой, она хранит запрошенное число значащих цифр для ненулевого значения меньше шага точности вместо записи 0. На четырех знаках 0.00001 пишется как 0.00001 и 0.0000123 как 0.0000123; только величины ниже примерно 5E-16 все еще выходят как 0. Это держит свеженаписанные числа разумными. Разобранное число, которому переформатирование не понадобилось, — другое дело, и библиотека обращается с ним, вообще не переформатируя
Как PDFlibPas хранит разобранный литерал
TPDFStructure.Decode держит исходный текст каждого стандартного вещественного, который токенизирует — токен с десятичной точкой и без маркера экспоненты, — рядом с конвертированным Double. TPDFNumeric.Output пишет этот текст обратно всякий раз, когда он присутствует, и форматирует Double на PDFPrecNum структуры, только когда его нет. TPDFNumeric.SetTo отбрасывает текст, потому что отредактированное число — новое число и должно следовать текущей точности вывода
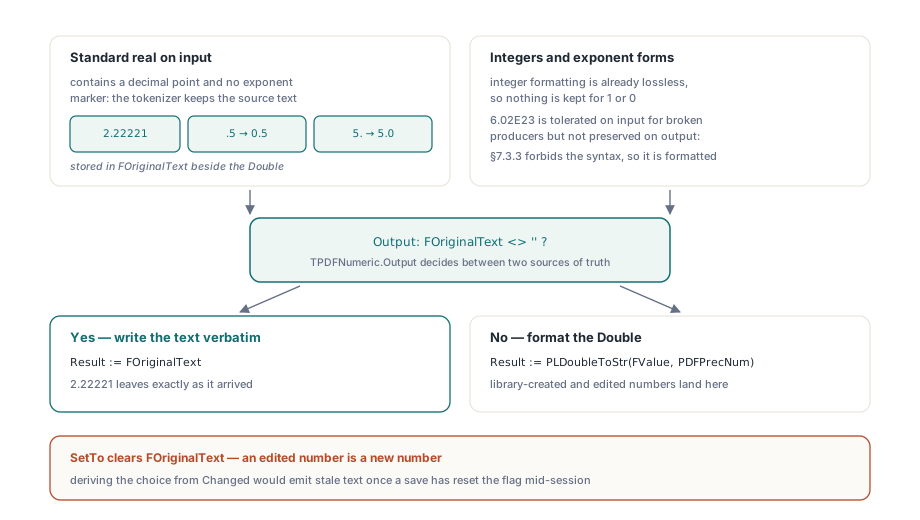
Привязать сброс к SetTo было осознанным решением. Соблазнительный обход — выдавать исходный текст, пока не выставлен флаг Changed объекта, ведь этот флаг уже есть на каждом объекте. Конвейер сохранения, однако, очищает Changed, как только объект записан, так что значение, отредактированное, сохраненное и отредактированное снова в той же сессии, вернулось бы к выдаче протухшего литерала на втором сохранении. Очистка текста внутри самого присваивания означает, что литерал и значение никогда не могут разойтись
Несколько границ намеренные. Целые не хранятся текстом, потому что форматирование целых уже без потерь. Экспоненциальные формы вроде 6.02E23 принимаются на входе ради производителей, которые их пишут, но на выходе форматируются как любое число, порожденное библиотекой, поскольку копирование их назад увековечило бы синтаксис, который §7.3.3 исключает. Токенизатор также применяет свой обычный мелкий ремонт перед сохранением текста: литерал с ведущей точкой вроде .5 хранится как 0.5, литерал с хвостовой точкой вроде 5. как 5.0. Каждый читатель считает каждую пару одним числом, и починенное написание принимается намного шире
Сниппет ниже прогоняет значения CalRGB через слой объектов напрямую, так что каждое правило видно без открытия PDF-файла. Строки Assert — проверки, которые мы советуем добавить в ваши собственные тесты; это не вызовы библиотеки
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Ваша собственная проверка: нетронутый вход переживает дословно, включая
    // значение, которое наивный четырехзнаковый форматтер схлопнул бы в 0
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Правка отбрасывает исходный текст и следует PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Крошечные новые значения хранят значащие цифры вместо превращения в 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Понижение точности задним числом не достает нетронутый вход
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Одна ловушка при написании таких утверждений: Round в Delphi использует банковское округление, и 0.000012345 * 1e8 вычисляется в двоичном виде как 1234.4999…, а не 1234.5. Мы врезались в это значение, проверяя путь форматирования возле нуля. Берите тестовые входы, не являющиеся двоичными полуточками, всякий раз, когда утверждение зависит от того, как округляется последняя цифра
Что контролирует SetPrecision?
TPDFlib.SetPrecision задает число десятичных знаков у чисел, которые пишет библиотека: графика, нарисованная через painter, числа, созданные из Double, например через NewNumeric, и разобранные значения, измененные с тех пор через SetTo. Он принимает от 2 до 8 и возвращает 0 для всего вне диапазона. Разобранное десятичное, которое никто не редактировал, хранит свой входной текст, каково бы ни было настроение, и смена настройки после LoadFromFile не достает назад в него. Источник, переданный в SetObjectFromString, идет через тот же токенизатор и хранится так же
Наша рекомендация — не трогать SetPrecision, если только геометрии, которую вы генерируете, не нужны более мелкие шаги. Поднимать его ради защиты входных файлов не покупает ничего, потому что нетронутый вход уже хранит собственные цифры, а каждое нарисованное число делает длиннее. Пять знаков — разумный выбор для рисовательной работы с долями пункта; восемь в основном раздувает потоки содержимого
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Управляет числами, записываемыми отсюда и дальше; разобранные массивы /Gamma,
    // /Matrix и /WhitePoint хранят свой исходный текст
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // рисованные числа используют пять знаков
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Потоки содержимого: правки хранят операнды, нормализация — opt-in
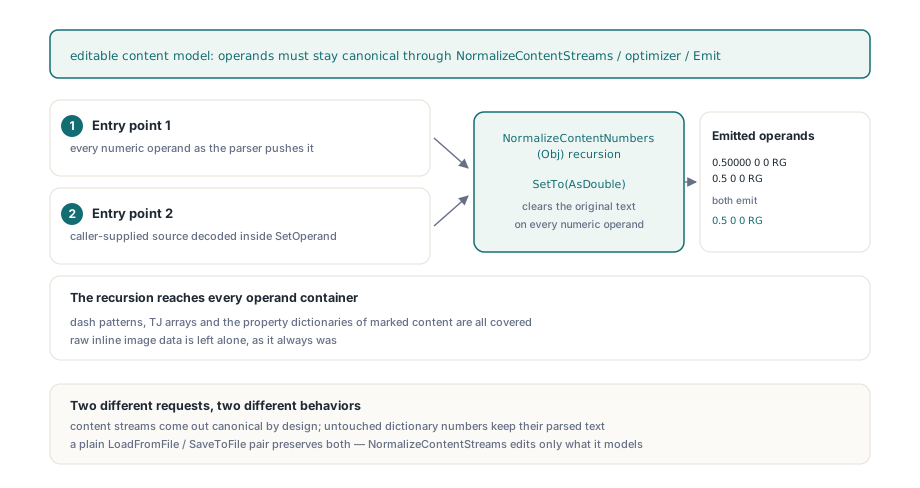
Редактируемая модель содержимого по умолчанию хранит текст операндов и канонизирует числа, только когда канонический вывод — смысл вызова. TPDFContentProgram.CanonicalNumbers по умолчанию False, так что слой, возвращенный ParsePageContentLayer — та же модель, на которой построен трекер графического состояния, — переиздает каждый нетронутый числовой операнд ровно как написано. Правки страницы, переписывающие целый слой, включая ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths и вашу собственную программу, записанную назад через WritePageContentLayer, меняют только операнды, которых коснулась правка
Другое умолчание выглядит опрятнее: канонизировать при каждом разборе, чтобы путь редактирования и NormalizeContentStreams всегда давали одно написание. Мы считаем его неправильным умолчанием для редактирования. Вызов ScalePage на слое, содержащем 0.123456 w, записал бы назад 0.1235 w, и каждый другой операнд слоя был бы переписан тоже, хотя вызывающий просил только масштабирование. Каноническая форма принадлежит операциям, чей смысл — сравнимый вывод
Те операции его и получают. NormalizeContentStreams и оптимизатор содержимого на сохранении парсят с CanonicalNumbers равным True, потому что их работа — стабильный вывод из произвольного входа; если бы 0.50000 0 0 RG и 0.5 0 0 RG выдавались по-разному, каждое сравнение ниже по потоку дрейфовало бы вместе с привычками форматирования производителя. Канонизация рекурсирует через массивы и словари, так что штрих-паттерны, массивы TJ и словари свойств marked-content покрыты, а сырые данные inline-изображений оставлены в покое. Операнды, поданные через SetOperand, канонизируются, что бы ни говорил флаг. Программа содержимого несет собственное хранилище чисел, зафиксированное на четырех знаках, независимо от SetPrecision, так что отредактированный операнд выходит с четырьмя. Только Parse читает флаг, что означает: его надо выставить до парсинга; для программы, которую ParsePageContentLayer уже распарсил, выставьте флаг и вызовите Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Меняем одну толщину линии; каждый другой операнд хранит свой исходный текст
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // выдается как 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Каноническая копия только для сравнения, не пишется назад:
      // Parse — единственный читатель флага, поэтому выставьте его и перепарсите
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit теперь пишет 0.50000 и 0.5 одинаково
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Сложив вместе, правило для вызывающих короткое. Обычные LoadFromFile и SaveToFile оставляют нетронутые потоки содержимого и нетронутые числа словарей как были. Страница, отредактированная через модель содержимого, хранит текст каждого операнда, которого правка не меняла. NormalizeContentStreams, оптимизатор, работающий при сжатии содержимого на сохранении, и любая программа, распарсенная с CanonicalNumbers равным True, дают канонические числа по дизайну, а остальной документ все еще сохраняется
Сколько это стоит и где кончается гарантия
Каждый TPDFNumeric несет одну лишнюю ссылку на AnsiString, и каждое разобранное десятичное держит свой исходный текст живым, пока жив объект. На документе с миллионами вещественных чисел это измеримая память, и ее место в любом бенчмарке больших документов, который вы запускаете. Гарантия также ограничена собственным документом числа. Копирование объектов между документами или пересборка значений через объектный API производят новые числа, а новые числа следуют точности вывода
Сохраненные числа и побайтово идентичный вывод — отдельные свойства. Пара загрузки и сохранения нетронутого документа хранит калибровочные числа, которые потребляет рендер, но побайтовая идентичность зависит еще и от нумерации объектов, сжатия потоков и идентификатора трейлера, разобранных в статье о детерминированном PDF ID. Диф отпечатков продолжает хэшировать нормализованное тело, что значит: различия округления в файлах, написанных другими инструментами, лежат вне того, что он сравнивает; сравнение рендера остается проверкой для них
Обработка чисел и точная семантика SetPrecision разобраны в справочнике losLab PDF Developer Library, вместе с вызовами модели содержимого, использованными выше