PDF Library for Delphi умеет объединять изображения внутри PDF, которые выглядят одинаково, но не идентичны побайтово, через DeduplicateSimilarImages. Точная дедупликация объединяет только изображения с совпадающими словарями и закодированными полезными данными; эта же функция сравнивает то, как изображения выглядят на самом деле, используя перцептивный хеш плюс два порога ошибки пикселей, и перенаправляет каждую ссылку на единый канонический объект
Файлы, на которых это окупается, — те, что разрослись случайно. Пакет сканов, где каждая страница несёт один и тот же логотип, перекодированный разными сканерами. Отчёт, собранный из источников, каждый из которых встроил один и тот же график с чуть разным качеством JPEG. Каталог, чьи миниатюры были перегенерированы двумя инструментами. В каждом случае файл содержит множество копий одной картинки, и точная дедупликация не может тронуть ни одну из них
Что должно означать «достаточно похожи»
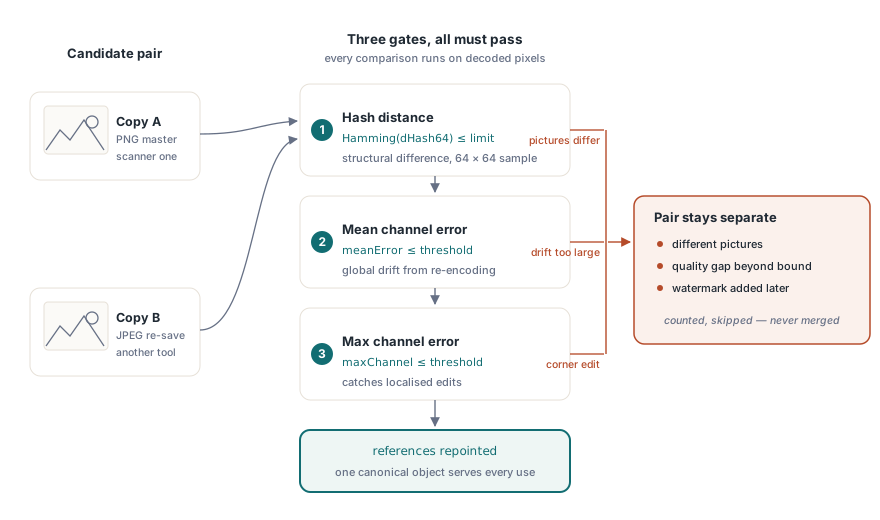
Прежде чем два изображения объединяются, должны выполняться сразу три порога, и каждый ловит свой вид различий. Расстояние перцептивного хеша ограничивает структурное различие: 64-битный разностный хеш вычисляется из выборки 64 на 64 декодированного изображения, а допустимое расстояние Хэмминга составляет от 0 до 7. Средняя ошибка по каналам ограничивает общий дрейф, который даёт перекодирование. Максимальная ошибка по одному каналу ограничивает локализованное различие, которое даёт небольшая правка
Требование выполнения всех трёх и делает слияние оправданным. Изображение, отличающееся водяным знаком в одном углу, имеет низкую среднюю ошибку и высокую максимальную ошибку, поэтому порог максимальной ошибки его отклоняет. Изображение, которое было перекодировано, имеет небольшую ошибку повсюду, поэтому оно проходит. Именно это различие и нужно провести оптимизатору размера
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Расстояние хеша 2, средняя ошибка 2, ошибка одного канала 4.
    // Параметры могут запросить пробный прогон, чтобы ничего не менялось
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
Семантическая идентичность идёт раньше визуального сходства
Прежде чем сравнивать хоть один пиксель, изображения-кандидаты должны совпадать семантически. Библиотека строит устойчивую сигнатуру из полного словаря изображения, исключая /Length, /Filter и /DecodeParms, поэтому размеры, цветовое пространство, битовая глубина, маски, массив /Decode, интерполяция, принадлежность опциональному содержимому и метаданные — всё это должно совпасть
Такой порядок предотвращает целый класс неверных слияний. Два изображения могут выглядеть идентично в выборке 64 на 64 и вести себя по-разному на странице: одно с истинным /Interpolate и одно без него будут по-разному сглаживаться при масштабировании, а изображение, принадлежащее группе опционального содержимого, исчезнет, когда этот слой скрыт. Слияние через эти границы даёт документ, который меньше и при этом неверен
Сканируются только косвенные Image XObject. Встроенные изображения — другая конструкция с другой экономикой, а изображения, которые невозможно декодировать, консервативно пропускаются и учитываются, а не объединяются на веру — нет пиксельных доказательств, нет слияния
Как поиск остаётся дешёвым
Сравнение каждого изображения с каждым другим — квадратичная сложность, недопустимая на документе, содержащем тысячи изображений. Поэтому хеш разбивается на восемь 8-битных полос с упорядоченным индексом по каждой
Остальное делает принцип Дирихле: если два хеша различаются не более чем на 7 бит, они обязаны точно совпасть как минимум в одной из восьми полос. Поиск кандидатов полоса за полосой поэтому находит каждое допустимое совпадение без исчерпывающего попарного сканирования, и опубликованный предел в 7 существует именно потому, что гарантия работает лишь до этого расстояния
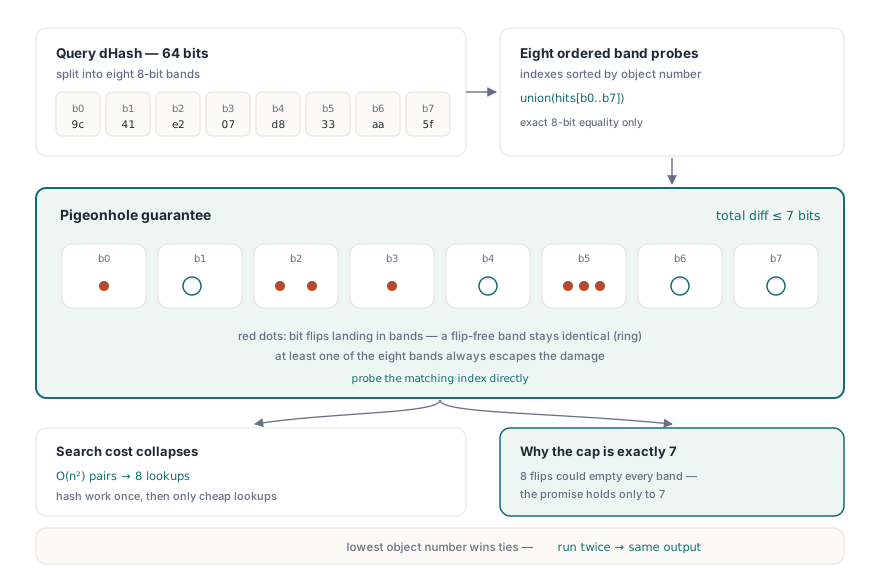
Кандидаты и совпадения полос упорядочиваются детерминированно по номеру объекта и поколению, и канонической становится запись с наименьшим номером объекта. Это делает вывод воспроизводимым: запуск оптимизатора дважды на одном и том же входе даёт один и тот же канонический выбор, что важно при сравнении или подписании результата
Пробные прогоны и честная отчётность
Поскольку это оптимизация с потерями в том смысле, что объединяемые изображения не были идентичными, разумный рабочий процесс — сначала посмотреть, потом прыгать. Опция пробного прогона сообщает, что было бы объединено и сколько полезной нагрузки было бы возвращено, не изменяя граф объектов, поэтому пакетное задание может залогировать эффект, а человек может утвердить пороги один раз, а не для каждого файла
Стоит упомянуть два честных момента в отчётности. Цифра возвращаемого объёма оценивает только закодированную полезную нагрузку дублирующихся потоков; она не учитывает накладные расходы словаря, косвенного объекта и таблицы перекрёстных ссылок, поэтому фактическое сокращение размера файла немного больше сообщённого, а не меньше. А отчёт раскрывает максимальную принятую ошибку и объём работы по сравнению, поэтому вы можете увидеть, насколько близко слияния подошли к вашим порогам
Фиксированная сетка выборки 64 на 64 — намеренное приближение, и у него есть следствие, которое стоит прямо озвучить: различие меньше одной ячейки выборки может остаться незамеченным даже при нулевом пороге. Одно изменённое слово на отсканированной странице может не пережить такую выборку. Когда требуется побайтовое доказательство, используйте вместо этого путь точной дедупликации — он объединяет только по-настоящему идентичные ресурсы и вообще не выносит визуальных суждений
Где это место в конвейере уменьшения размера
Упорядочивайте проходы по риску. Сначала запускайте точную дедупликацию ресурсов, поскольку она без потерь и бесплатна. Затем создание подмножеств шрифтов, которое также без потерь и обычно даёт наибольший единичный выигрыш на документах, насыщенных текстом, как описано в статье оптимизация размера файла PDF и создание подмножеств шрифтов. Затем перекодирование или понижение разрешения изображений, если это позволяет целевой носитель. Перцептивная дедупликация идёт после них, потому что это единственный шаг, чей результат зависит от оценочного суждения
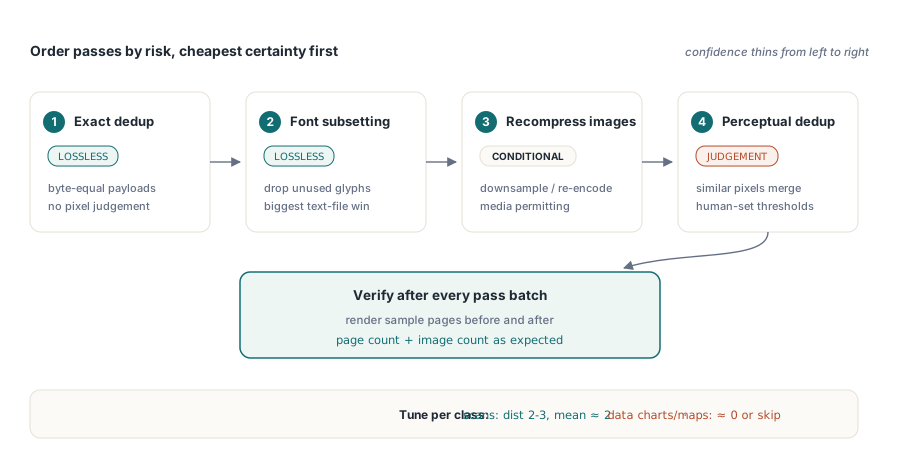
Выбирайте пороги по классу документа, а не глобально. Для пакетов сканов, где каждая страница несёт один и тот же фирменный бланк, расстояние хеша от 2 до 3 со средней ошибкой около 2 надёжно объединяет бланк. Для документов, где изображения несут данные — диаграммы, карты, медицинские снимки, — используйте нулевые или близкие к нулю пороги либо полностью пропустите этот проход, потому что два графика, различающиеся одной нанесённой точкой, — это два разных графика, как бы похоже они ни выглядели при выборке 64 на 64
После оптимизации проверяйте. Отрисуйте выборку страниц до и после и сравните их, а также проверьте, что число страниц и число изображений изменились так, как вы ожидали. Путь проверки того, что документ на самом деле содержит, описан в статье аудит размера файла PDF по категориям, что также является самым быстрым способом узнать, действительно ли изображения — ваша проблема
Перцептивная дедупликация, точная дедупликация ресурсов и аудит размера работают с одним и тем же графом объектов для Delphi, C++Builder и Free Pascal; полный список возможностей — на странице PDF Library for Delphi