Словарь LZW-кодировщика всегда опережает на одну запись декодер, который будет читать его вывод, поэтому двум сторонам нельзя делить один порог ширины кода. PDFlibPas даёт TPLLZWEncoder и TPDFLZWDecompressor отдельные пороги, выведенные из одного флага EarlyChange, и это опережение на одну запись — вся причина, по которой флаг вообще существует
Почти каждая самописная реализация LZW ошибается в одном и том же месте. Сначала вы пишете декодер, потому что он нужен, чтобы открывать файлы. Он работает. Потом пишете кодировщик, зеркалите логику декодера строка в строку, потому что LZW симметричен, гоняете round-trip тест — и он проходит. Вы релизите. Через полгода клиент открывает ваш вывод во вьюере, который не ваш, и с середины потока дальше — мусор. Зеркало и было багом: две половины LZW не симметричны, и притворство, что они симметричны, даёт потоки, которые умеет читать только ваш собственный код
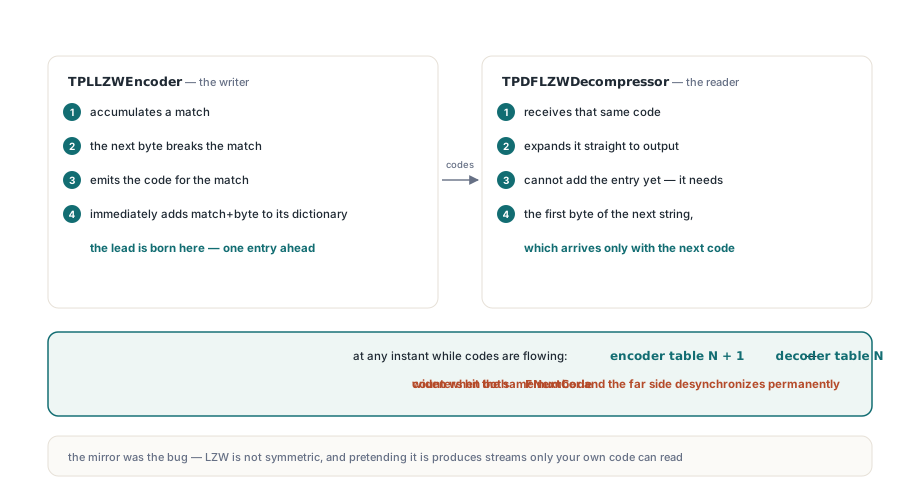
Почему кодировщику нужен другой порог, чем декодеру?
Потому что кодировщик узнаёт каждую запись словаря на один шаг раньше, чем может декодер. Это не дизайн-решение PDFlibPas; это присуще тому, как работает LZW, и каждая корректная реализация обязана где-то это компенсировать. Пройдитесь по циклу — и увидите, откуда берётся опережение. Кодировщик накапливает совпадение, обнаруживает, что следующий байт его разрывает, испускает код совпадения и сразу добавляет совпадение-плюс-байт в свой словарь. Декодер получает тот же код и разворачивает его, но соответствующую запись добавить пока не может: новой записи нужен первый байт следующей строки, который приходит только со следующим кодом. Поэтому в любой момент, пока текут коды, таблица кодировщика держит на одну запись больше, чем таблица декодера. Если обе стороны расширяют код с 9 до 10 бит, когда их собственный FNextCode достигает одного и того же числа, они расширяются с разницей в один код, и читатель битов на другом конце рассинхронизируется навсегда. В TPDFLZWDecompressor.ResetDictionary порог декодера вычисляется один раз и хранится в FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: сторона декодера в пороге
FCodeSize := FInitialCodeSize;                 // 9 для PDF LZWDecode
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // расширять, когда FNextCode достигает 511
else
  FChangeCode := FBitMask + 1;                 // расширять, когда FNextCode достигает 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Цикл декодирования расширяет ширину сразу после добавления записи, проверяя (FNextCode = FChangeCode) and (FCodeSize < 12) и пересчитывая и FBitMask, и FChangeCode для новой ширины. Девять бит срабатывают на 511 или 512, десять — на 1023 или 1024, одиннадцать — на 2047 или 2048, а двенадцать бит — это потолок, где словарь приходится сбрасывать ClearCode, а не доращивать. Кодировщик не может переиспользовать ни одно из этих чисел. Его GrowCodeSize добавляет единицу, чтобы компенсировать опережение, так что при установленном EarlyChange он расширяется на 512, тогда как декодер — на 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 на 9 битах
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 на 9 битах
  // Декодер добавляет свою последнюю ожидающую запись до чтения EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;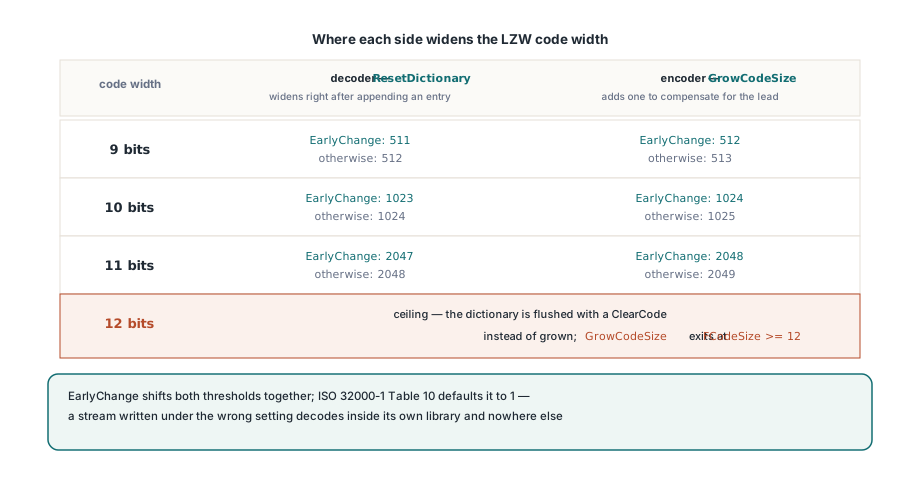
Последний код данных — точка, где стороны наконец встречаются
Конец потока — единственное место, где кодировщик должен перестать опережать и думать как декодер, и именно для этого существует параметр FinalDataCode у GrowCodeSize. Испустите код EOI не той шириной — и всё, что до него, останется совершенно валидным, так что дефект прячется за тысячами корректных байт. Последовательность такая. Кодировщик испускает свой последний код данных и, в отличие от всех предыдущих итераций, ничего после этого в свой словарь не добавляет, потому что не осталось следующего байта, которым можно продлить совпадение. Декодер делает наоборот: получает этот последний код, и только теперь может завершить запись, которую держал с предыдущего. На последнем шаге декодер догоняет, опережение схлопывается в ноль, и ширина, которой он прочитает EOI, решается записью, которую кодировщик так и не создал. Dec(ChangeCode) — это кодировщик, притворяющийся ровно на один вызов, что он декодер:
// TPLLZWEncoder.Compress, хвост потока
EmitCode(CurCode);      // последний код данных, текущей шириной
GrowCodeSize(True);     // может расширить, используя уменьшенный порог
EmitCode(FEOICode);     // EOI той шириной, которой его реально прочитает декодер
FlushBits;
FlushOutput;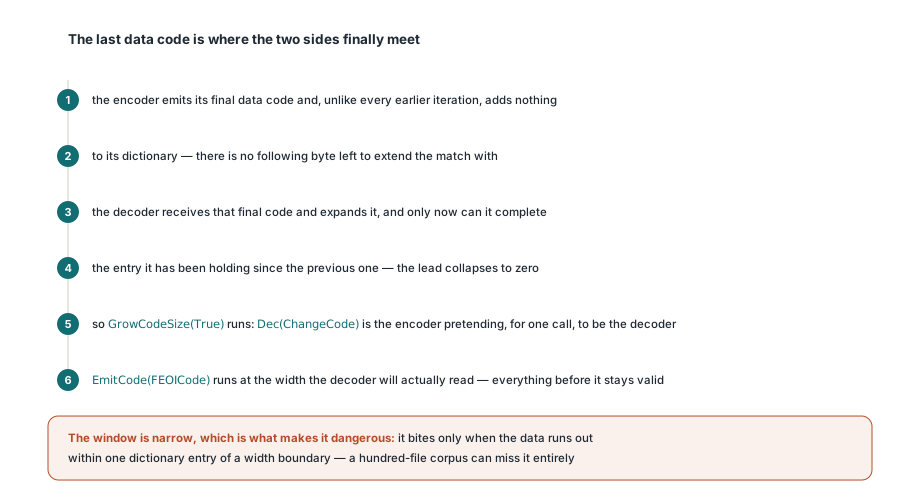
Окно, в котором это важно, узкое, и именно поэтому оно опасно. Оно кусается только когда данные умудряются закончиться в пределах одной записи словаря от границы ширины, так что корпус из сотни тестовых файлов может не поймать дефект вовсе, а один файл клиента попадает в него каждый раз. Граничные случаи в Compress приходится гонять намеренно: готовьте входы, чей словарь останавливается на 510, 511 и 512 записях, и затем читайте испущенную битовую ширину EOI из потока руками, а не выводите её из успешного декодирования
Почему проходящий round-trip тест всё равно может прятать битый поток?
Потому что две реализации, делающие одну и ту же ошибку, соглашаются друг с другом. Если ваш кодировщик и ваш декодер оба расширяются на один код раньше или оба на один код позже, они остаются синхронными, round trip воспроизводит вход байт в байт, и набор тестов зелёный, тогда как произведённый вами поток не читается больше ничем. Это самое ценное, что можно вынести из всей этой возни: для LZW самосогласованность как свидетельство не стоит ничего. Поэтому само-раунд-трип не может быть основным тестом, и PDFlibPas валидирует путь LZW ещё тремя способами. Ручные кодовые потоки с ожидаемым битовым паттерном, выписанным от руки, — тогда утверждение про байты, а не про результат их декодирования. Двунаправленная интероперабельность против независимых реализаций, когда потоки, произведённые этим кодировщиком, декодируются где-то ещё, а потоки из других мест декодирует TPDFLZWDecompressor. И дифференциальное декодирование: читать одни и те же байты дважды, с EarlyChange в обе стороны, чтобы поток, который чисто декодируется при неверной настройке, сказал вам, что границы ширины вообще не упражнялись:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // намеренно неверное правило для PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A обязано совпасть с исходником; B совпадать НЕ должно. Если B тоже
// совпадает, вход был слишком коротким, чтобы пересечь границу ширины кода.
Внешние входы — вот что реально даёт это покрытие. Текущий тестовый материал пересекает ширины 9, 10, 11 и 12 бит и заставляет 34 сброса словаря в одном потоке — это единственный реалистичный способ доказать, что путь ClearCode на потолке 4095 вообще работает. Если ваши фикстуры никогда не превышают пары килобайт, этот код ни разу не выполнялся. А когда фикс меняет то, что производит ваш кодировщик, относитесь к старому выводу как к битому, а не как к совместимому бейзлайну, который стоит сохранять; поток, неправильно смешивающий ширины кодов, — это не легаси-формат, а баг, которому случилось попасть на диск
PDF говорит 1, TIFF — смотря по обстоятельствам
PDFlibPas по умолчанию ставит EarlyChange в True на обоих классах — TPLLZWEncoder и TPDFLZWDecompressor — потому что ISO 32000-1 Table 10 определяет EarlyChange как параметр декодирования LZWDecode со значением по умолчанию 1, то есть длина кода увеличивается на один код раньше. Это задано в ISO 32000-1, раздел 7.4.4.2, рядом с параметрами предиктора, и PDF, который хочет другого поведения, обязан явно указать /EarlyChange 0 в своём словаре /DecodeParms. TIFF — причина, по которой флаг является свойством, а не константой: TIFF 6.0, раздел 13, описывает LZW-сжатие без того же однозначного заявления, и кодировщики в дикой природе исторически расходились по этому вопросу — что, скорее всего, и заставило спецификацию PDF вообще дать параметру имя. На пайплайне TIFF-в-PDF настройку поэтому нельзя хардкодить ни на одном из концов. Что бы ни оказалось нужно стороне TIFF, это надо явно протащить в /DecodeParms PDF, иначе вы конвертируете файл, который открывался нормально, в файл, который не открывается. Та же осторожность применима к FillOrder, где foTop и foBottom выбирают, с какого конца байта читатель битов заполняет, и к горизонтальному дифференцированию TIFF Predictor 2, которое TPDFLZWParms проносит через Predictor, Colors, BitsPerComponent и Columns. Наши заметки про харденинг встроенного TIFF-декодера для BigTIFF и тайловых раскладок покрывают остаток этого пути
Ещё две мелкие ловушки, которые стоит назвать
Обе легко подключить неправильно, когда держишь объекты кодировщика и декодера рядом и предполагаешь, что симметрия держится и здесь:
InitialCodeSizeозначает на двух классах не одно и то же.TPLLZWEncoder.InitialCodeSize— это ширина корневого символа, валидируемая от 2 до 8, гдеInitDictionaryвыводитFClearCodeкак1 shl FInitialCodeSizeи ставитFCodeSizeвFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSize— первая ширина кода, валидируемая от 2 до 9, гдеResetDictionaryвыводитFClearCodeкак1 shl (FCodeSize - 1). Для обычных 8-битных данных PDF значения по умолчанию — 8 и 9 соответственно, и вы этого не замечаете; поставьте руками оба одинаковыми — и соберёте несовместимую пару- Декодирование недоверенного LZW — это проблема безопасности памяти раньше, чем проблема корректности, потому что индексы словаря приходят прямо из файла.
TPDFLZWDecompressorотклоняет любой код выше 4095 или на уровнеFNextCodeи выше, отказывается добавлять записи после 4095, проверяет остаток входа в битах перед каждымGetNextCodeи выставляетSawExplicitEOI, чтобы вызывающий мог отличить корректно завершённый поток от того, у которого просто кончились байты. Усечённый поток — это не частичный успех. Более широкий обзор в статье про харденинг Pascal-парсера PDF против вредоносных файлов покрывает класс дефектов, которые закрывают эти гарды
Что это вам оставляет
LZW выглядит симметричным, но не является им. Словарь кодировщика опережает на одну запись через всё тело потока, и на последнем коде опережение исчезает, так что корректная реализация несёт два порога плюс один особый случай, а флаг EarlyChange сдвигает оба порога вместе. Ошибка в любом из них на один код — и вы производите вывод, который валиден ровно до тех пор, пока не перестаёт им быть, без ошибки и исключения где-либо, просто какой-то вьюер показывает шум. Честная граница в том, что всё это не тестируется изнутри: ничто в вашем собственном наборе не отличит корректный поток от стабильно неверного, так что проверка интероперабельности — не необязательный дополнительный проход, а единственное настоящее свидетельство, которое у вас вообще будет. Оба класса поставляются в PDF Library for Delphi, которая также делает окружающую структурную работу, описанную в наших заметках про объектные потоки и cross-reference потоки, для Delphi и C++Builder на всех поддерживаемых библиотекой версиях компиляторов