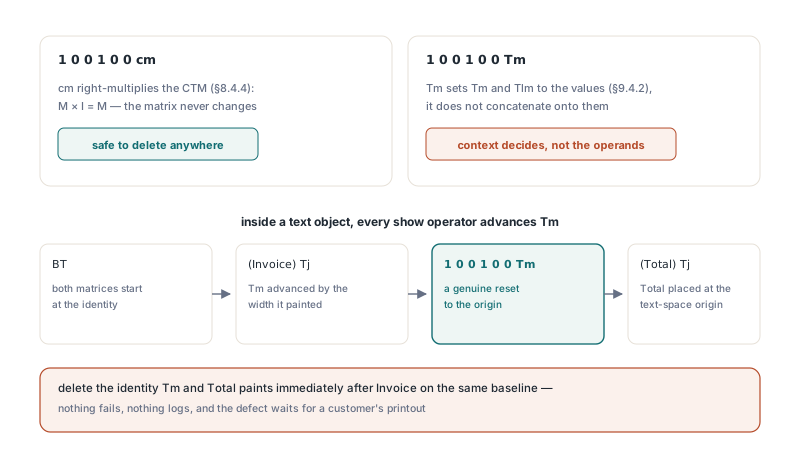
Возьмите поток содержимого, который мог бы написать генератор отчётов, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, и вырежьте 1 0 0 1 0 0 Tm, потому что его шесть чисел складываются в единичную матрицу. Отрисуйте результат — и "Total" больше не начинается в начале текстового пространства. Он начинается там, где кончился "Invoice", на той же базовой линии. Identity-Tm избыточен, только пока text matrix и text line matrix уже держат identity: сразу после BT или сразу после другого identity-Tm
Удаление соблазнительно, потому что те же шесть чисел перед cm и правда мёртвый груз. Оптимизатор потока содержимого, обходящийся с обоими операторами одинаково, сожмёт множество потоков правильно. А потом встретит генератор, использующий identity-Tm как возврат каретки, — и текст сдвинется
Почему 1 0 0 1 0 0 Tm — не всегда no-op?
Два оператора делают разную арифметику. ISO 32000-1 §8.4.4 определяет cm как конкатенацию его операнда с текущей матрицей трансформации; умножьте любую матрицу на единичную — получите ту же матрицу обратно, поэтому 1 0 0 1 0 0 cm можно удалять где угодно. Tm — присваивание. По §9.4.2 он ставит обе матрицы, text matrix и text line matrix, в свои операнды и выбрасывает то, что они держали, так что меняет ли он хоть что-нибудь — зависит целиком от операторов перед ним
§9.4.1 говорит, что BT стартует обе матрицы с identity. Оттуда почти всё внутри текстового объекта двигает хотя бы одну из них. Td, TD, T* и не-identity Tm переставляют text line matrix. Каждый текстопоказывающий оператор (Tj, TJ, ' и ") продвигает text matrix на ширину только что нарисованных глифов, причём последние два сперва начинают новую строку. Стоит любому из них сработать — и identity-Tm становится настоящим прыжком в начало. Инвойсный поток выше на том прыжке и держится
Ручная трассировка потока решает вопрос быстро. Прогоните инвойсный пример через трекер состояния CTM и текстовой матрицы потока содержимого — и запись покажет cm, конкатенирующийся с CTM, тогда как Tm перезаписывает обе текстовые матрицы: два разных правила обновления за одинаковыми операндами
Как PDF Library for Delphi решает, какой identity Tm выбросить
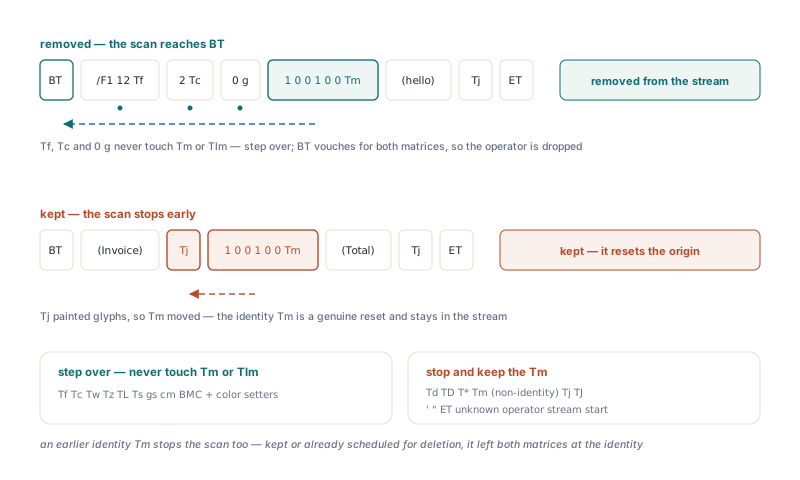
PDF Library for Delphi выбрасывает каждый identity-cm в своём peephole-проходе, а identity-Tm — только когда обратный скан от того оператора добирается до BT или другого identity-Tm раньше, чем встретит хоть что-нибудь, что могло сдвинуть текстовые матрицы. Проверка на "identity" числовая: оператору нужны ровно шесть числовых операндов, равных 1, 0, 0, 1, 0, 0, так что 1.0 0 0 1.0 0 0 Tm тоже подходит. Идя назад, скан кладёт каждый встречный оператор в одну из двух групп:
- Стоп и оставить Tm:
Td,TD,T*, не-identityTm,Tj,TJ,',",ET, любой оператор, которого парсер не знает, или начало потока - Шагнуть и сканировать дальше: операторы, никогда не трогающие Tm и Tlm, — например
Tf,Tc, сеттеры цвета,gs, операторы marked-content,Doиcm
Более ранний identity-Tm останавливает скан в пользу удаления — оставлен ли он оптимизатором или уже назначен на выброс. Так или иначе он оставил обе матрицы в identity, а это то же состояние, какое оставляет BT. Поэтому прогон из трёх identity-Tm подряд сразу после BT схлопывается в ничто
Консервативные остановки намеренные. Неизвестный оператор может оказаться вендорским расширением, способным на что угодно, поэтому скан отказывается рассуждать за его спиной. После ET открытого текстового объекта нет, и у сидящего там identity-Tm нет BT, который ручался бы за значения матриц. Скан к тому же смотрит на один поток содержимого за раз. Это важно для страниц, чей /Contents — массив: PDF позволяет текстовому объекту начаться в одном потоке и продолжиться в следующем, поэтому слой, открывающийся посреди текстового объекта без собственного BT, сохраняет свой identity-Tm, даже если предыдущий слой сделал бы его избыточным
Мы считаем это правильной стороной для перестраховки. Отслеживание матриц через границы потоков или симуляция неизвестных операторов вернули бы может быть четырнадцать байтов несжатого текста на диковинный файл. Ошибка сдвинет глиф на печатаемом счёте. Цена и риск — из разных лиг
Одно побочное следствие стоит знать, потому что оно меняет то, что вы видите в выводе. Тот же проход убирает и текстовые объекты, в которых ничего нет, поэтому BT 1 0 0 1 0 0 Tm ET исчезает целиком: identity-Tm уходит первым, а оставшаяся после него пара BT/ET пуста
Запуск оптимизатора на фрагменте потока содержимого
Оптимизатор работает на той же разобранной модели TPDFContentProgram, которой вы правили бы текст страницы на уровне инструкций, как в статье разбор отображения символ-байт потока содержимого. Это делает лёгким испытание правила на строке, прежде чем доверять ему целый документ. Хелпер ниже разбирает декодированный поток, гоняет TPDFContentPeepholeOptimizer и выдаёт результат по одной инструкции на строку. Установка CanonicalNumbers перед Parse повторяет проход при сохранении, который переписывает каждое число на фиксированной точности
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // та же обработка чисел, что в проходе сохранения
    if not Prog.Parse(Source) then
      Exit; // грубые структурные повреждения: байты не трогаем
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // возвращает число удалённых инструкций
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // одна инструкция на строку, разделитель #10
  finally
    Prog.Free;
  end;
end;

// Удалено: Tm сразу после BT, второй из двух identity Tm подряд
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Оставлено: Tm после Td, после Tj, после не-identity Tm или вне BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Прогоните инвойсный поток через него — и identity-Tm выживет, потому что обратный скан встречает Tj задолго до BT. Поставьте /F1 12 Tf, 2 Tc и 0 g между BT и identity-Tm — он всё равно уйдёт: ни один из них текстовых матриц не касается. Интересный случай — BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Он теряет ровно один оператор. Первый identity-Tm отменяет сдвиг, который сделал Td, и только второй избыточен
Parse возвращает False только на грубых повреждениях вроде незакрытой строки или словаря. Неизвестные операторы разбираются нормально и остаются в программе, где служат жёсткими стопами для скана
Когда peephole-оптимизатор на самом деле запускается?
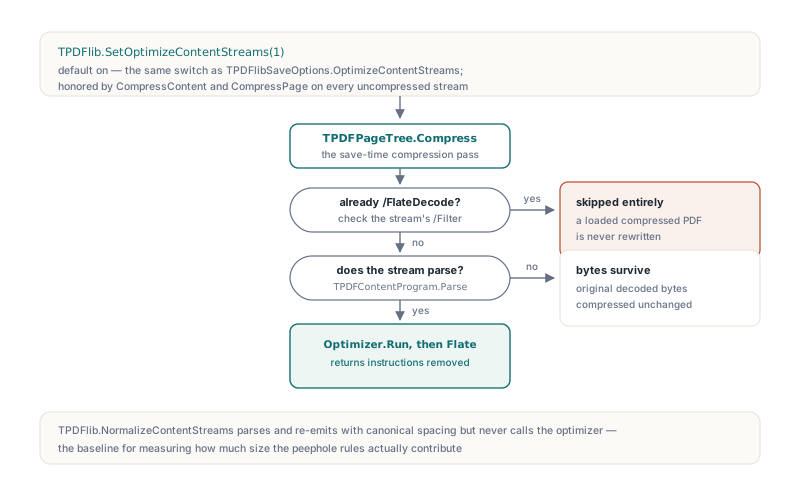
Оптимизатор запускается только внутри прохода сжатия и только на потоках содержимого страниц, ещё не сжатых Flate. TPDFlib.SetOptimizeContentStreams(1) — умолчание, и тот же переключатель фигурирует как поле OptimizeContentStreams в TPDFlibSaveOptions; его учитывают и CompressContent, и CompressPage. Поток, чей /Filter уже /FlateDecode, пропускается целиком, поэтому загрузка типичного сжатого PDF и повторное сохранение оставляют его операторы ровно как были. Несжатые потоки декодируются, оптимизируются и затем сжимаются Flate. Если поток не разобрался, его исходные декодированные байты сжимаются без изменений
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Несжатые потоки страниц идут через peephole-правила, затем Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // Тот же выбор через пакетные опции сохранения; False отключает
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Оставляйте умолчание включённым. Каждая трансформация в проходе эквивалентна по выводу, и правило единичных матриц охотится за шаблоном, который издаёт множество генераторов, открывая каждый текстовый объект с BT 1 0 0 1 0 0 Tm. Выключать его имеет смысл в основном когда хочется сравнить собственный несжатый вывод с тем, что вы написали, или когда нужна базовая линия. Для той базовой линии TPDFlib.NormalizeContentStreams разбирает и переиздаёт содержимое с каноничными пробелами и числами, но оптимизатор не зовёт никогда, так что зазор размера между нормализованным сохранением и оптимизированным — это вклад peephole-правил. Ожидайте его скромным на фоне больших выигрышей из статьи оптимизация размера PDF с субсеттингом шрифтов
Тест, покрывающий одну форму, не определяет правило
Тест, скармливающий оптимизатору BT 1 0 0 1 0 0 Tm (hello) Tj ET и утверждающий, что никакого Tm не осталось, прибивает одну форму: identity-Tm сразу после BT удаляется. Он не говорит ничего об identity-Tm после Td или после показанного текста. Прочесть то единственное утверждение как "identity-Tm всегда можно удалить" — ошибка лёгкая и дорогая, ведь образец проходит в обе стороны. Тестам для любого правила вроде этого нужны сохраняемые формы, выписанные рядом с удаляемыми
Хелпер ниже считает пережившие Tm операторы, затем прогоняет таблицу входов. Подставьте вместо ExpectTm утверждение своего тестового фреймворка; он не часть библиотеки
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 сигнализирует неудачу разбора
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Ваш собственный хелпер проверки, предложен здесь; замените настоящим утверждением
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Удаляемые формы
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Формы, обязанные сохранить identity Tm
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // нет объемлющего BT
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // после ET
end;
Последние две строки выглядят глупо, пока не вспомнишь, что слоистые массивы /Contents производят ровно такие фрагменты. Поток, начинающийся посреди текстового объекта, не имеет BT, а identity-Tm после ET не принадлежит никакому текстовому объекту вовсе. Оба остаются. Пустая пара BT ET в последней строке убрана правилом пустых текстовых объектов — вот почему счёт проверяет операторы Tm, а не сравнивает строки целиком
Чем правило жертвует, так это случайным identity-Tm посреди текстового объекта — несколько байтов на страницу ещё до того, как их увидит Flate. Что покупает — гарантию, на которой стоит дизайн оптимизатора: ни одна трансформация в проходе не меняет видимую страницу. Оптимизатор размера, двигающий текст, — это баг рендеринга с хорошим коэффициентом сжатия
Если вы генерируете или пост-обрабатываете содержимое PDF в Delphi или C++Builder, PDF Library for Delphi and C++Builder везёт парсер потока содержимого, этот peephole-проход и показанные выше опции сохранения, вместе с NormalizeContentStreams для производства чистой неоптимизированной базовой линии для сравнения