Импортёр FDF-аннотаций может вернуть число разобранных записей, не добавив в документ ни одной: каждая запись посчитана, каждая запись выброшена. TPDFlib.ImportAnnotationsFromFDFString в losLab PDF Library читает ключи в любом порядке, разбирает /Rect правильно и независимо от локали и возвращает число реально добавленных аннотаций, а парный экспортёр пишет настоящий /Rect аннотации, так что экспорт, импорт и второй экспорт дают побайтово идентичный FDF. Дальше в заметке — как один неверный стартовый офсет порождает образцово тихий отказ, какие ещё три ловушки прячутся за ним и как проверить импорт самостоятельно, не доверяя возвращаемому значению
Сценарий обыкновенный. Рецензент размечает договор, комментарии едут файлом FDF (Acrobat зовёт это Export Comments), а ваш сервис на Delphi вливает их в чистую копию вызовом FDF-импорта. Вызов возвращает 7, в логе «7 comments imported», задание зелёное, а в выходном PDF нет ни одного комментария. Ничего не поднято, ничего не предупреждено, и число выглядело правдоподобно, потому что это была настоящая численность записей в файле. Худшей формы баг и не бывает: функция, чей единственный сигнал успеха — счётчик, вычисляемый независимо от работы, о которой он отчитывается
Почему ImportAnnotationsFromFDFString отчитывалась об успехе, не добавив ничего?
Потому что искатель имён может стартовать не в том месте, а счётчик — жить вне кода, который делает работу. Искатель ключа, возвращающий позицию сразу после /Subtype, приземляется на пробеле перед значением. ReadName, стартующий с этого пробела и останавливающийся на первом же whitespace-символе, заканчивает, не прочитав ничего, так что всякий subtype возвращается пустым. Хелпер вроде AddAnnotationToPage, отказывающийся строить аннотацию без subtype, в отдельности делает верный защитный ход, но если это процедура без возвращаемого значения, а Inc(Result) звонящего сидит снаружи, два предохранителя вместе превращают «не работает ничего» в «работает всё». Правильный читатель имён пропускает пробелы, требует начальный / PDF-name-объекта и останавливается на любом разделителе, включая [, ( и ), так что и /Subtype/Text, и /Subtype /Text дают Text; именно так читает имена losLab PDF Library
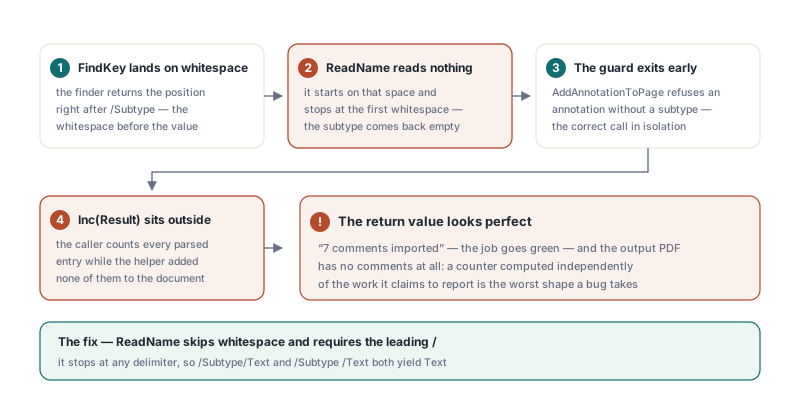
Возвращаемое значение заслуживает заботы и сверх того. Импортёр, наращивающий счётчик за каждый корректный словарь в массиве /Annots, всё ещё перегибает, когда у записи вышедший за диапазон 0-базный /Page или отсутствующий /Subtype — а оба такие пропускаются. В losLab PDF Library ImportAnnotationsFromFDFString и ImportAnnotationsFromFDF возвращают число реально добавленных аннотаций, как импорт XFDF: хелпер FDF AddAnnotationToPage возвращает Boolean, и счётчик двигается только при успехе. Замер документа всё равно более сильная проверка, потому что работает при любом коде, породившем число, поэтому скетч ниже сравнивает AnnotationCount на каждой странице до и после импорта
function TotalAnnotations(Lib: TPDFlib): Integer;
var
  Page, Saved: Integer;
begin
  Result := 0;
  Saved := Lib.SelectedPage;
  for Page := 1 to Lib.PageCount do
    if Lib.SelectPage(Page) = 1 then
      Inc(Result, Lib.AnnotationCount);   // на выбранной странице, виджеты включительно
  Lib.SelectPage(Saved);
end;

var
  Lib: TPDFlib;
  Before, Reported, Added: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contract.pdf', '');
    Before := TotalAnnotations(Lib);
    Reported := Lib.ImportAnnotationsFromFDF('review-comments.fdf');
    Added := TotalAnnotations(Lib) - Before;
    if Added <> Reported then   // равно, когда каждая запись приземлилась на страницу
      Writeln(Format('Importer reported %d, %d landed on a page', [Reported, Added]));
    Lib.SaveToFile('contract-reviewed.pdf');
  finally
    Lib.Free;
  end;
end;
Ещё три ловушки за первой
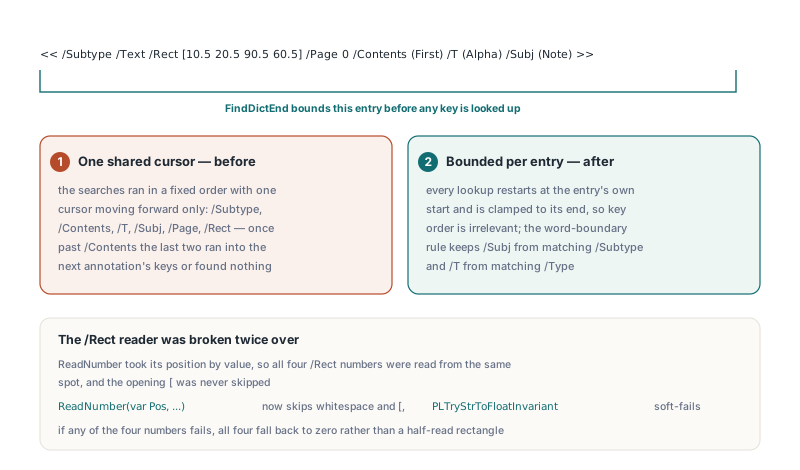
Починить один subtype — значит выставить на свет ещё три ловушки в том же парсере, каждая из которых невидима, пока ни одна аннотация не добирается до страницы. Во-первых, ReadNumber, принимающий позицию как value-параметр, при вызове для четырёх чисел /Rect подряд читает одно и то же место четыре раза, а открывающую [ он не пропускает, то есть на практике не читает ничего. Во-вторых, FindKey, делящий один ползущий вперёд курсор между всеми поисками, зависит от порядка ключей. Экспортёр может писать /Subtype, /Rect, /Page, /Contents, /T, /Subj, тогда как импортёр ищет в порядке /Subtype, /Contents, /T, /Subj, /Page, /Rect; стоит курсору пройти /Contents, как поиск /Page и /Rect убегает за пределы текущей записи и либо не находит ничего, либо цепляет ключи следующей аннотации, так что импортёр не может прочитать даже собственный вывод экспортёра. В-третьих, числа, идущие через рутину, следующую системному десятичному разделителю, вроде PLStrToFloat, ломаются на машинах с comma-локалью. ISO 32000-1 §12.7.7 определяет FDF как синтаксис PDF-объектов, а ключи словарей в PDF неупорядочены (§7.3.7), так что любой парсер FDF, предполагающий порядок ключей, ошибочен по построению — что бы ни породило файл
losLab PDF Library сперва ограничивает каждую запись. FindDictEnd идёт от открывающей << до парной >>, отслеживая вложенные словари и пропуская тела literal-строк с их backslash-эскейпами, так что >> внутри комментария вроде (see section >> 4) не может закончить запись раньше времени. Каждый поиск ключа стартует с начала самой записи и ограничен её концом, что делает порядок ключей безразличным и не даёт одной аннотации занимать чужой /Page. Совпадение ключа принимает разделитель прямо после имени, потому что /Contents(Hi) так же валиден, как /Contents (Hi), а правило границы слова не даёт /Subj сцепиться с началом /Subtype и /T — с /Type. ReadNumber берёт позицию как var-параметр, пропускает пробелы и [ и парсит через PLTryStrToFloatInvariant, мягко отказывая на кривом токене вместо исключения. Если любое из четырёх чисел прямоугольника не разобралось, все четыре откатываются в нули, а не выдают наполовину прочитанный прямоугольник
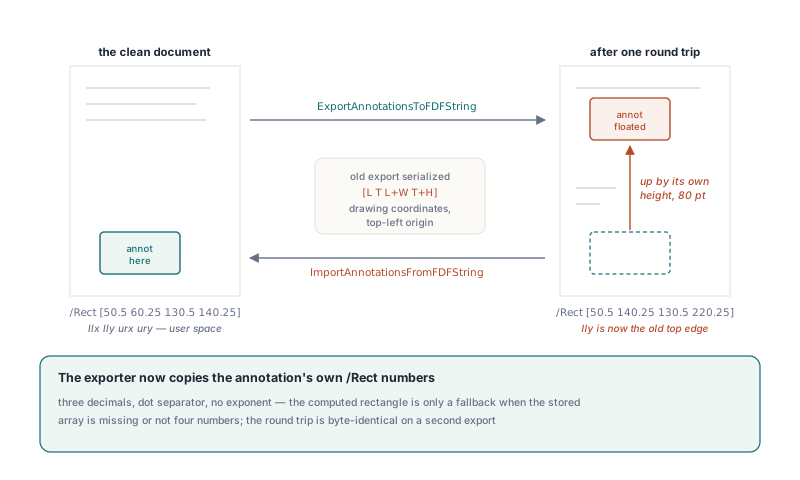
Почему FDF round-trip сдвигал каждую аннотацию на её собственную высоту?
Потому что прямоугольник легко записать в неверной системе координат. /Rect аннотации — это [llx lly urx ury] в default user space (ISO 32000-1 §12.5.2, прямоугольники определены в §7.9.5), и FDF несёт тот же массив. GetAnnotRectEx, однако, отчитывает Left, Top, Width и Height в рисовальных координатах библиотеки — том самом space, которым управляет SetOrigin. Экспортёр, сериализующий их как [L T L+W T+H], вручаёт импортёру четыре значения, которые, записанные назад дословно как PDF-прямоугольник, кладут верхнюю грань туда, где полагалось быть нижнему левому углу, и каждый round trip поднимает аннотацию на её собственную высоту. Экспортёр losLab PDF Library копирует собственные числа /Rect аннотации — три десятичных знака, разделитель-точка, без экспоненты — и откатывается к вычисленному прямоугольнику, только если сохранённый массив отсутствует или не содержит четырёх чисел
Round-trip тест, который стоит скопировать, утверждает состояние документа и второй экспорт, а не возвращаемое значение импортёра. Заметьте ожидаемое число 2: AddNoteAnnotation создаёт Text-аннотацию плюс её Popup, и едут обе. Тест также гоняет экспорт и импорт при запятой в качестве десятичного разделителя — а это как раз та половина истории, которая живёт дальше
var
  Source, Target: TPDFlib;
  FDF: AnsiString;
  OldSep: Char;
begin
  Source := TPDFlib.Create;
  Target := TPDFlib.Create;
  try
    Source.NewPages(1);                     // теперь две страницы
    Source.SelectPage(2);
    Source.AddNoteAnnotation(50.5, 60.25, 0, 80, 80, 120, 60,
      'Reviewer', 'Check this', 0.25, 0.5, 0.75, 0);
    Target.NewPages(1);

    OldSep := FormatSettings.DecimalSeparator;
    FormatSettings.DecimalSeparator := ',';   // имитируем немецкий или французский десктоп
    try
      FDF := Source.ExportAnnotationsToFDFString;   // по-прежнему пишет /Rect [50.5 ...
      Target.ImportAnnotationsFromFDFString(FDF);
    finally
      FormatSettings.DecimalSeparator := OldSep;
    end;

    Target.SelectPage(2);
    Assert(Target.AnnotationCount = 2);           // заметка и её popup
    Assert(Target.GetAnnotType(1) = 'Text');
    Assert(Target.ExportAnnotationsToFDFString = Source.ExportAnnotationsToFDFString);
  finally
    Target.Free;
    Source.Free;
  end;
end;
FDF-путь построен вокруг основного словаря аннотации. Импортёр пересобирает каждую запись с /Type, /Subtype, /Rect, /Contents, /T и /Subj, а экспортёр оставляет аннотации Widget form-data методам, потому что поля формы — их вотчина. Прежде чем полагаться на FDF ради цвета, флагов, стиля рамки, ссылок на popup или appearance-потоков, сверьтесь с общей картой того, какие данные едут каким методом, в обзоре обмена формами FDF, XFDF и XFA; если нужно осмотреть, что реально приехало, поиндексные читатели вроде GetAnnotType, GetAnnotTitle и GetAnnotContentsEx разобраны в статье об интроспекции outline, аннотаций и action
Как читать FDF и XFDF с запятыми в десятичных из старых экспортов?
Для FDF ответ однозначен: запятая — не разделитель в синтаксисе PDF, значит числовой токен ровно с одной запятой и без точки может быть только десятичной дробью с машины с comma-локалью. Такие файлы существуют, например /Rect [10,500 20,250 40,750 60,125] от экспортёра, форматировавшего числа системной локалью, и ReadNumber превращает эту одиночную запятую в точку перед разбором. Токен с двумя запятыми или с запятой и точкой отвергается, а не угадывается. Экспоненциальную запись читатель тоже не потребляет, что совпадает с ISO 32000-1 §7.3.3: PDF-числа её никогда не используют
С XFDF сложнее: в XML-атрибутах запятая — разделитель. Стандартный XFDF (ISO 19444-1) пишет rect="50.5,80.25,70.75,100.125" и dashes="4,2", тогда как писатель, зависящий от локали, на системе с comma-локалью выдаёт rect="50,500 80,250 70,750 100,125" и opacity="0,600". losLab PDF Library читает и пишет числа XFDF инвариантно в обе стороны и распознаёт легаси-форму через XFDFNormalizeLegacyDecimals только когда атрибут бьётся по whitespace ровно на ожидаемое число токенов (четыре для rect, по одному для opacity и width) и каждый токен имеет вид цифры-запятая-цифры. Стандартный rect никогда не совпадёт: это либо один токен с тремя запятыми, либо токены, кончающиеся запятой. dashes намеренно оставлен в покое: 4,2 может быть двумя длинами штриха или легаси-4.2, и ни одно правило их не различит
const
  // Ключи вне порядка экспортёра плюс запятые-десятичные из экспорта с comma-локалью
  LegacyFDF: AnsiString = '%FDF-1.2'#10'1 0 obj'#10'<< /FDF << /Annots ['#10 +
    '<< /Rect [10,500 20,250 40,750 60,125] /Page 0 /Contents (First) ' +
    '/Subtype /Text /T (Alpha) /Type /Annot >>'#10 +
    '] >> >>'#10'endobj'#10'trailer'#10'<< /Root 1 0 R >>'#10'%%EOF'#10;
var
  Lib: TPDFlib;
begin
  Lib := TPDFlib.Create;               // у свежего документа одна страница
  try
    Lib.ImportAnnotationsFromFDFString(LegacyFDF);
    Assert(Lib.AnnotationCount = 1);
    Assert(Lib.GetAnnotTitle(1) = 'Alpha');
    // Повторный экспорт в XFDF с точками: rect="10.500 20.250 40.750 60.125"
    Writeln(Lib.ExportAnnotationsToXFDFString);
  finally
    Lib.Free;
  end;
end;
Что тест импорта аннотаций должен проверять на самом деле?
Полезный тест импорта утверждает состояние целевого документа и никогда — только то, что импортёр говорит о себе; в тихом нуле возвращаемое значение — то самое число, которое остаётся целым. Три утверждения ловят каждую описанную здесь ловушку: число аннотаций на ожидаемой странице, одно поле, прочитанное обратно через GetAnnotType или GetAnnotContentsEx, и второй экспорт, сравненный побайтово с первым. Та же дисциплина приложима к любому API, переписывающему структуру документа оптом, включая консолидацию полей, описанную в статье о слиянии дублирующихся полей формы: проверяйте получившееся дерево, а не возвращённую сумму. Методы аннотаций FDF и XFDF с файловыми и строковыми вариантами едут в losLab PDF Library для Delphi и C++Builder