Конкатенация PDF звучит так, будто должна стоить дешево. Контент страниц уже разложен, шрифты уже встроены, изображения уже сжаты. В принципе merge - это просто бухгалтерия: перенумеровать объекты так, чтобы пространства нумерации двух файлов перестали сталкиваться, сшить деревья страниц, поправить cross-reference table и записать результат. На практике большинство merge-кода выбрасывает эту дешевизну в окно. Для каждого объекта каждого входного файла он делает полный parse в tokenized object tree, меняет пару косвенных ссылок, а затем сериализует дерево обратно в байты. Именно parse и reserialize являются дорогими половинами, и для подавляющего большинства объектов они производят последовательность байтов, почти идентичную входной
PDF Library for Delphi — нативный Object Pascal PDF engine для Delphi и C++Builder, и его fast merge path существует ровно для того, чтобы пропускать этот круг там, где это доказуемо безопасно. Идея узкая, но окупается на целых наборах документов: для неизмененного non-stream object берутся исходные байты как есть, и над ними выполняется один byte-level rewrite всех содержащихся в них косвенных ссылок, превращающий каждое N G R в (N+Offset) G R. Никакого tokenizer, никакого object tree, никакого serializer. Эта статья разбирает, где такой shortcut допустим, как устроен parser state machine, делающий byte rewrite, не портя ничего вокруг, почему слиянию bookmark понадобился совсем другой механизм и как обычный merge path делит тот же единственный линейный проход
Почему перенумерация объектов - это и есть реальная стоимость merge
Каждый PDF несет собственное пространство нумерации объектов. У файла A есть object 1, object 2 и так далее; у файла B есть свой object 1, object 2 и так далее. Нельзя просто вставить объекты B в файл A без изменений, потому что номера начнут конфликтовать, и каждая косвенная ссылка внутри B станет указывать не туда. Исправление - это offset: если A заканчивается на числе объектов Offset, то object N файла B становится object N+Offset в output, а каждая ссылка N G R, встречающаяся где угодно внутри объектов B, должна быть смещена в (N+Offset) G R, чтобы указывать на тот же семантический target
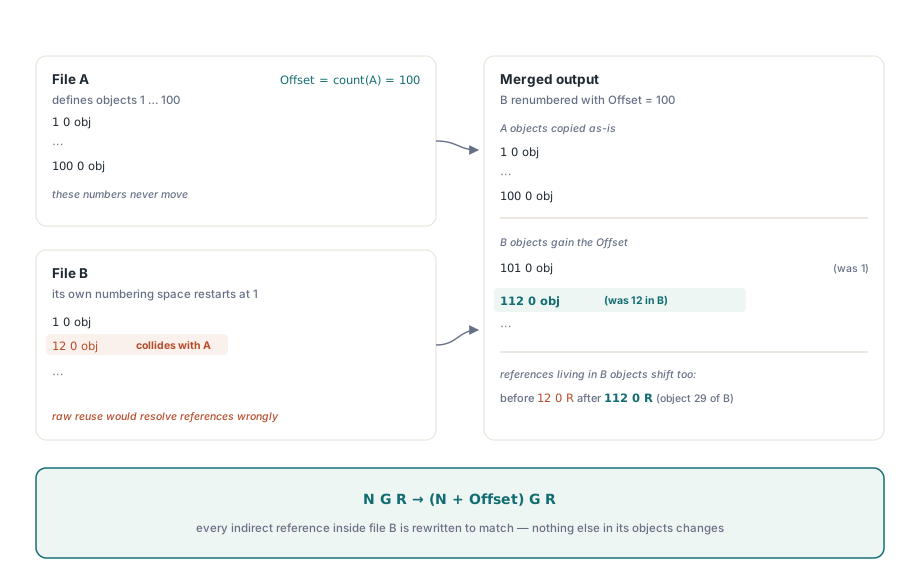
Именно этот сдвиг и есть вся семантическая работа merge для body. Поправка page tree и merge AcroForm - это маленькие, ограниченные правки на горстке объектов. Основная работа заключается в переписывании ссылок по тысячам объектов, и наивный путь делает для этого полный parse каждого объекта, чтобы находить ссылки структурно. MergeFileListFast у PDF Library for Delphi смотрит на задачу наоборот: ссылки можно находить и в сырых байтах, если аккуратно различать контексты, в которых последовательность digit-space-digit-space-R не является ссылкой. Если пропустить parse, сместить их на месте и идти дальше, стоимость на объект схлопывается до одного линейного прохода по байтам, которые вы и так собирались копировать
Когда повторное использование исходных байтов доказуемо безопасно
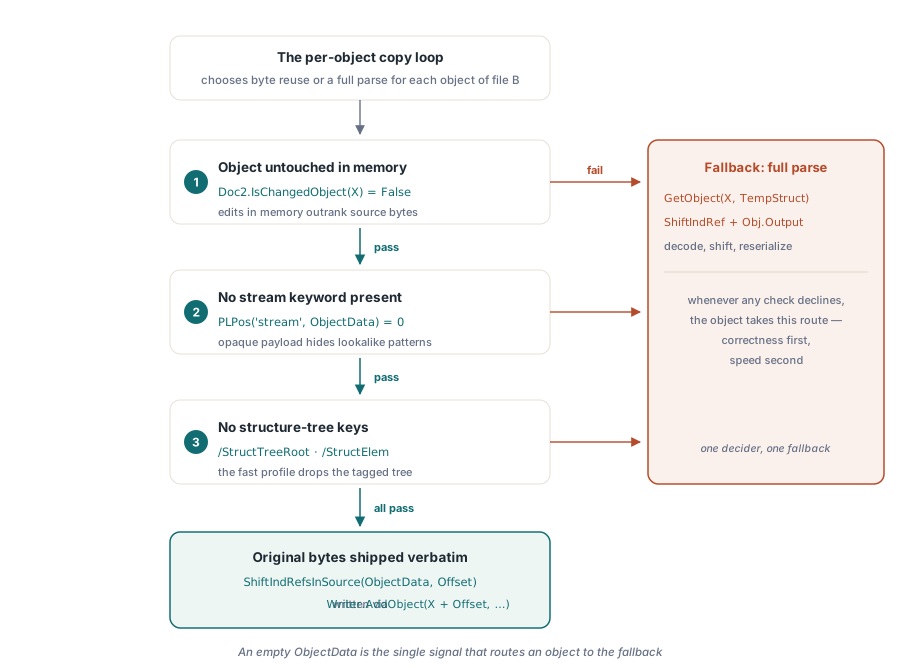
Byte path включается только тогда, когда для копируемого объекта из следующего документа одновременно выполняются три условия. Если ломается хотя бы одно из них, объект немедленно отправляется по полному пути decode-and-reserialize, поэтому корректность здесь всегда выигрывает у скорости:
Doc2.IsChangedObject(X)равно False. Если merge engine уже мутировал объект в памяти, например page object, у которого был перепривязан/Parent, то источником истины является уже in-memory tree, а исходные байты устарели. Для byte path годятся только действительно нетронутые объекты- Исходные байты не содержат ключевого слова
stream. Тело stream object - это непрозрачный binary payload, ограниченныйstream/endstream, и наивный scan ссылок по сжатым или зашифрованным stream data happily "найдет" и испортит байтовые последовательности, похожие на reference. Stream object остаются на исходном stream-aware path - Исходные байты не содержат ни
/StructTreeRoot, ни/StructElem. В fast profile tagged-PDF structure tree отбрасывается, а не объединяется, поэтому такие объекты обязаны идти через decode path, где engine может занулить их намеренно
Решение живет в per-object copy loop. Если все три условия проходят, байты объекта идут прямо в ShiftIndRefsInSource и затем в writer. Иначе байты отбрасываются, объект пересобирается через GetObject, смещается через ShiftIndRef и сериализуется. Структуру этой ветки стоит увидеть, потому что именно порядок проверок и делает ее безопасной:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // переключиться на декодирование
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // полный путь разбора
  // ... обнулить объекты дерева структуры, ShiftIndRef, Obj.Output ...
end;
Пустой ObjectData является сигналом, что byte path отказался от объекта. Этот один sentinel не дает fast и slow route разъехаться: существует ровно одно место принятия решения и ровно один fallback
Машина состояний для сдвига ссылок и ее крайние случаи
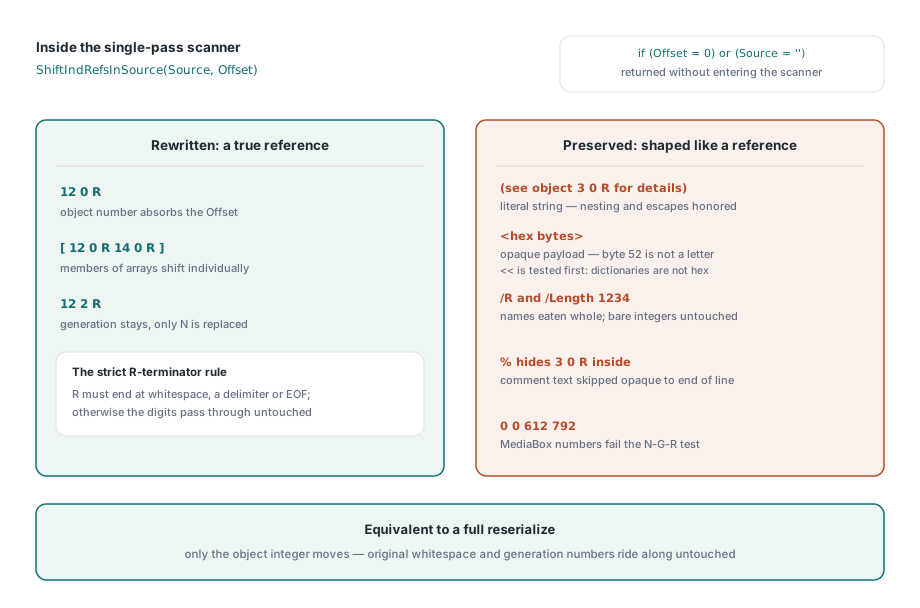
Byte rewrite косвенных ссылок обманчиво легко сделать неправильно, потому что R и длинные серии цифр встречаются по всему PDF object в контекстах, которые ссылками не являются. ShiftIndRefsInSource - это небольшой hand-written scanner, который один раз проходит по байтам и переписывает число только тогда, когда за ним, с PDF whitespace между token, следует другое число, а затем delimiter R. Дешевые выходы стоят первыми: если offset равен нулю или source пуст, байты возвращаются без изменений, и scanner вообще не запускается
Корректность scanner держится на распознавании контекстов, где последовательность, похожая на reference, должна быть оставлена в покое. Именно эти границы легче всего пропустить, и каждая из них обрабатывается явно:
- Literal string, ограниченные
(и), копируются как есть, с отслеживанием глубины вложенности и уважением к escape backslash, чтобы экранированная скобка не сбивала счетчик глубины. Строка вроде(see object 3 0 R for details)содержит textbook pattern ссылки, но на самом деле это просто проза, и она обязана пережить rewrite байт в байт - Hexadecimal string, ограниченные
<и>, проходят без интерпретации. Байты52внутри hex string являются ASCII-кодом дляR, и scanner, который трактовал бы hex payload как text, легко изготовил бы phantom reference. Открывающая<<dictionary распознается раньше, чтобы dictionary не был ошибочно принят за hex string - Name object, начинающиеся с
/, поглощаются целиком, от slash до следующего whitespace или delimiter. Без этого имя вроде/R, обычного resource key, могло бы быть прочитано какRиз ссылки - Comment, вводимые через
%, тянутся до конца строки и пропускаются как непрозрачный text - Тест "число затем R" сделан строгим. Reference распознается только как
NwhitespaceGwhitespaceR, причемRобязательно завершается whitespace, delimiter либо концом input. Если generation number отсутствует, либо послеRследует буква, цифры выдаются без изменений. Именно это защищает от тихого инкремента integer в/Length 1234и четырех чиселMediaBox
Сердце этого строгого теста выглядит почти в точности так, как это предложение описано в спецификации:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // номер смещённого объекта
  AppendBytes(E1, P - E1);                 // original whitespace + generation
  AppendBytes(P, 1);                       // the 'R'
end;
Переписывается только object number. Generation number и точный исходный whitespace между token копируются как есть, поэтому output совпадает с input побайтно, за исключением одного integer, который действительно нужно было изменить. В этом вся цель - именно такая точность делает повторное использование исходных байтов эквивалентом полного reserialize, а не лишь чем-то «почти похожим». Если пишете такой scanner сами, проверяйте его на голых reference, reference внутри array, числах, не являющихся reference, literal string, hex string и ненулевых generation number при приложенном offset
Почему bookmark не могли переиспользовать AppendOutline
Слияние bookmark из нескольких документов в одно outline tree выглядит задачей для уже существующего helper AppendOutline, который и так умеет пришивать top-level bookmark одного документа к другому. Но здесь это неправильный инструмент, и причина - в тонком несовпадении слоев. AppendOutline находит текущий последний top-level bookmark, обходя reader по исходным байтам файла. Но fast merge держит свои правки в new-objects buffer через ChangeObject; reader эти правки никогда не видит. Сцепите три документа и больше - и каждое добавление перепривязывает исходный последний bookmark первого документа к самому новому, так что все промежуточные bookmark выпадают из цепочки. Верным остается только суммарный /Count, из-за чего баг легко не заметить, пока кто-то не откроет панель bookmark
Fast path решает эту задачу двухфазным, управляемым метаданными injection, которое никогда не делает повторный walk reader. Первый проход по всем input собирает для каждого документа номер и generation объекта корня outline, номера first и last top-level bookmark и /Count корня. По этому summary код вычисляет глобальные object number всех link, которые нужно собрать: top-level /Parent каждого документа к общему root, /Prev первого bookmark к last предыдущего документа, /Next последнего bookmark к first следующего документа - и всё это чистой арифметикой по номерам объектов. Здесь есть constraint порядка записи: объекты первого документа выводятся до того, как открыт хоть один следующий документ, поэтому все outline-правки первого документа (/Count и /Last корня, а также /Next старого последнего bookmark) должны выражаться арифметикой, не требующей наличия следующего документа под рукой. Правки следующих документов применяются на месте после открытия документа, но до записи, и уходят наружу через тот же change-object путь
Инвариант выравнивания offset, который связывает все вместе
И reference shift, и bookmark injection зависят от одного арифметического инварианта, и это самое хрупкое предположение во всем дизайне. Reference, внедренная в следующий документ, записывается как целевой глобальный номер объекта минус Offset этого документа, чтобы при последующем сдвиге объекта через ShiftIndRef(Offset) значение попало точно в intended global number. Первый документ получает Offset = 0 и использует глобальные номера напрямую. Для корректности этого вычитания последовательность running offset, использованная при injection, должна совпадать с последовательностью offset, используемой при окончательной записи объектов
Она совпадает благодаря свойству того, как устроены merge страниц и forms: AddPages, AddFields и AddFieldFonts модифицируют только уже существующие объекты первого документа и никогда не добавляют новые. Поэтому object count первого документа не меняется на стадии page-merge, а offset каждого следующего документа (сумма object count всех предыдущих документов) остается стабильным от injection до write-out. Нарушьте это - добавьте стадию, создающую новый объект посреди merge, - и каждая page и bookmark reference дальше по цепочке съедет на число добавленных объектов. Инвариант тихий, но несущий
Три entry point поверх одного engine
Fast path - это не отдельный fork merge-кода. Byte-level engine - единый internal routine MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), а публичные API - тонкие wrapper, выбирающие два флага:
MergeFileListFastвызывает engine с выключенным сохранением structure tree - это самый легкий путь, сбрасывающий tagged-PDF tree, чтобы byte route применялся к максимально возможному числу объектовMergeFileListвызывает его с сохранением structure tree, поэтому tree выживает, а результат остается пригодным tagged PDF. Этот обычный путь также наследует merge bookmark и form для нескольких документовMergeFileListStrictвключает strict mode: первый metadata pass останавливается на первом input, который не отчитывается о clean merge, поэтому в результат попадают только документы, собранные до плохого файла, вместо того чтобы тихо пропустить плохой и идти дальше
Поскольку все три делят один engine, обычный merge тоже бежит единым линейным проходом, открывающим каждый input ровно один раз, а не pairwise-циклом O(N²), который сливает файлы один и два, сливает результат с третьим и так далее, каждый раз заново парся растущий accumulator. Два entry point для двух файлов и двух потоков, MergeFiles и MergeStreams, остаются доступны для тех вызывающих сторон, которым действительно нужен pairwise merge
Одно замечание о поведении structure tree, важное, если вы проверяете вывод осмотром байтов. Fast path сбрасывает tree, убирая ссылку catalog первого документа на /StructTreeRoot; сам object structure tree всё равно записывается, уже без ссылок на него. Поэтому в байтах fast output строка /StructTreeRoot всё ещё присутствует, и простым поиском этой строки fast от ordinary output не отличить - настоящая разница в том, достигает ли catalog structure tree, и именно это определяет, остается ли файл navigable tagged PDF
Когда выбирать какой путь
Byte path - это optimization по throughput для сборки множества документов там, где structure tree tagged PDF сохранять не нужно - пакетная bundling отчетов, statement run, batch concatenation. В измерениях на повторяющихся merge средних и крупных наборов input повторное использование байтов снимало примерно от четырех до тринадцати процентов wall-clock time в зависимости от смеси объектов, а маленькие и malformed input ведут себя в точности как на полном пути, потому что любой объект, который scanner не может доказать безопасным, откатывается к полному parse. Если structure tree нужен нетронутым ради accessibility, используйте обычный merge-путь tagged-PDF, который его сохраняет; а если вы работаете не со множеством input, а с очень большими одиночными файлами, byte-copy techniques из сопутствующего материала о слиянии и разбиении больших PDF с прямым доступом к файлу применяют ту же философию «копировать байты и избегать полного object tree» уже в масштабе файла
Merge routine и их fast и strict варианты входят в PDF Library for Delphi Delphi PDF Library, чья документация несет полный reference для file-list API и описанных здесь merge options