Возьмите файл, чей словарь информации говорит /Title (Annual Maintenance Report), тогда как в XMP-пакете нет никакого dc:title. Просмотрщики показывают заголовок без возражений, но валидатор PDF/A отвергает файл, потому что две копии метаданных расходятся. Второй файл выглядит столь же здоровым, но не имеет записи pdfaid:part в XMP, и валидатор отвечает десятками ошибок: он судит файл как обычный PDF и докладывает каждое правило заявленной части проваленным — всё из одной отсутствующей строки
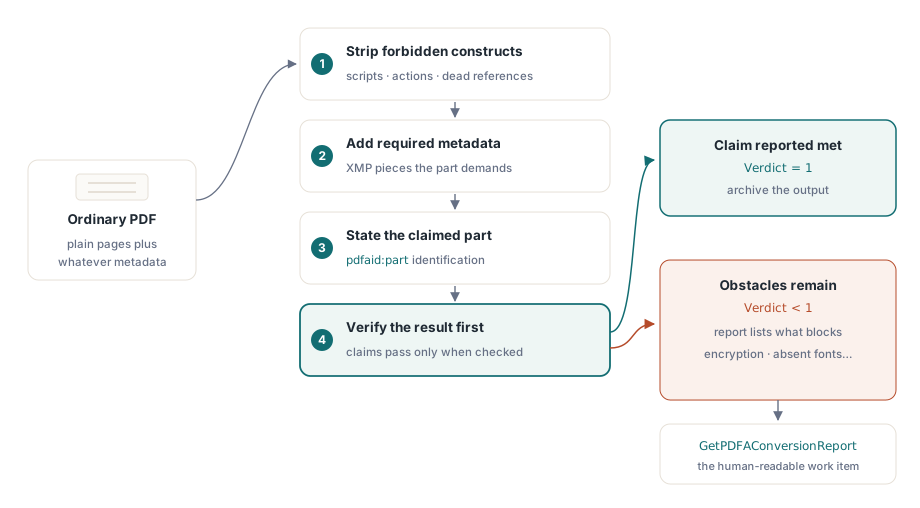
Двум проблемам нужны очень разные объёмы работы. Согласование метаданных — узкая починка, которую можно гнать на любом файле. Превратить произвольный PDF в архивный — значит срезать то, что целевая часть запрещает, добавить то, что требует, заявить претензию, а затем провалидировать байты, которые реально вышли. Мы построили конвертацию вокруг того последнего шага нарочно. ConvertToPDFA, поставляемый в издании Enterprise (TPDFlibEnterprise) вместе с GetPDFAConversionReport, сохраняет конвертированный документ в память, гоняет проверку PDF/A по тем байтам и возвращает 1, только когда проверка проходит
Почему корректный на вид PDF не проходит проверку PDF/A?
Обе неудачи — из правил метаданных. PDF записывает заголовок, автора, производителя и даты в словарь информации документа, и PDF/A требует тех же фактов в XMP-пакете метаданных; ISO 19005-1 §6.7.3 просит эквивалентности двух, и PDF/A-2 с PDF/A-3 правило сохраняют. Среди файлов, падающих на этом правиле, обычный рисунок — производитель заполнил словарь информации и так и не написал XMP-половину, поэтому валидатор находит заголовок в одном месте и ничего в другом
Отсутствующая идентификация тише. Записи pdfaid:part и pdfaid:conformance — то, что помечает файл как PDF/A, и файл может быть совершенно корректным без них. Случай, который мы видим чаще всего, — приложение подсовывает собственный XMP-пакет, заменяя тот, что сгенерировал PDF-писатель; кастомный пакет несёт собственные поля приложения и никаких записей pdfaid, поэтому список ошибок указывает вовсе не туда, где настоящая причина
RepairDocumentMetadata разбирает оба случая и возвращает число изменённых записей. Он доступен в каждом издании, как и SetPDFAMode с SanitizeDocument. Починка проходит по Title, Author, Subject, Keywords, Creator, Producer, CreationDate и ModDate. Где значение несёт только XMP — словарь информации заполняется из него, так что ничего уже записанного не выбрасывается. Где несут обе и они расходятся — побеждает словарь информации. Мы так решили, потому что словарь информации — та половина, которую производители выставляют чаще всего, что делает её более вероятной записью того, что имел в виду автор
Если ваш XMP — авторитетная копия (скажем, выхоленная в системе управления документами), затолкайте нужные значения в словарь информации через SetInformation и лишь потом гоните починку. Наоборот — значит затереть выхоленный XMP-заголовок тем, что написал исходный производитель
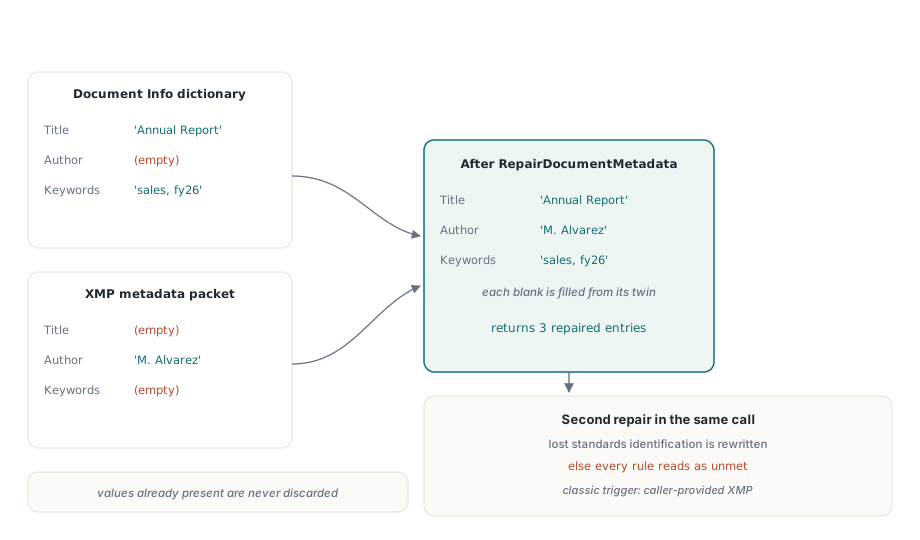
Починке идентификации нужно от вас одно: документ должен знать, на какую часть метит. У свежезагруженного файла режим PDF/A не выставлен, поэтому вызовите SetPDFAMode до починки. С выставленным режимом RepairDocumentMetadata пишет соответствующие записи pdfaid, добавляет pdfaid:rev с годом 2020 для режимов части 4 и ставит dc:format в application/pdf, что валидаторы тоже проверяют
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // Выхоленный заголовок идёт в словарь информации первым,
    // потому что та копия побеждает, когда половины расходятся
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, см. таблицу ниже
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Выбор целевой части и её номера режима
Берите часть по тому, что документ обязан нести, и лишь потом глядите номер. SetPDFAMode и ConvertToPDFA делят одну схему нумерации, и она не идёт в том порядке, какой подсказывают имена частей
| Режим | Часть и уровень | Примечания |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, с тегами |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, с тегами |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | Встроенные файлы любого типа разрешены |
| 8 | PDF/A-2u | PDF 1.7, требуется Unicode-текст |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0; 4e добавляет 3D и rich media, 4f разрешает встроенные файлы |
Режим 3 — это PDF/A-2b, а режим 4 — PDF/A-2a. Та инверсия ловит тех, кто считает от 1a и предполагает, что a-уровень всегда впереди. PDF/A-2u появляется под номером 8, после режимов части 3
Выбор с реальными последствиями — про вложения. Части 1 и 2 запрещают встроенные файлы, поэтому ConvertToPDFA убирает их для режимов с 1 по 4 и режима 8. Конвертируйте счёт Factur-X или ZUGFeRD в режим 3 — и структурированный XML-счёт уйдёт из вывода вместе с причиной существования файла. Для всего, что несёт вложение, целевой режим — 5 (PDF/A-3b), на котором те форматы счетов и определены, либо 11, если нужен PDF 2.0. Каждое вложение в файле части 3 или части 4 обязано через /AFRelationship заявить, как оно относится к документу, и PDF Library for Delphi пишет ту запись для каждого встроенного файла, который сохраняет в тех режимах
Часть 4 идентифицирует себя иначе. У неё нет буквы соответствия для простого PDF/A-4, E или F — для двух расширений, и требуется pdfaid:rev с годом публикации её части. ConvertToPDFA поднимает файл до PDF 2.0 для режимов с 9 по 11, потому что ISO 19005-4 §6.1.2 строит часть на PDF 2.0, и проверка судит такие файлы по PDF 2.0 вместо 1.7
Что ConvertToPDFA меняет в файле
ConvertToPDFA делает фиксированную последовательность починок, отмечает каждую в текстовом отчёте, сохраняет результат в память и валидирует те байты. Проваленная проверка возвращает 0, как и режим вне 1–11 — тот возвращает ещё до записи какого-либо отчёта. Последовательность стоит знать, потому что каждый шаг — то, что вывод потеряет или приобретёт:
- Зашифрованный документ с неизвестным паролем останавливает конвертацию сразу строкой
blocked:; внутри него нечего читать, не то что чинить - JavaScript уровня документа и открывающее действие, которое его запускает, удаляются вместе со всеми записями дополнительных действий и типами действий, которых не допускает ни одна часть, — среди них Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition и Trans. Ссылки GoTo и URI остаются, так что навигация продолжает работать
- Встроенные файлы удаляются для частей, которые их запрещают, как описано выше
- Аннотации, скрытые или выставленные никогда не показываться, удаляются. PDF/A требует, чтобы аннотации были видимы и печатаемы, а выставлять их напоказ значило бы менять вид страницы, поэтому мы выбрали удаление
- Виды полей формы перегенерируются до сброса флага
/NeedAppearances, поэтому вписанные значения остаются видимыми - Используемые, но не встроенные шрифты встраиваются из шрифтов, установленных на машине
- Объекты, на которые больше никто не ссылается, выбрасываются, и если у файла нет sRGB output intent, он добавляется
- Наконец часть и уровень заявляются в XMP, и байты проверяются
На сервере шаг шрифтов — тот, что чаще всего стопорит конвертацию. Документ, использующий шрифт, которого нет нигде на хосте конвертации, нельзя починить изнутри файла, и отчёт так и скажет. Установите шрифты, которые ваши документы реально используют, на машину конвертации; разбор встраивания недостающих шрифтов в существующий PDF покрывает тот шаг отдельно
Как пакетному заданию обращаться с провалившейся конвертацией?
Считайте возвращаемое значение шлюзом, а отчёт — рабочим талоном. Архивируйте файлы, вернувшие 1, а остальные маршрутизируйте человеку с приложенным отчётом. Не сохраняйте вывод провалившейся конвертации в архив лишь потому, что он выглядит чище входа. Тот файл теперь несёт претензию PDF/A, которую проверка отказалась подтвердить, — ровно та ситуация, ради предотвращения которой существует шаг проверки
Отчёт из GetPDFAConversionReport — по строке на действие, каждая начинается с глагола: removed:, regenerated:, repaired:, embedded:, added:, stated:, плюс blocked:, если что-то остановило прогон, и закрывающая строка result:. Проверка за вердиктом останавливается на первой неудаче, поэтому когда файл падает, конвертация гоняет проверку ещё раз целиком, и отчёт показывает все проблемы разом. Маршрутизация по префиксам — несколько строк
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, сохраняет вложения
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Оригинал не трогаем; с ним уходит только отчёт
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Строка blocked: обычно значит, что исправление лежит вне PDF: пароль, другой исходный файл или перезапуск того, что документ породило. Обычные проблемы валидации после полной конвертации чаще — содержимое, несущее смысл и не подлежащее простому удалению, и это как раз случаи, где решать приходится человеку
Чтение метки, которую файл уже несёт
Перед конвертацией проверьте, что документ уже заявляет о себе. Файлы от сканеров, офисных пакетов и прочих PDF-инструментов часто уже несут метку PDF/A, а переконвертация валидного PDF/A-3 в часть 2 стоила бы ему вложений ни за что
Ловушка в том, что XMP позволяет записать одно свойство двумя способами. Одни производители пишут часть дочерним элементом, <pdfaid:part>2</pdfaid:part>; другие — атрибутом на rdf:Description, pdfaid:part="2". Обе — обычный валидный XMP. Детектор, ищущий лишь одну форму, решает, что файлы от другого семейства производителей метки не несут, а собранный так чекер кончает тем, что судит валидный PDF/A-2 по части 1 и докладывает его немаркированным и слишком высокой версии — точная противоположность правды. Валидатор в PDF Library for Delphi читает обе формы. Принюхиваетесь сами — делайте так же:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // форма элемента
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // форма атрибута, двойные кавычки
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // форма атрибута, одинарные кавычки
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Пустой результат значит метки нет ни в одной форме. Цифра говорит, какую часть имел в виду производитель, и именно с тем числом сравнивайте свою цель, прежде чем решать, конвертировать ли вообще
Чистка скриптов до попадания файла в архив
Архивная конвертация и охранная чистка обычно идут вместе, поскольку содержимое, которое политика безопасности хочет убрать, сильно пересекается с тем, что запрещает PDF/A. SanitizeDocument берёт битовую маску флагов SANITIZE_* и возвращает, сколько удалений применил. Сам ConvertToPDFA зовёт его с SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION первым шагом
Валидаторам важна одна деталь. Скрипты уровня документа живут в дереве имён /JavaScript под словарём /Names каталога, и когда последний скрипт удалён, опустевшее дерево удаляется вместе с ним. Пустое дерево всё ещё объявляет, что документ несёт скрипты, и некоторые чекеры реагируют на сам ключ, не считая, что под ним
Чем бы ни чистили, проверьте сохранённый файл свежей загрузкой вместо доверия состоянию в памяти. Переоткрытие дёшево:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
Для соседних шагов архивного конвейера — руководства по предполётной проверке PDF/A и PDF/UA, истинному редактированию и удалению содержимого и схемам расширения XMP PDF/A-3 для Factur-X, которая подхватывает сторону метаданных, когда архивный документ ещё и несёт структурированные данные счёта
Вся конвертация, починка метаданных и валидация, показанные здесь, идут внутри вашего собственного процесса Delphi, C++Builder или Lazarus, без внешнего конвертера или командного валидатора в цепочке. Части PDF/A, издания и целевые платформы перечисляет страница продукта PDF Library for Delphi