Счёт на китайском, набранный Noto Sans SC из её файла .otf, может открыться в mutool с чужими иероглифами там, где должно стоять имя клиента, — при том что TrueType-начертание ту же страницу рисует правильно. Виноват CFF charset шрифта: PDFlibPas переписывает его на identity во встраиваемой копии, так что коды-индексы глифов попадают на предназначенные им глифы
Проявится ли проблема в конкретном шрифте, зависит от того, как он собран. TrueType-программа, встроенная как шрифт CIDFontType2, получает CIDToGIDMap со значением Identity, и код из content stream попадает на нужный глиф. Большинство латинских OpenType-шрифтов с контурами CFF — name-keyed, а name-keyed CFF-программа использует входящий CID прямо как индекс глифа. ISO 32000-1 даже отмечает в §9.7.4.2, что во многих шрифтах CID и GID совпадают. Но не во всех. Большие CJK-семейства, собранные как CID-keyed шрифты, — среди них Noto Sans CJK и родственные Source Han — несут собственную CID-нумерацию, и writer, отправляющий индексы глифов прямо в эту нумерацию, получает тот глиф, которому достался совпавший CID
Что CID-keyed CFF-программа делает с CID
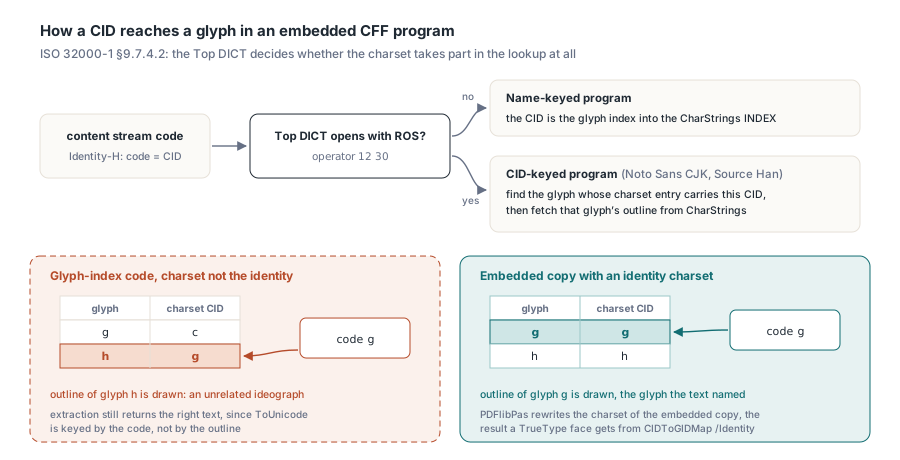
ISO 32000-1 §9.7.4.2 делит встроенные CFF-программы на два случая по Top DICT. Если Top DICT использует операторы CIDFont — на практике он открывается оператором ROS (оператор 12 30: registry, ordering, supplement) — reader берёт CID из content stream, находит глиф, запись которого в charset несёт этот CID, и лишь затем достаёт контур из CharStrings INDEX. Без операторов CIDFont CID — это и есть индекс глифа, charset участия не принимает. Любой reader, следующий §9.7.4.2 буквально, нарисует для кода-индекса глифа не тот глиф, пока charset не identity, — в каком бы просмотрщике вы его ни открывали. Сам charset, определённый в Adobe Technical Note #5176, существует в трёх раскладках с двумя особыми случаями:
- Format 0 хранит один 2-байтовый SID или CID на глиф, в порядке глифов
- Format 1 хранит диапазоны: первый CID и следом 1-байтовое число глифов, идущих за ним с последовательными CID
- Format 2 — та же раскладка диапазонов с 2-байтовым счётчиком, что удобно для шрифтов с длинными непрерывными сериями
- Глиф 0 — это
.notdef, записи ни в одном формате он не имеет; смещение charset 0, 1 или 2 называет один из предопределённых charsets вместо указания на данные
Так что начните с выяснения, какой перед вами шрифт. Identity-H на стороне PDF говорит лишь о том, что 2-байтовый код равен CID. Как этот CID добирается до глифа, целиком живёт внутри шрифтовой программы. Функция ниже читает таблицу CFF из файла .otf, идёт по Top DICT в поисках ROS и проверяет, отображает ли charset каждый глиф в CID с тем же номером. Ей нужен только RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // усечённый файл поднимет ERangeError вместо неверного чтения
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Возвращает конец INDEX, стоящего на Pos, и выделяет его первый объект
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // смещения отсчитываются здесь от 1
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // вещественное число
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // зарезервированный байт
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // у .notdef нет записи
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Отчёт с CIDKeyed = True и IdentityCharset = False описывает ровно тот шрифт, о котором эта статья: любой writer, кладущий индексы глифов в content stream без учёта такого charset, нарисует им не те глифы. Name-keyed результат или CID-keyed шрифт, чей charset и так оказался identity, под тем же writer рендерится правильно. Именно поэтому одно CJK-начертание в продукте работает, а следующее за ним — нет. Цикл сравнивает только первый CID каждого диапазона, и этого достаточно: диапазон покрывает последовательные глифы с последовательными CID, так что диапазон, начавшийся с собственного индекса глифа, остаётся на нём до конца
Индексы глифов проходят через весь шрифтовой словарь
CID в руках у PDF writer обычно нет. Таблица cmap и шейпинг-движок возвращают индексы глифов, поэтому естественный дизайн записывает эти индексы 2-байтовыми кодами Identity-H и привязывает к ним всё остальное: массив ширин /W, битовую карту /CIDSet, которую запрашивает PDF/A, и ToUnicode CMap, позволяющий извлечению восстановить исходный текст. У TrueType есть запасной выход: таблица 117 предлагает CIDToGIDMap, но лишь для CIDFonts типа 2; CFF-программа живёт в шрифте CIDFontType0, который не умеет перенаправлять CID со стороны PDF. Тем самым отсекается и трюк, к которому некоторые writer прибегают с TrueType, — выдавать повторно используемому глифу второй CID-«алиас» за концом шрифта, чтобы ToUnicode прицепил к каждому употреблению свой текст. В CFF-шрифте такой алиас не выбирает ни одного глифа, и mutool сообщает, что не может его отрисовать. Шрифты, отображающие U+4E00 и U+2F00 (KANGXI RADICAL ONE) в один контур, — типичный случай. Если документу нужно, чтобы эти два знака извлекались по-разному, оберните употребление в marked-content span с /ActualText (ISO 32000-1 §14.9.4) — reader возьмёт его вместо шрифтового отображения
Переписываем charset на месте
Согласовать коды-индексы глифов с CID-keyed программой можно двумя путями. Первый переводит каждый индекс глифа в CID шрифта перед записью, а это задевает коды content stream, ключи /W, битовые позиции в /CIDSet, исходные коды в ToUnicode и каждый сабсет, собираемый при сохранении. Второй меняет единственную не согласную структуру — сам charset — так, что шрифт начинает отвечать на индексы глифов, как отвечала бы name-keyed программа. Второй путь надёжнее. Шейпер, таблица ширин, сабсеттер и сборщик ToUnicode продолжают работать в пространстве глифов, и единственный код, обязанный понимать CID, — короткая подпрограмма, которая один раз проходит по встроенной копии шрифта. PDFlibPas идёт именно этим путём
Переписывание сохраняет формат charset и его длину в байтах. В format 0 каждая запись перезаписывается собственным индексом глифа. В formats 1 и 2 меняется только первый CID каждого диапазона, счётчики остаются как были. Ничего не растёт и не сжимается. Смещения Top DICT на CharStrings, Private DICT, FDArray и FDSelect остаются валидными без перекодирования чего бы то ни было, а FDSelect — раздающий словари хинтинга по индексам глифов — оставляет каждый глиф в его исходном FD. Name-keyed программы, предопределённые charsets, таблицы CFF2 (у них charset нет) и программы, которые не разбираются, остаются нетронутыми. Переписывание запускают три кодовых пути:
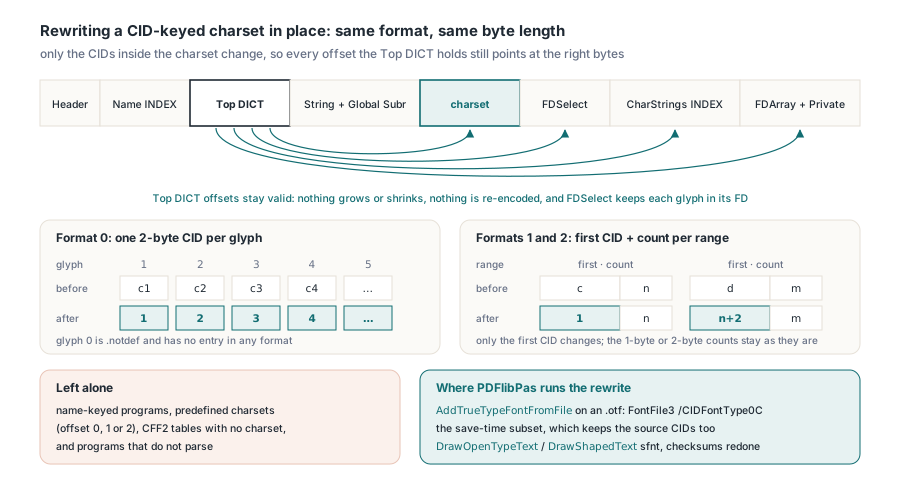
AddTrueTypeFontFromFileдля файла.otfвстраивает голую таблицуCFFкакFontFile3с подтипомCIDFontType0C, и charset уже переписан- Сабсет, собираемый при сохранении, хранит исходные индексы глифов, но и исходные CID тоже, так что его charset переписывается второй раз
- Шейпинговый компаньон за
DrawOpenTypeTextиDrawShapedTextхранит весь sfnt; после переписывания контрольная сумма таблицыCFFпересчитывается, аcheckSumAdjustmentтаблицыheadстановится равным0xB1B0AFBAминус сумма файла - Такая поправка определена только для одиночного шрифта, так что начертание, взятое из коллекции, получает лишь контрольную сумму таблицы
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // CFF-вариант .otf встраивается как FontFile3 /CIDFontType0C;
    // встроенная копия получает identity charset, если шрифт CID-keyed
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Проверяйте результат отрисовкой — извлечение текста проблему не покажет. pdftotext и все остальные экстракторы читают ToUnicode, который ключуется кодом из content stream и понятия не имеет, какой контур шрифт для него выбирает, поэтому страница с чужими иероглифами всё равно извлекает правильную строку. mutool draw -r 150 -o page%d.png noto-sc.pdf показывает, как страница выглядит на самом деле, а для этого пути DrawText pdffonts noto-sc.pdf из состава poppler должен перечислить шрифт как CID Type 0C. Ожидаемо: обе строки отрисовываются в Noto Sans SC теми глифами, которые называет исходный текст, и тот же результат выдаёт Ghostscript
Какой вариант встраивания требует PDF 1.6?
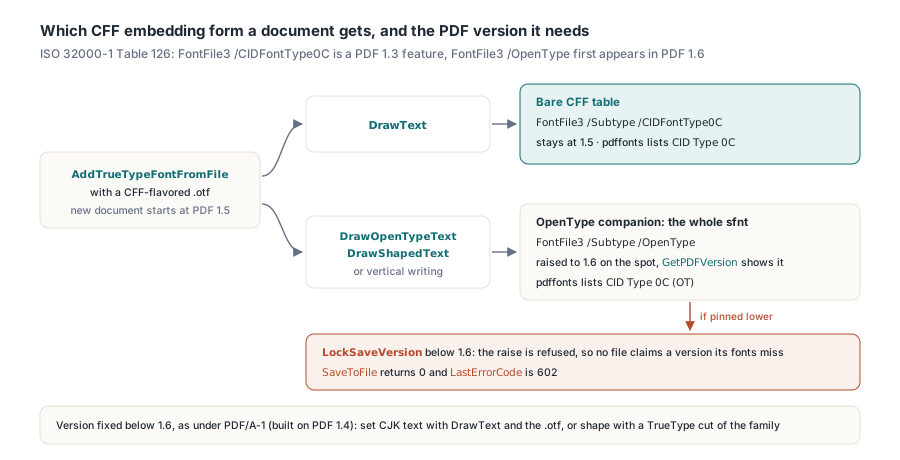
Вариант OpenType. Таблица 126 ISO 32000-1 относит поток FontFile3 подтипа CIDFontType0C к возможностям PDF 1.3, тогда как подтип OpenType — весь sfnt с его таблицей CFF — впервые появляется в PDF 1.6. Новые документы PDFlibPas стартуют с версии 1.5, внутрь которой голый-CFF путь DrawText укладывается. Первый же вызов DrawOpenTypeText, DrawShapedText или вертикального набора с CFF-начертанием создаёт компаньона OpenType и тут же поднимает документ до 1.6, что GetPDFVersion сообщает немедленно. Блокировка версии меняет дело: если LockSaveVersion прижал документ к более низкой, подъём отклоняется, SaveToFile возвращает 0 с LastErrorCode 602, и ни один файл не заявляет версию, которой его шрифты не соответствуют. Когда профиль поставки фиксирует версию ниже 1.6 — типичный случай PDF/A-1, поскольку он построен на PDF 1.4, — набирайте CJK-текст через DrawText с файлом .otf либо берите TrueType-срез семейства для всего, что требует шейпинга
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Ожидаем: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Ожидаем: 1.6
    Lib.SaveToFile('shaped.pdf');  // Ожидаем в pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Ожидаем: 602
  finally
    Lib.Free;
  end;
end;
Ширины и ToUnicode ключуются теми же числами
Как только charset становится identity, CID, индекс глифа и код content stream — одно и то же число. Ширины следуют за ним. ISO 32000-1 §9.7.4.3 индексирует /W самим CID, группами в виде либо стартового CID с массивом ширин, либо первого CID, последнего CID и одной общей ширины, без смещения /FirstChar, каким пользуются простые шрифты. Любой CID, которого в массиве нет, получает /DW, а таблица 117 задаёт умолчание для /DW в 1000. Ноль — неверно. Reader, откатывающийся к 0 для не перечисленных CID, схлопывает строку иероглифов в одну точку. Для файла .otf, загруженного через AddTrueTypeFontFromFile, PDFlibPas пишет массив /W, стартующий с CID 0 и перечисляющий продвин каждого глифа, рядом с явным /DW 1000. На стороне чтения CJK-текст, извлекающийся как мусор обычно спотыкается в codespace-половине того же конвейера, а аудит шрифтов PDF/UA по ширинам, CharSet и CIDSet сверяет эти массивы со встроенной программой
У ToUnicode своё правило нумерации. Запись bfrange хранит лишь первую строку назначения, и §9.10.3 требует, чтобы последний её байт не выталкивался за 255 длиной диапазона: reader порождает следующие назначения, инкрементируя только этот последний байт. Последовательные глифы с отображением в U+4EFE, U+4EFF, U+4F00 и U+4F01 выглядят как один диапазон, но это не так: третий reader декодировал бы как U+4E00. Writer в PDFlibPas сливает соседние пары глиф-Unicode в один bfrange только когда и исходные коды, и назначения умещаются в одном блоке из 256, иначе разбивает серию. Вертикальный CJK-набор идёт через те же компаньон-шрифты, поэтому вертикальный японский и китайский текст наследует identity charset и эти диапазоны ToUnicode без дополнительных вызовов
Каждое начертание, которое InspectOtfCharset сообщает как CID-keyed с не-identity charset, — это случай, где коды-индексы глифов и шрифт расходятся. Встроенное через PDFlibPas for Delphi, такое начертание сохраняет свои контуры, смещения и длину charset, а меняются CID в той единственной таблице плюс контрольные суммы, когда хранится весь sfnt