O funcționalitate de citire cu voce tare are o singură sarcină vizibilă dincolo de voce: pe măsură ce fiecare cuvânt este rostit, trebuie să lumineze acel cuvânt pe pagină și să îl păstreze în vizor. Pentru asta aveți nevoie de dreptunghiul de încadrare al fiecărui cuvânt, indexat față de același flux de caractere din care citește motorul de vorbire. Obțineți dreptunghiurile, dar ratați indexarea, iar evidențierea rămâne în urma audio-ului cu un cuvânt sau două; obțineți indexarea, dar tratați greșit starea paginii, iar evidențierea ajunge pe o pagină complet greșită. Partea de vorbire din toate acestea, sintetizatorul în sine, este partea care se defectează rareori. SAPI raportează limitele cuvintelor cu precizie de caracter. Ce se defectează este stratul subțire de mapare dintre un decalaj de caracter în bufferul de vorbire și un dreptunghi pe pagina randată
PDFium Component livrează acea mapare pentru Delphi, C++Builder și Lazarus, cu dreptunghiurile de cuvinte disponibile de la v1.53 și cursorul de urmărire de la v1.56. Suprafața este în mod deliberat îngustă: un apel care returnează dreptunghiurile de cuvinte pentru o pagină, un tracker care transformă un decalaj de caracter într-o evidențiere desenată și câteva proprietăți pentru culoare și derulare automată. Oricât de îngustă ar fi, ordinea în care apelați lucrurile decide dacă funcționalitatea merge, iar majoritatea eșecurilor de mai jos provin din apelarea funcțiilor corecte în ordinea greșită
Caracterele nu sunt cuvinte, iar motoarele TTS vorbesc în caractere
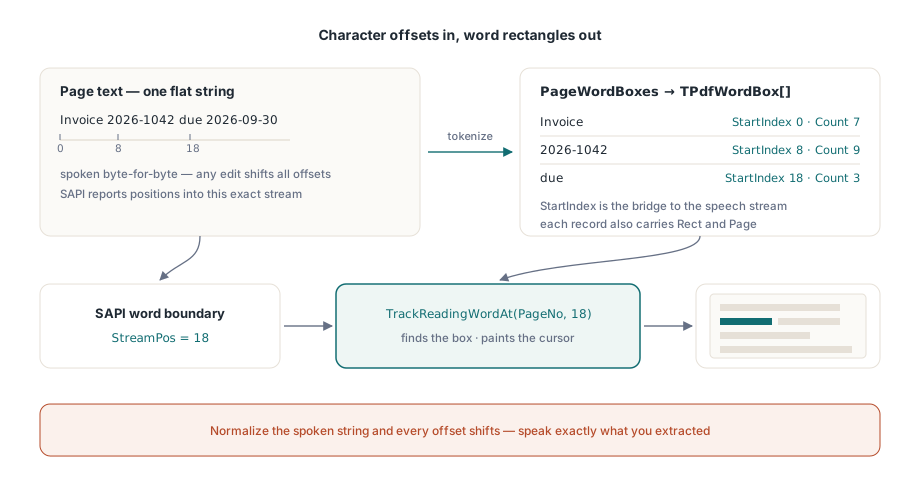
Un motor de vorbire consumă un șir plat și raportează progresul ca poziții de caracter în interiorul acelui șir. O pagină PDF are glife plasate în spațiul paginii, unde un „cuvânt” este un cluster euristic de secvențe de glife. Cele două sisteme de coordonate nu au nimic în comun, decât dacă textul pe care îl dați sintetizatorului este identic, octet cu octet, cu textul din care au fost calculate dreptunghiurile de cuvinte. Aceasta este regula unu, și este neiertătoare. Normalizați spațiile albe, eliminați cratimele moi, sau altfel „curățați” textul extras înainte de a-l rosti, iar fiecare decalaj din aval devine în tăcere greșit. Rostiți exact ce ați extras, sau păstrați un tabel explicit de remapare a decalajelor. Nu există o a treia opțiune care să supraviețuiască documentelor reale
Tabelul de remapare nu este un caz-limită ipotetic. În clipa în care interfața dvs. inserează un anunț rostit de pagină („pagina cinci”) sau extinde o abreviere pentru sintetizator, șirul rostit diverge de cel extras. Înregistrați poziția și lungimea fiecărei inserări, apoi scădeți ajustarea acumulată înainte de fiecare apel de urmărire. Sunt cam douăzeci de linii de contabilitate, iar aceasta este diferența dintre o evidențiere care supraviețuiește următoarei cereri de funcționalitate și una care se defectează prima dată când cineva cere titluri rostite
Ce vă oferă un dreptunghi de cuvânt
Fiecare înregistrare TPdfWordBox poartă textul cuvântului, StartIndex-ul și Count-ul de caractere ale acestuia în interiorul textului paginii, un Rect în spațiul paginii și numărul de Page bazat pe 1. Câmpul StartIndex este puntea dintre cele două sisteme de coordonate: este exact decalajul pe care SAPI îl va returna pe măsură ce citește. PageWordBoxes returnează întregul array pentru pagina activă:
procedure TReaderForm.PreparePage(PageNo: Integer);
begin
  PdfView.PageNumber := PageNo;   // dreptunghiurile de cuvinte ale vizualizării urmăresc pagina afișată de aceasta

  FWords := PdfView.PageWordBoxes;
  FPageText := BuildSpeechText(FWords);   // concatenează Word.Text în ordine

  if Length(FWords) = 0 then
    HandleImageOnlyPage(PageNo);          // o scanare fără strat de text
end;
Comentariul despre ordine are rol structural. PageWordBoxes al vizualizatorului tokenizează stratul de text al paginii pe care vizualizarea o afișează în prezent, așa că navigați mai întâi vizualizarea și extrageți al doilea; nu este necesară nicio randare, doar un document deschis. (Componenta document, TPdf, expune propriul PageWordBoxes, cheiat pe Pdf.PageNumber, pentru utilizare headless. Cele două numere de pagină sunt independente, ceea ce este propria sa capcană.) Un rezultat gol pe o pagină care poartă vizibil conținut înseamnă o scanare doar cu imagine. Direcționați-o către OCR, sau cel puțin anunțați asta („pagina 4 nu conține text lizibil”), în loc să lăsați vocea să tacă fără nicio explicație
Conectarea limitelor de cuvinte SAPI la tracker
TrackReadingWordAt, de pe vizualizator, este balamaua întregii funcționalități. Dați-i un număr de pagină și un index de caracter; găsește dreptunghiul de cuvânt care conține acel caracter, desenează cursorul de citire pe el și returnează indexul cuvântului, sau −1 atunci când indexul cade între cuvinte. Notificarea de limită de cuvânt a SAPI furnizează exact poziția de caracter de care are nevoie:
procedure TReaderForm.OnSpeechWordBoundary(StreamPos: Integer);
var
  WordIdx: Integer;
begin
  // Mapează decalajul la un dreptunghi de cuvânt și mută evidențierea într-un singur apel
  WordIdx := PdfView.TrackReadingWordAt(FPageNo, StreamPos);
  if WordIdx < 0 then
    Exit;                     // limita a căzut în afara oricărui cuvânt: păstrează ultima evidențiere
end;
Două detalii defensive își justifică prezența aici. Primul, TrackReadingWordAt își păstrează propriul cache de dreptunghiuri de cuvinte pentru pagina urmărită, reconstruit automat când pagina se schimbă, așa că costul per limită rămâne constant, indiferent cât de repede sosesc limitele. Al doilea, nu verifică limitele generos. Un index egal sau dincolo de numărul de caractere al paginii returnează −1, în loc să se plafoneze la ultimul cuvânt. Tratați −1 drept „păstrează evidențierea anterioară”, niciodată ca pe o eroare, deoarece secvențele de punctuație și spațiile albe dintre cuvinte produc în mod legitim limite care nu aparțin niciunui cuvânt. Jurnalizarea fiecărui −1 vă va îngropa. Numărați-le per pagină în schimb, și examinați atent orice pagină unde raportul crește brusc, deoarece asta înseamnă de obicei o nepotrivire de normalizare a textului, revenind la regula unu
Cursorul în sine: culoare, urmărire și curățare
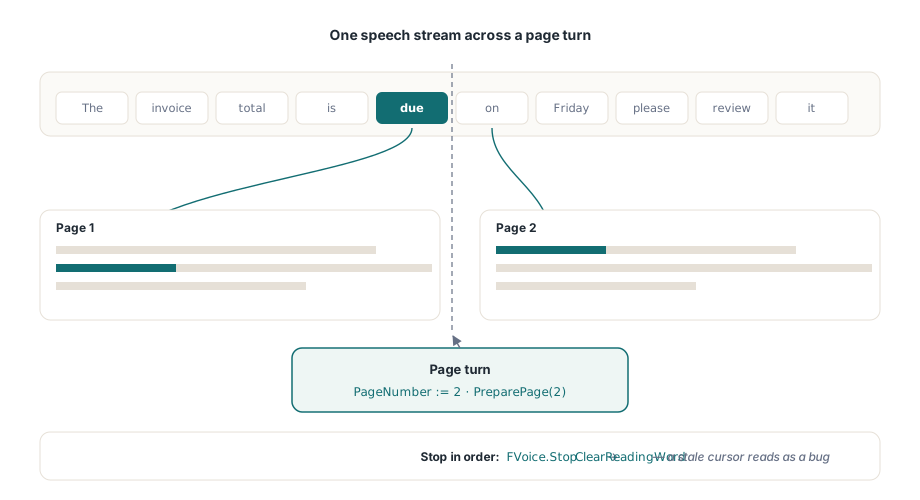
SetReadingWord desenează evidențierea direct atunci când dețineți dvs. înșivă dreptunghiul de cuvânt, ReadingWordColor îi stabilește stilul, iar ReadingWordFollow := True derulează vizualizarea exact atât cât este necesar pentru a păstra vizibil cuvântul rostit. Această ultimă proprietate își câștigă locul. O derulare de tip „centrează cuvântul curent” scrisă manual face pagina să salte la fiecare întrerupere de linie, iar cititorii sensibili la mișcare vor dezactiva întreaga funcționalitate în mai puțin de un minut. Evidențierea se randează doar pe pagina afișată în prezent în TPdfView-ul activ, așa că citirea pe mai multe pagini trebuie să avanseze PageNumber în pas cu vorbirea, apoi să rerulați pasul de pregătire pentru noua pagină înainte ca primul ei eveniment de limită să sosească. Omiteți asta, iar primele câteva evidențieri de pe fiecare pagină indică spre coordonate învechite
procedure TReaderForm.StopReading;
begin
  FVoice.Stop;                // opriți mai întâi redarea SAPI
  PdfView.ClearReadingWord;   // apoi eliminați evidențierea; un cursor învechit se citește ca o eroare
end;
Simetria la oprire este ceea ce menține evidențierea onestă. Fiecare cale de pauză, oprire și schimbare de pagină trebuie să se termine cu ClearReadingWord. Omiteți-o, iar un dreptunghi chihlimbariu rămâne pe o pagină oprită, arătând exact ca un defect, exact genul de lucru pe care orice tester îl va raporta, chiar dacă nimic nu este de fapt stricat
Viteza vorbirii solicită acest pipeline mai mult decât o face dimensiunea documentului. La 300 de cuvinte pe minut, evenimentele de limită sosesc la fiecare 200 ms, iar la cele mai rapide viteze SAPI vin mai repede decât poate urmări confortabil ochiul. Răspunsul corect este să contopiți, nu să puneți în coadă. Dacă sosește o nouă limită în timp ce o actualizare de evidențiere este încă în așteptare, renunțați la cea învechită și desenați-o pe cea mai recentă. Un cursor care vizitează fiecare cuvânt în ordine, dar întârzie o jumătate de secundă, pare stricat; unul care sare ocazional peste un cuvânt, rămânând totuși sincronizat cu vocea, nu pare
Cazuri-limită care despart demonstrațiile de produse
Câteva categorii de documente expun cusăturile. Caracterele combinate sunt cele mai subtile: secvențe Unicode precum o literă de bază plus un diacritic combinator pot ocupa mai mulți indici de caracter decât sugerează cuvântul vizual, așa că orice aritmetică de decalaj care presupune un index per glifă derivă lent. Acesta este cel mai puternic argument pentru a lăsa TrackReadingWordAt să dețină maparea, în loc să calculați numerele de cuvinte manual. Despărțirea în silabe este mai banală, dar mai comună: un cuvânt rupt de o întrerupere de linie devine două dreptunghiuri, iar dacă îl rostiți ca un singur token, evenimentul de limită pentru a doua sa jumătate se rezolvă la primul dreptunghi. De obicei este în regulă, dar este o decizie, așa că luați-o intenționat, în loc să o descoperiți. Etichetarea schimbă chiar ordinea de citire. Când un document poartă etichete de structură corespunzătoare (teritoriul ISO 14289, PDF/UA), secvențierea cuvintelor urmează structura logică; fără ele, revine la euristici de aspect, iar o pagină pe două coloane netichetată poate fi citită direct de-a lungul ambelor coloane. Paginile rotite sunt ultimul caz comun: Rect-ul fiecărui cuvânt încă îl încadrează corect în spațiul paginii, dar o politică de urmărire a viewport-ului calibrată pentru flux orizontal derulează smucit atunci când textul curge vertical, așa că păstrați cel puțin un document rotit în setul de regresie. Pentru gestionarea ordinii de citire, unități la nivel de propoziție prin ReadingUnits, și stiva mai largă de asistență, vedeți construirea unui cititor PDF accesibil în Delphi
O constrângere de platformă modelează desfășurarea. SAPI este exclusiv pentru Windows. API-ul de dreptunghiuri de cuvinte și urmărire este identic byte cu byte sub Lazarus și FPC, dar compilările pentru Linux și macOS au nevoie de un sintetizator diferit, cablat în spatele acelorași evenimente de limită; acea configurare este tratată în rularea vizualizatorului sub Lazarus și FPC. Costul evidențierii interacționează și cu cache-ul dvs. de pagini pe măsură ce viteza vorbirii crește, iar aritmetica bugetului din cache-ul de randare și performanța la zoom se transferă aici neschimbată
Când evidențierea cuvânt cu cuvânt este granularitatea greșită
Karaoke la nivel de cuvânt nu este întotdeauna ceea ce vrea un cititor. La viteze mari de vorbire, cursorul care pâlpâie cuvânt cu cuvânt devine propriul său zgomot vizual, iar unii ascultători urmăresc o propoziție mai confortabil decât un stroboscop de cuvinte individuale. Pentru acel caz, componenta expune o unitate mai grosieră. ReadingUnits returnează unități la nivel de propoziție și de bloc, fiecare cu propriile dreptunghiuri de evidențiere, iar dvs. le desenați cu SetReadingHighlight în loc de SetReadingWord. Cablarea are aceeași formă: un decalaj de limită tot conduce care unitate se aprinde, dar unitatea pe care o evidențiați acoperă o propoziție subordonată sau o linie, nu un singur token. Atât cititorii mai lenți, cât și redarea la viteză mare tind să o prefere, iar nimic nu vă oprește să oferiți ambele moduri în spatele unei setări
Meritați să fixați pragurile de versiune înainte de a construi pe baza acestora: dreptunghiurile de cuvinte necesită PDFium Component v1.53 sau ulterior, iar cursorul de urmărire necesită v1.56. API-ul complet de citire, unitățile la nivel de propoziție și o demonstrație funcțională de citire cu voce tare se află pe pagina de produs a PDFium Component