Un PDF care arată perfect pe mașina ta și se randează ca un șir de casete goale pe a altcuiva este cel mai frecvent defect de font din software-ul de documente și aproape niciodată nu înseamnă că textul e greșit. Caracterele sunt intacte, codificarea e în regulă, glifele pur și simplu lipsesc. Ce s-a schimbat între cele două mașini este ce fonturi avea instalate sistemul de operare, iar distanța dintre un fișier portabil și unul fragil stă într-o singură decizie luată când a fost scrisă pagina: dacă fontul a călătorit în interiorul PDF-ului sau a fost presupus prezent la celălalt capăt
Ca să înțelegi de ce se întâmplă asta și de ce un eșec separat produce text care pare căutabil, dar se copiază ca gunoi, trebuie să te uiți la felul în care PDF stochează textul. Nu stochează propoziții. Stochează coduri de glife, plus un program de font, plus tabele care le mapează unele pe altele, iar orice bug de randare sau de extracție trăiește într-un gol dintre aceste trei. Ce urmează este un tur al acestei mecanici, ancorat în ISO 32000, cu apelurile Delphi care o controlează acolo unde contează
Caracterele, codurile și glifele sunt trei lucruri diferite
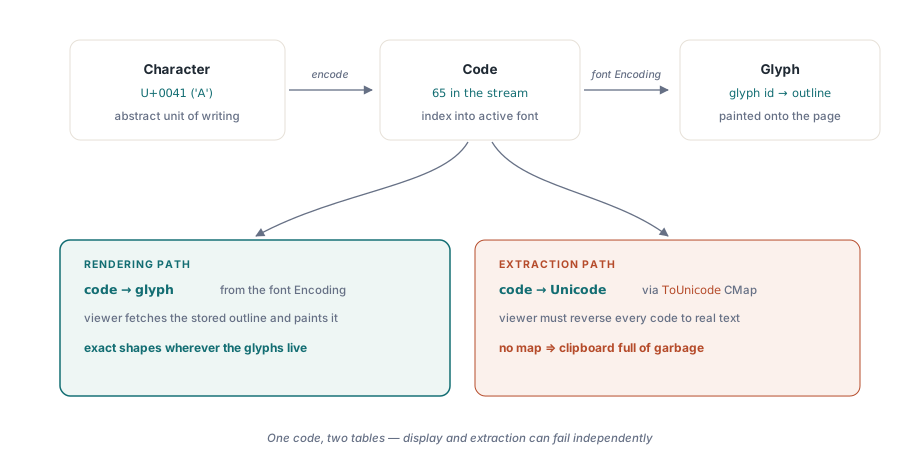
Vocabularul îi încurcă pe oameni pentru că vorbirea de zi cu zi turtește trei idei distincte în cuvântul "literă". Un caracter este o unitate abstractă de scriere, ideea de A majuscul, identificată în Unicode ca U+0041. O glifă este o formă desenată, conturul cu curbe și bare pe care un anumit font îl folosește ca să înfățișeze acel caracter. Între ele stă codul: octetul sau octeții din content stream care îi spun vizualizatorului ce glifă din fontul curent să deseneze
PDF lucrează în coduri. Când un content stream afișează un șir, octeții aceia sunt indici în fontul activ, nu Unicode. Encoding-ul fontului decide că un cod 65 înseamnă "desenează glifa îndosariată la 65", iar nimic din operația asta nu știe că rezultatul arată a A pentru un om. Asta e ce face PDF-ul să se randeze identic oriunde găsește glifele și tot asta e motivul pentru care extracția e o problemă separată de afișare: desenarea are nevoie doar de cod-spre-glifă, citirea are nevoie de cod-spre-Unicode, iar acestea sunt două tabele diferite, care pot să se contrazică sau să lipsească independent
Tipurile de font pe care le vei întâlni de fapt
ISO 32000 definește mai multe tipuri de dicționar de font, iar în practică un document pe care îl primești sau îl generezi folosește unul din trei. Știind la care te uiți, se explică mare parte din ce poate merge prost
Type 1 este formatul original de contur PostScript de la Adobe, construit din curbe Bezier cubice. Cele paisprezece fonturi standard pe care orice cititor conform trebuie să le ofere, familiile Helvetica, Times, Courier, Symbol și ZapfDingbats, sunt Type 1, iar un dicționar de font care numește unul dintre ele poate omite legal programul de font. Îsta e singurul caz în care lăsarea unui font neîncorporat e sigură prin specificație, nu prin noroc. Pentru orice altă față Type 1, programul trebuie încorporat, altfel vizualizatorul substituie ceva, de obicei un font similar metric, dar vizibil diferit
TrueType folosește curbe pătratice și vine din lumea Apple și Microsoft. Este ce sunt majoritatea fonturilor de sistem și ce vei încorpora cel mai des. Un font TrueType simplu în PDF e limitat la coduri pe un singur octet, deci un asemenea font poate adresa cel mult 256 de glife odată. Plafonul ăsta e motivul structural pentru care CJK și alte scrieri mari nu pot călători pe un font simplu
Type 0, fontul compozit sau CID-keyed, este răspunsul la acea limită. Folosește coduri pe mai mulți octeți și un CMap ca să le ruteze către un CIDFont descendent, ale cărui contururi sunt ele însele fie TrueType, fie CFF/Type 1. E singurul tip de font care poate purta mii de glife, deci orice PDF care conține chineză, japoneză, coreeană sau un amestec multilingv larg folosește Type 0, indiferent dacă autorul s-a gândit la asta sau nu. Schimbul se face pe complexitate: mai multe piese mobile, dintre care mai multe trebuie să fie corecte atât pentru randare, cât și pentru extracție
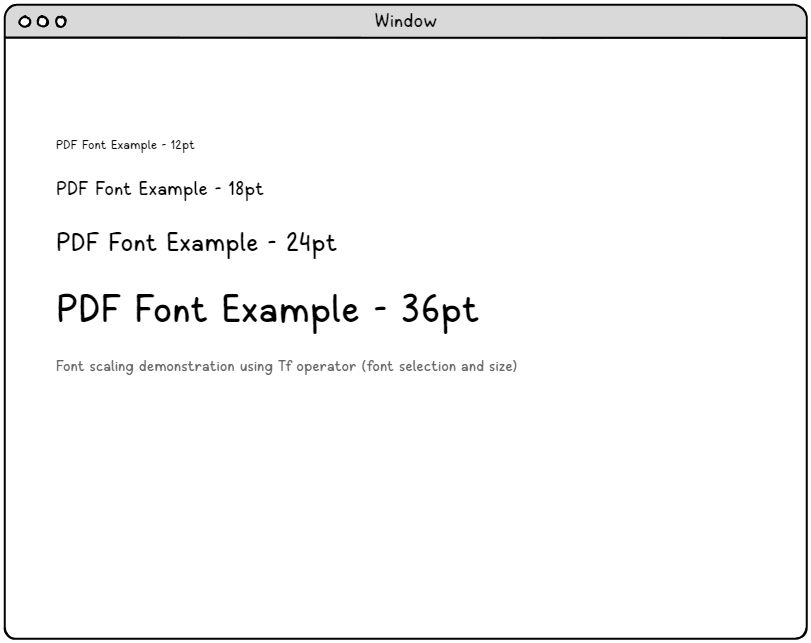
Un detaliu din spatele acelei imagini dictează dimensiunea fișierului. Un font este o bibliotecă de contururi, nu de bitmap-uri de dimensiune fixă, deci același program încorporat servește fiecare corp de literă de pe pagină. Scalarea e o transformare aplicată la desenare, motiv pentru care un titlu și textul lui de corp împart o singură față încorporată și pentru care costul încorporării e per font, nu per dimensiune
Încorporarea e diferența dintre portabil și fragil
Încorporarea înseamnă că programul de font, datele de contur propriu-zise, sunt scrise în PDF ca flux. Un cititor de pe o mașină care n-a auzit niciodată de fontul tău citește contururile acelea direct din fișier și desenează glife exacte. Sări peste încorporare și pariezi că destinația are un font cu același nume; când nu-l are, vizualizatorul cade pe un substitut. Pentru cele paisprezece standard, substituția e definită și benignă. Pentru tot restul, merge de la o ratare mică într-un alt caracter tipografic până la rezultatul cu casete goale, când niciun substitut nu acoperă scrierea
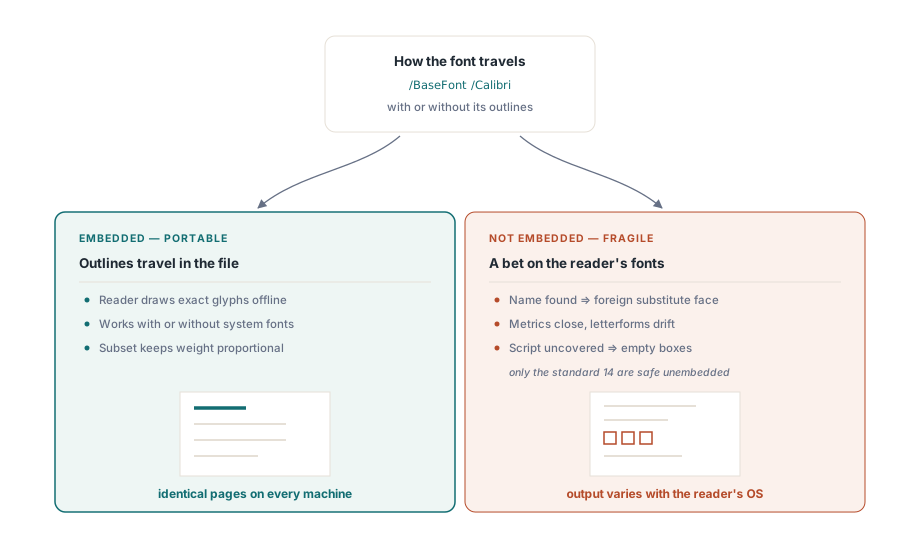
La HotPDF controlul este o singură proprietate, setată înainte ca documentul să se deschidă. FontEmbedding îi spune bibliotecii să împacheteze în fișier fețele cu care desenează:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'report.pdf';
    Pdf.Compression := cmFlateDecode;
    Pdf.FontEmbedding := True;          // contururile călătoresc în interiorul fișierului
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Calibri', [], 11);
    Pdf.CurrentPage.TextOut(72, 760, 0, 'This renders the same on a machine without Calibri.');
    Pdf.EndDoc;
  finally
    Pdf.Free;
  end;
end;
Ordinea nu e cosmetică. BeginDoc e locul în care HotPDF fixează structura documentului, deci FontEmbedding trebuie să fie true înainte de acel apel. Îl atribui după și nu primești nicio eroare, niciun avertisment, doar un fișier care a plecat tăcut fără fonturile lui. Ăsta e cel mai rău fel de bug: trece orice test pe mașina dezvoltatorului, unde fontul se întâmplă să fie instalat, și iese la suprafață abia la client, unde nu este
Încorporarea e și locul în care licențierea se întâlnește cu ingineria. Un program de font poartă flag-uri care descriu dacă poate fi încorporat liber, doar pentru previzualizare sau deloc. Respectarea acelor flag-uri e responsabilitatea ta, nu a motorului de randare, iar "a mers" nu e același lucru cu "a fost permis"
Subsetarea: încorporează doar glifele pe care le-ai folosit
Încorporarea completă scrie în fișier tot programul de font. O față TrueType CJK mare poate ajunge la câțiva megaocteți, iar încorporarea ei întreagă ca să arăți o duzină de caractere e o risipă care se cumulează de-a lungul unui document cu multe pagini. Subsetarea rezolvă asta scriind doar glifele la care documentul face referire, apoi redenumește fontul cu o etichetă de șase litere și un plus, forma ABCDEF+Calibri din listarea de fonturi a oricărui PDF subsetat, ca un cititor să nu confunde niciodată fața parțială cu un font de sistem întreg cu același nume
Pentru majoritatea documentelor generate, subsetarea e valoarea implicită corectă. Ține dimensiunea fișierului proporțională cu conținutul, nu cu fontul sursă, ceea ce contează mai ales pentru fonturile multilingve mari, care altfel ar domina fișierul. Singurul avertisment e că un subset conține doar ce s-a folosit la creare. Dacă un proces din aval încearcă mai târziu să adauge text într-un font subsetat, glifele de care are nevoie s-ar putea să nu fie în fișier, o constrângere reală la editarea incrementală a PDF-ului altcuiva
Fonturi Unicode și problema casetelor CJK
Când textul nu e latină simplă, calea fontului simplu se termină, iar soluția e să înregistrezi explicit un font capabil de Unicode și să lași HotPDF să construiască un font Type 0 din el. RegisterUnicodeTTF încarcă un fișier TrueType după cale; după aceea, numele înregistrat se poate folosi în SetFont ca oricare altul:
Pdf.FontEmbedding := True;
Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansCJKsc-Regular.ttf');
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('NotoSansCJKsc-Regular', [], 14);
Pdf.CurrentPage.TextOut(72, 720, 0, '你好,世界 こんにちは 안녕하세요');
Pdf.EndDoc;
Două lucruri decid dacă asta merge sau nu. Fontul trebuie să acopere scrierile din șir: un TrueType doar cu latină nu va crește glife chinezești pentru că i-ai cerut tu, iar rezultatul sunt iar casete goale, de data asta pentru că glifa chiar nu există în acea față. Și încorporarea trebuie să rămână pornită, pentru că un font Type 0 asamblat dintr-un TTF înregistrat nu înseamnă nimic pentru un cititor care nu găsește contururile. Pentru conținut mixt, alegerea durabilă e o față cu acoperire largă, familiile Noto și Arial Unicode MS fiind răspunsurile obișnuite, încorporată și subsetată
Scrierile de la dreapta la stânga și cele complexe adaugă un strat de shaping peste acoperire. HotPDF expune RtLTextOut pentru arabă și ebraică, care se ocupă de reordonarea direcțională, așa că tu dai ordinea logică și lași biblioteca să o așeze. Ca araba să iasă corect îi trebuie acoperire, plus shaping, plus direcție, trei lucruri separate, iar o casetă acolo poate însemna că a căzut oricare dintre ele
Tabela ToUnicode: acolo unde trăiește copy-paste
Tot ce e mai sus ține de desenare. Extracția e imaginea în oglindă și cade din motive proprii. Un vizualizator randează o pagină folosind maparea cod-spre-glifă a fontului, dar când un utilizator selectează textul și îl copiază, vizualizatorul trebuie să întoarcă aceleași coduri înapoi în Unicode. Maparea inversă e CMap-ul ToUnicode, un flux opțional atașat fontului
Când e prezent și corect, textul copiat iese ca acele caractere care trebuie. Când lipsește sau e greșit, sau când fontul a fost subsetat cu coduri de glifă proprii și nu s-a scris niciun ToUnicode, pagina arată perfect, iar clipboard-ul se umple de gunoi: coduri de glifă citite ca și cum ar fi Unicode, ceea ce pentru un subset codificat propriu nu sunt. De asta un document scanat cu un strat de text OCR poate fi căutabil, în timp ce un PDF născut digital, dintr-un generator neglijent, nu e. Randarea și extracția se sprijină pe tabele diferite, deci un fișier poate să satisfacă una și să cadă la cealaltă. Dacă extracția contează pentru rezultatul tău, tratează o mapă ToUnicode corectă ca pe o cerință și verific-o copiind text dintr-un eșantion, nu presupunând că e acolo
Cum diagnostichezi rapid un bug de font
Modul de eșec îți spune unde să te uiți. Casetele goale pe altă mașină înseamnă aproape mereu un font neîncorporat, deci verifică întâi încorporarea și abia apoi acoperirea de glife. Casetele care apar chiar și pe mașina ta arată spre acoperire: fontul nu conține acea scriere, indiferent de încorporare. Textul care se randează corect, dar se copiază ca aiureală, e o problemă de ToUnicode, nu una de randare, iar umblatul la fonturi sau la încorporare nu o va rezolva, pentru că desenarea n-a fost niciodată stricată. Ca să citești un fișier gata făcut, deschide-l în Acrobat și uită-te la Document Properties, Fonts: o intrare sănătoasă arată tipul, spune Embedded sau Embedded Subset și numește encoding-ul. Un font care ar trebui încorporat și nu e se anunță acolo înainte s-o facă un client
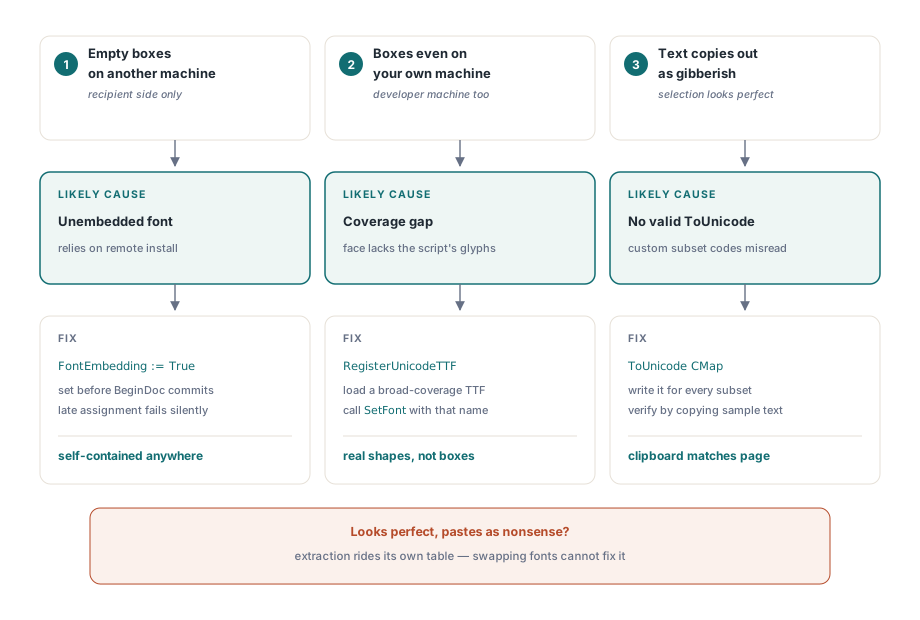
Nimic din toate astea nu e exotic odată ce e clară despărțirea dintre caracter, cod și glifă. Încorporează fonturile cu care desenezi, subsetează-le pe cele mari, treci la o față Unicode și la RegisterUnicodeTTF în clipa în care textul iese din latină și ține o mapă ToUnicode corectă dacă cineva va extrage textul. Fă-le corect și casetele încetează să mai apară. Pentru mecanica din jur, anatomia unui PDF minimal arată unde stă dicționarul de font în arborele de obiecte, iar parcursul structurii documentului acoperă felul în care resursele sunt partajate între pagini
Apelurile SetFont, FontEmbedding și RegisterUnicodeTTF arătate aici fac parte din HotPDF Delphi Component pentru Delphi și C++Builder