Puneți un raport scanat de 80 MB în spatele unui link, deschideți-l într-un browser și priviți ce se întâmplă: vizualizatorul stă pe un panou gol până când o bună parte din acei octeți au sosit, apoi desenează prima pagină dintr-o dată. Săriți la pagina 40 și, într-un fișier prost construit, întreaga descărcare poate să o ia de la capăt. Partea frustrantă este că cititorul nu a vrut niciodată decât prima pagină. Linearizarea este răspunsul structural la această problemă. Ea rearanjează un PDF astfel încât un vizualizator să poată randa pagina de început dintr-un prefix mic al fișierului și să aducă restul la cerere, motiv pentru care Adobe promovează funcția sub numele „Fast Web View”
Nimic din toate acestea nu este un format de fișier diferit. Un PDF linearizat este un PDF obișnuit pe care un cititor conform îl va deschide fără nicio tratare specială. Trucul stă în întregime în modul în care sunt ordonați octeții și în două structuri suplimentare pe care le poartă fișierul. ISO 32000-1 specifică întregul aranjament în Anexa F, iar odată ce ați văzut dispunerea, comportamentul încetează să pară magie și începe să arate ca un schimb deliberat între ordinea din fișier și latența primei afișări
Ce rearanjează de fapt linearizarea
Un PDF obișnuit își poate împrăștia obiectele aproape în orice ordine. Tabelul de referințe încrucișate de la finalul fișierului este cel care face acest lucru posibil: un cititor se poziționează la final, citește pointerul startxref, încarcă xref-ul și de acolo poate localiza fiecare obiect după offsetul său. Designul acesta este excelent pentru fișierele locale, unde poziționarea la final nu costă nimic, și slab pentru un fișier care sosește în flux prin rețea, unde finalul este exact partea care ajunge ultima. Pentru a randa prima pagină, un cititor convențional are nevoie de obiectul paginii, de fluxul ei de conținut, de fonturile la care face referire și de orice imagine pe care o desenează, iar într-un fișier neordonat acestea pot sta oriunde, inclusiv în ultimul megaoctet
Linearizarea corectează ordinea. Obiectele necesare afișării primei pagini sunt adunate într-un bloc continuu aproape de început, imediat după o secțiune mică de antet, astfel încât să sosească devreme în fluxul de octeți. Tot restul, paginile rămase și resursele pe care le împart, urmează într-o secvență previzibilă. Un al doilea tabel complet de referințe încrucișate rămâne totuși la final pentru cititorii care ignoră optimizarea, dar un fișier linearizat plasează în față și un tabel de referințe pentru prima pagină, împreună cu parametrii de care are nevoie un cititor care lucrează în flux. Cititorul nu mai trebuie să ajungă la coada fișierului înainte de a putea desena ceva
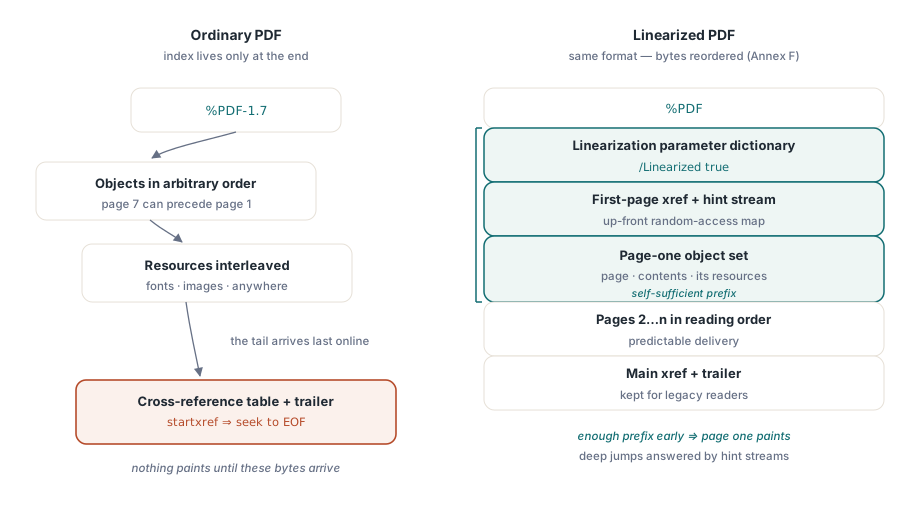
Setul de obiecte al primei pagini și dicționarul de parametri de linearizare
Chiar primul obiect dintr-un fișier linearizat, după antetul %PDF, este dicționarul de parametri de linearizare. El este ceea ce caută un cititor care lucrează în flux pentru a decide dacă optimizarea este prezentă și cum să o folosească. Dicționarul consemnează lungimea întregului fișier, offsetul în octeți la care începe secțiunea principală de referințe încrucișate, numărul de obiect al primei pagini și poziția și lungimea fluxului hint care urmează. Cu aceste numere, un cititor știe, doar din primii kiloocteți, cât trebuie să aducă pentru a afișa prima pagină și unde să caute indexul care îi permite să sară în altă parte
Anexa F este strictă în privința a ce înseamnă aici „prima pagină”. Secțiunea primei pagini trebuie să conțină obiectul paginii însuși, fluxurile ei de conținut și resursele la care fac referire acele fluxuri, astfel încât pagina să fie autosuficientă odată ce acel prefix s-a descărcat. Resursele partajate, un font folosit pe fiecare pagină, un logo care se repetă într-un antet, sunt tratate special: apar suficient de devreme pentru a servi prima pagină, dar sunt marcate ca partajate, astfel încât cititorul să nu le aducă din nou atunci când randează mai târziu pagina 30. Această distincție dintre obiectele private ale unei pagini și cele partajate este partea pe care majoritatea „optimizatoarelor” făcute în casă o greșesc, iar greșeala produce un fișier care pretinde că este linearizat, dar tot se blochează
Fluxurile hint: indexul care ieftinește saltul între pagini
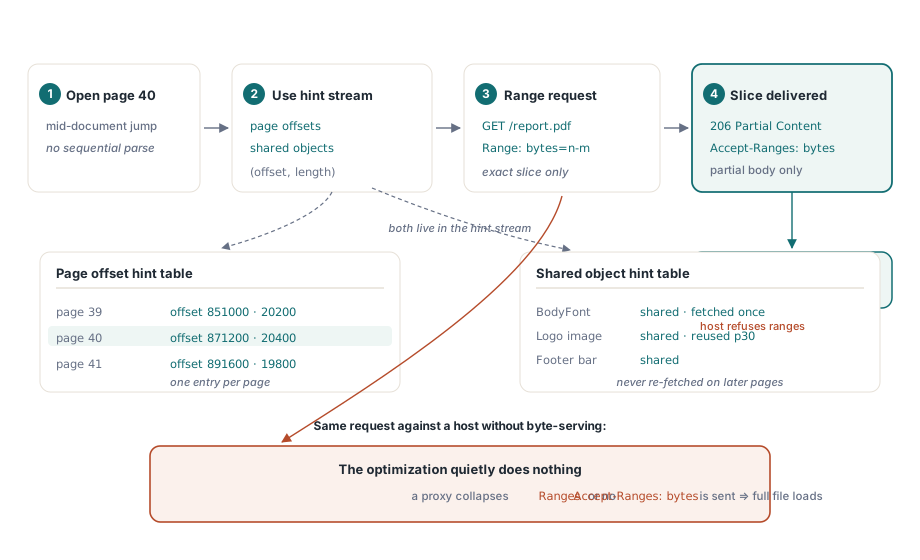
Afișarea rapidă a primei pagini este doar jumătate din valoare. Cealaltă jumătate este saltul la o pagină arbitrară fără descărcarea a tot ce se află între ele, iar asta oferă fluxurile hint. Un fișier linearizat poartă un tabel hint cu offseturile paginilor și un tabel hint pentru obiectele partajate, stocate ca flux referit din dicționarul de parametri. Tabelul de offseturi consemnează, pentru fiecare pagină, unde încep obiectele ei în fișier și cât se întind. Tabelul obiectelor partajate face același lucru pentru resursele folosite pe mai multe pagini
Având aceste tabele, un cititor care vrea pagina 40 nu parcurge fișierul secvențial. Consultă tabelul hint pentru a afla intervalul de octeți pe care îl ocupă pagina 40, cere serverului exact acel interval și randează pagina odată ce octeții au sosit, aducând prin același mecanism orice resursă partajată pe care nu o deține deja. Fluxul hint este, practic, o hartă de acces aleatoriu așezată peste document, și este motivul pentru care un fișier de 500 de pagini bine linearizat pare prompt pe o legătură lentă, în timp ce unul neoptimizat de aceeași dimensiune nu pare
De ce trebuie să coopereze și serverul
Linearizarea presupune că transportul poate livra felii arbitrare din fișier, iar această presupunere merită verificată înainte de a pune rezultatele slabe pe seama formatului. Mecanismul este livrarea pe intervale de octeți prin HTTP: cititorul emite cereri de interval, iar serverul răspunde cu răspunsuri 206 Partial Content. Dacă serverul nu anunță Accept-Ranges: bytes sau dacă un proxy ori un CDN aflat în fața lui transformă cererile de interval în transferuri complete, cititorul nu are cum să aducă pagina 40 izolat și revine la descărcarea întregului fișier. Structura din interiorul PDF-ului este atunci perfect corectă și complet irosită
Aceasta este defecțiunea diagnosticată cel mai adesea greșit drept „linearizarea nu funcționează”. Fișierul este în regulă; calea de livrare nu este. Înainte de a reconstrui un document, confirmați printr-o cerere condiționată că gazda chiar returnează conținut parțial pentru URL-ul pe care îl accesează cititorul. Multe gazde statice fac asta implicit, iar multe servere de aplicații și straturi de cache configurate greșit nu o fac
Actualizările incrementale strică linearizarea pe tăcute
Iată constrângerea care îi surprinde pe cei care generează corect fișiere linearizate și apoi se întreabă de ce se evaporă optimizarea. Linearizarea depinde de o singură dispunere ordonată cu grijă, cu indexul în față. O actualizare incrementală încalcă asta prin însăși natura ei. Când un instrument adaugă o semnătură, completează un câmp de formular sau atașează o adnotare printr-o salvare incrementală, el nu rescrie fișierul. Adaugă la final obiectele modificate, o nouă secțiune de referințe încrucișate și un nou trailer, lăsând octeții originali neatinși. Această adăugare este chiar rostul actualizărilor incrementale: este rapidă și păstrează revizia anterioară pentru audit sau pentru validarea semnăturii
Efectul secundar este că fișierul are acum cele mai noi date de referințe încrucișate la coadă, după blocul primei pagini așezat cu grijă, iar dicționarul de parametri de linearizare din față descrie o dispunere care nu mai corespunde fișierului. Un cititor conform detectează nepotrivirea și tratează documentul ca pe un PDF normal, nelinearizat. Fast Web View a dispărut, chiar dacă structura linearizată originală stă în continuare acolo, în prima jumătate a fișierului. Dacă adăugați mai multe actualizări, fiecare stivuiește încă o revizie la final, iar decalajul dintre indexul învechit din față și starea reală se lărgește
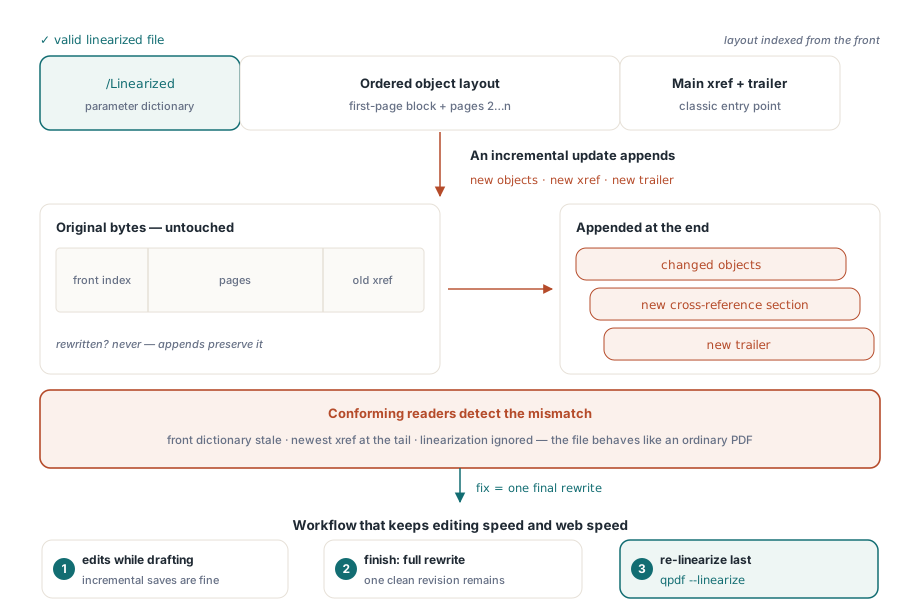
Dacă fluxul dumneavoastră de lucru are nevoie și de editări, și de Fast Web View, regula decurge direct din structură: editați incremental cât timp documentul este în schimbare, apoi relinearizați o singură dată la final. O rescriere completă este cea care restaurează dispunerea. În termeni HotPDF, asta înseamnă că o editare în curs trece prin BeginIncrementalUpdate și SaveIncrementalUpdate, care adaugă un delta, în timp ce pasul de încheiere încarcă întregul document și îl serializează din nou cu LoadFromFile urmat de SaveLoadedDocument, ceea ce elimină reviziile vechi acumulate și emite o singură dispunere curată. Același compromis apare și la fluxurile de obiecte: activarea UseObjectStreams împreună cu UseXRefStream comprimă referințele încrucișate și împachetează obiectele strâns, ceea ce ajută la dimensiunea fișierului, dar, ca orice alegere structurală, trebuie aplicată în timpul acelei rescrieri finale, nu lipită peste o revizie adăugată
// Editări în curs: adaugă un delta, păstrează intacte reviziile anterioare.
// Astfel fișierul NU rămâne linearizat.
Pdf.BeginIncrementalUpdate('report.pdf');
Pdf.AddPage;
Pdf.CurrentPage.TextOut(72, 760, 0, 'Addendum');
Pdf.SaveIncrementalUpdate('report.pdf');

// Pasul de încheiere: reserializarea completă produce o singură dispunere curată,
// eliminând reviziile stivuite. Rulați din nou linearizatorul pe rezultat.
Pdf.LoadFromFile('report.pdf');
Pdf.SaveLoadedDocument('report-final.pdf');
HotPDF nu expune o rutină de „linearizare” într-un singur apel, așa că modelul practic este să produceți un fișier curat, rescris complet, și să rulați peste el un optimizator dedicat. Instrumentele din linia de comandă se ocupă direct de rearanjare. qpdf rescrie un fișier în formă linearizată cu un singur parametru:
qpdf --linearize report-final.pdf report-web.pdfCum vă dați seama dacă un fișier este linearizat
Nu vă încredeți în numele fișierului sau în instrumentul care pretinde că l-a produs; verificați octeții. Cea mai directă verificare este începutul fișierului: deschideți-l și căutați dicționarul de parametri de linearizare ca prim obiect după antet, purtând cheia /Linearized. O scurtătură dinspre cititor este caseta Document Properties din Acrobat, care raportează „Fast Web View: Yes” doar atunci când structura este cu adevărat prezentă și actuală
Pentru verificări automate, qpdf raportează atât prezența, cât și integritatea structurii, ceea ce contează pentru că un fișier poate purta un dicționar de linearizare care nu îi mai reflectă dispunerea, exact starea lăsată în urmă de o actualizare incrementală:
# Raportează "File is linearized" și validează tabelele de indicii față de aspect
qpdf --check report-web.pdf

# Afișează detaliat parametrii de liniarizare și datele de indicii
qpdf --show-linearization report-web.pdf
Pasul de validare este cel care își merită efortul. O trecere care confirmă doar că dicționarul există va binecuvânta bucuroasă un fișier al cărui index arată spre offseturi greșite; o verificare care reconciliază tabelele hint cu pozițiile reale ale obiectelor este cea care vă spune că optimizarea va rezista la cererile de interval ale unui cititor real
Linearizarea rămâne utilă pentru orice document mare servit pe web, mai ales pentru cititorii mobili aflați pe conexiuni inegale, și costă câteva procente din dimensiunea fișierului pentru indexul mutat în față. Cele două lucruri de ținut minte sunt că atât structura din interiorul PDF-ului, cât și livrarea pe intervale din exteriorul lui trebuie să fie corecte, și că orice editare ulterioară anulează optimizarea până când rescrieți fișierul. Tratați relinearizarea ca pe ultimul pas din flux, după ce orice altă modificare s-a așezat. Comportamentul referințelor încrucișate, al fluxurilor de obiecte și al actualizărilor incrementale descris aici face parte din modelul structural pe care îl implementează HotPDF Delphi Component pentru Delphi și C++Builder; pentru contextul mai larg al dispunerii fișierului vedeți cum este structurat un PDF, iar pentru fluxul de actualizare incrementală și de fișiere mari în cod vedeți procesarea PDF-urilor mari din Delphi