Îndepărtați descrierile de pagină și vă rămâne un strat subțire de structură pe care nimeni nu îl tipărește, dar de care depind orice cititor, indexator și sistem de arhivare. Un obiect de pagină nu știe nimic despre capitolul căruia îi aparține, despre autorul care l-a scris sau despre nota de subsol care duce în altă parte. Acea cunoaștere trăiește cu un nivel mai sus, în trei structuri atașate catalogului documentului: fluxurile de metadate, arborele de cuprins și tablourile de adnotări per pagină. Ele împart o trăsătură care le face ușor de greșit. Niciuna nu poartă semne vizibile pe pagină, deci un fișier se poate randa impecabil și totuși să îi lipsească marcajele, să își contrazică propriul câmp de autor sau să îndrepte o legătură spre un obiect de pagină care nu mai există
Acesta este stratul pe care o bibliotecă PDF îl expune ca proprietăți de document, API-uri de marcaje și apeluri de legături sau adnotări, și stratul pe care îl citește un crawler de căutare ca să decidă despre ce este documentul dumneavoastră. Modelul de obiecte de dedesubt este tratat în parcursul structurii documentului PDF. Aici accentul cade strict pe ce atârnă de catalog
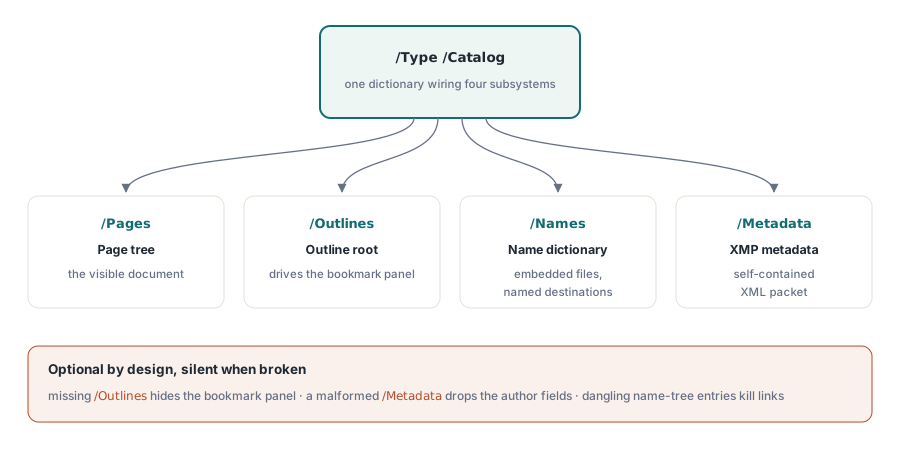
Toate cele trei structuri se atașează la catalog. Un catalog complet, care le leagă între ele, arată astfel:
1 0 obj
<< /Type /Catalog
   /Pages 2 0 R
   /Outlines 3 0 R
   /Names << /EmbeddedFiles 4 0 R >>
   /Metadata 5 0 R
>>
endobj
Patru intrări, patru subsisteme independente. /Pages este documentul vizibil; /Outlines este arborele de marcaje; /Metadata indică spre fluxul XMP; /Names ajunge la dicționarul de nume la nivel de document, care, printre altele, ține atașamentele de fișiere încorporate. Fiecare este opțional, iar un cititor care nu găsește niciunul dintre ele tot afișează paginile. Acea opționalitate este exact motivul pentru care stratul de navigare este primul care putrezește când un fișier este editat de unelte care înțeleg doar paginile
Două depozite de metadate care nu se înțeleg
PDF poartă metadatele documentului în două locuri deodată, iar necazul începe când spun lucruri diferite. Mecanismul original este dicționarul de informații despre document, referit prin /Info în trailer: un set plat de perechi cheie-valoare pentru /Title, /Author, /Subject, /Keywords, /Creator, /Producer și cele două date. Este simplu și îl citește orice vizualizator. PDF 2.0 îl declară în mare parte învechit în favoarea celui de-al doilea mecanism, fluxul de metadate XMP
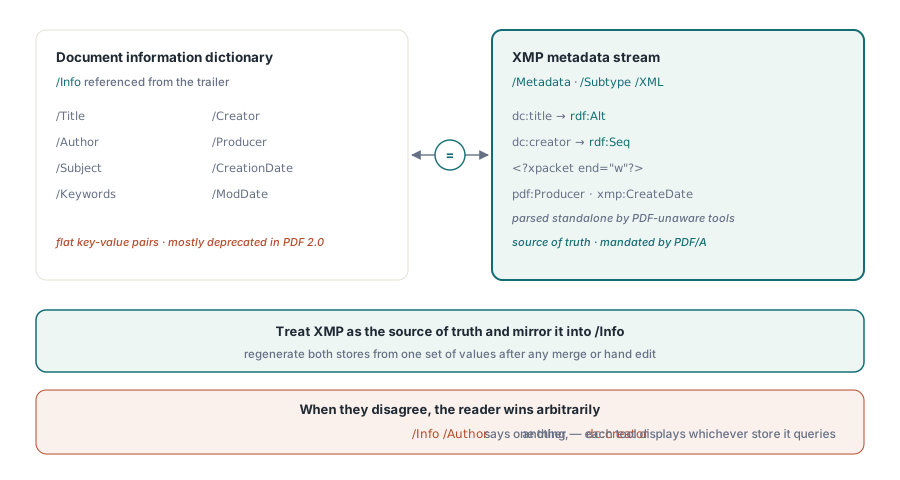
XMP este un document XML de sine stătător, scris în RDF, stocat ca flux la care catalogul ajunge prin /Metadata și marcat cu /Type /Metadata /Subtype /XML. Spre deosebire de dicționarul Info, îngropat în structura de obiecte a PDF-ului, un pachet XMP este proiectat să fie extras și analizat pe cont propriu de unelte care nu știu nimic despre PDF. Iată un pachet reprezentativ:
5 0 obj
<< /Type /Metadata /Subtype /XML /Length 1235 >>
stream
<?xpacket begin="" id="W5M0MpCehiHzreSzNTczkc9d"?>
<x:xmpmeta xmlns:x="adobe:ns:meta/">
  <rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#">
    <rdf:Description rdf:about=""
        xmlns:dc="http://purl.org/dc/elements/1.1/"
        xmlns:xmp="http://ns.adobe.com/xap/1.0/"
        xmlns:pdf="http://ns.adobe.com/pdf/1.3/">
      <dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report</rdf:li></rdf:Alt></dc:title>
      <dc:creator><rdf:Seq><rdf:li>A. Author</rdf:li></rdf:Seq></dc:creator>
      <xmp:CreateDate>2026-06-16T10:46:27+08:00</xmp:CreateDate>
      <xmp:CreatorTool>Reporting Service 4.2</xmp:CreatorTool>
      <pdf:Producer>losLab PDF Library</pdf:Producer>
    </rdf:Description>
  </rdf:RDF>
</x:xmpmeta>
<?xpacket end="w"?>
endstream
endobj
Trei detalii din acel bloc decid dacă metadatele supraviețuiesc contactului cu uneltele reale. Instrucțiunile de prelucrare xpacket nu sunt decorative: ele încadrează pachetul, ca un extractor să îl poată găsi într-un flux de octeți mai mare, iar un scriitor care omite închiderea <?xpacket end="w"?> produce un fișier care se deschide fără probleme, dar pică la validatoarele stricte. Și tipurile de date ale proprietăților contează. dc:title este o alternativă lingvistică învelită în rdf:Alt, în timp ce dc:creator este o listă ordonată și primește rdf:Seq; emiterea oricăreia dintre ele ca simplu nod de text este cea mai frecventă greșeală XMP, tolerată de majoritatea vizualizatoarelor exact până la acela care nu o tolerează. Prefixele de spații de nume sunt convenționale, dar URI-urile la care se leagă sunt normative: un analizor se orientează după URI, nu după prefix
Regula dură când există două depozite este că ele trebuie să fie de acord. Dacă /Info spune că autorul este o persoană, iar dc:creator numește alta, ați livrat un document care răspunde la aceeași întrebare în două feluri, iar răspunsul care câștigă depinde de câmpul pe care îl citește unealta consumatoare. O bibliotecă le scrie de obicei pe amândouă pentru dumneavoastră, dar în clipa în care editați una manual sau îmbinați fișiere de la generatoare diferite, cele două se despart. Tratați dicționarul Info drept compatibilitate cu trecutul și XMP drept sursă de adevăr și regenerați-le pe amândouă dintr-un singur set de valori, în loc să le peticiți independent. Pentru PDF/A asta devine o cerință de conformitate: ISO 19005 impune XMP și interzice orice proprietate Info care își contrazice corespondentul din XMP
Arborele de cuprins din spatele panoului de marcaje
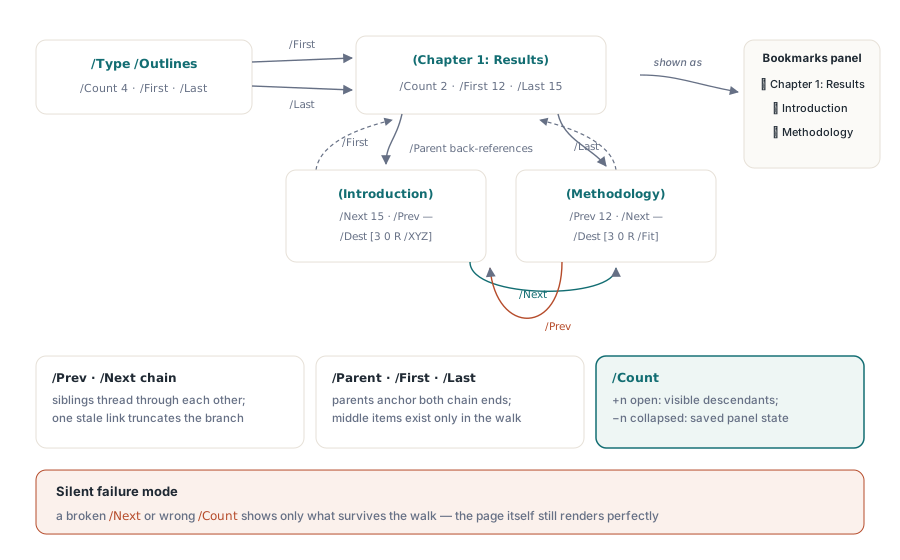
Ce arată un vizualizator ca panou de marcaje este, în fișier, un arbore dublu înlănțuit de dicționare numit cuprinsul documentului. Catalogul indică spre un dicționar rădăcină de cuprins prin /Outlines; rădăcina indică spre primul și ultimul ei element de nivel superior; iar fiecare element este înlănțuit de vecinii și de părintele lui. Nu există niciun tablou de marcaje nicăieri. Întreaga structură este reconstruită urmând referințe, exact motivul pentru care o singură legătură ruptă poate face ca o ramură întreagă să dispară din panou fără nicio eroare
8 0 obj                                    % rădăcina cuprinsului
<< /Type /Outlines /Count 4 /First 9 0 R /Last 9 0 R >>
endobj
9 0 obj                                    % nivel superior: un capitol
<< /Title (Chapter 1: Results)
   /Parent 8 0 R /Count 2
   /First 12 0 R /Last 15 0 R >>
endobj
12 0 obj                                   % primul copil
<< /Title (Introduction)
   /Parent 9 0 R /Next 15 0 R
   /Dest [3 0 R /XYZ 72 720 0] >>
endobj
15 0 obj                                   % al doilea copil, ultimul frate
<< /Title (Methodology)
   /Parent 9 0 R /Prev 12 0 R
   /Dest [3 0 R /Fit] >>
endobj
Citiți legăturile și invarianții devin evidenți. Fiecare element indică înapoi spre /Parent. Frații formează un lanț prin /Prev și /Next, primul element omițând /Prev, iar ultimul omițând /Next. Un părinte își numește primul și ultimul copil prin /First și /Last, iar copiii dintre ei sunt accesibili doar parcurgând lanțul de frați. Greșiți unul și eșecul este silențios: un /Next învechit trunchiază un capitol, un părinte al cărui /Last nu încheie lanțul lasă elemente orfane, iar vizualizatorul randează ce poate atinge
Câmpul /Count poartă o bucată de stare care surprinde lumea. Pe rădăcină și pe orice element expandat el ține numărul de descendenți vizibili în acel moment; pe un element restrâns este un număr negativ a cărui mărime spune câți descendenți ar apărea la expandare. Deci /Count nu este un fapt structural fix despre arbore, ci starea salvată de deschis sau închis a panoului, iar un generator care îl scrie fix ca total pozitiv redeschide fiecare ramură pe care autorul a vrut să o lase închisă
Fiecare element își câștigă locul indicând undeva. /Title este ce afișează panoul; /Dest este locul unde aterizează un clic. O destinație poate fi în linie, în element, ca mai sus, sau un nume care se rezolvă prin dicționarul de nume al documentului, alegerea mai bună atunci când multe marcaje și legături țintesc aceleași locuri, pentru că reparați o țintă mutată într-un singur loc. O bibliotecă ascunde în general acest arbore în spatele unui identificator de rădăcină de cuprins și al unor metode care adaugă intrări-copil; în HotPDF, documentul expune un OutlineRoot de tip THPDFDocOutlineObject și înlănțuie pentru dumneavoastră legăturile /Prev, /Next, /Parent și /Count pe măsură ce adăugați elemente. Merită profitat de asta, pentru că întreținerea manuală a acelor invarianți de-a lungul editărilor este exact locul în care se rup cuprinsurile
Destinații: gramatica locului unde duce un clic
Atât marcajele, cât și adnotările de tip legătură indică spre destinații, iar o destinație este mai mult decât un număr de pagină. Este un tablou care numește un obiect de pagină și apoi specifică, printr-un verb pus în al doilea loc, cum ar trebui vizualizatorul să o încadreze. Cea mai frecventă și cea mai abuzată este /XYZ, de forma [page /XYZ left top zoom]. Cei trei operanzi ai ei sunt independenți, iar oricare poate fi null, cu sensul „lasă asta cum o avea cititorul”. Deci [page /XYZ null null null] sare la pagină fără să atingă poziția de derulare sau zoomul, de obicei exact ce vreți de la o legătură de tip „mergi la pagina”. Numerele sunt în spațiul utilizator implicit, măsurate din stânga jos, cu y crescând în sus, același sistem de coordonate pe care îl folosește conținutul paginii. Autorii veniți din aranjarea pentru ecran măsoară reflex de sus și trimit cititorul la capătul greșit al paginii
Familia /Fit schimbă poziționarea precisă pe robustețe. [page /Fit] scalează întreaga pagină în fereastră, [page /FitH top] încadrează lățimea paginii cu o margine de sus dată, iar [page /FitR l b r t] mărește un dreptunghi ca să umple câmpul vizual. Fiindcă acestea calculează scara din geometria paginii, nu din coordonate fixe, o destinație /Fit tot face lucrul rezonabil după redimensionarea paginii, în timp ce o destinație /XYZ cu un zoom fixat în cod poate lăsa cititorul holbându-se la margine. Pentru un cuprins, /FitH cu coordonata de sus a secțiunii îmbătrânește mai bine decât /XYZ cu un zoom ghicit
Adnotări: tot ce este interactiv și nu este conținut de pagină
O adnotare este un obiect care se suprapune peste pagină fără să facă parte din fluxul ei de conținut. Legături, notițe adezive, evidențieri, controale de formular, pictograme de fișiere atașate, ștampile: toate sunt adnotări, listate în tabloul /Annots al paginii pe care stau. Eliminarea unei adnotări din acel tablou o elimină din pagină, chiar dacă nu s-a atins conținutul de dedesubt. Exact acesta este rostul: adnotările sunt un strat de editare, separat de semnele peste care stau
Fiecare adnotare împarte o coloană vertebrală mică. /Subtype numește felul, /Rect dă caseta ei de încadrare în coordonatele paginii, iar /Contents ține text care ține loc și de descriere accesibilă. Adnotarea de tip legătură este cazul care merită studiat, pentru că vine în două forme: o destinație simplă și o acțiune
12 0 obj                                    % legătură către o destinație
<< /Type /Annot /Subtype /Link
   /Rect [100 200 300 250]
   /Border [0 0 0]
   /Dest [5 0 R /XYZ null null null] >>
endobj
13 0 obj                                    % legătură care rulează o acțiune
<< /Type /Annot /Subtype /Link
   /Rect [50 50 200 100]
   /Border [0 0 0]
   /A << /Type /Action /S /URI /URI (https://www.example.com) >> >>
endobj
/Rect este o zonă activă; clicul în interiorul ei trimite cititorul la destinație, refolosind aceeași gramatică pe care o folosește cuprinsul. /Border [0 0 0] face muncă reală, suprimând dreptunghiul implicit urât pe care vizualizatoarele îl desenează în jurul legăturilor. A doua formă schimbă /Dest-ul simplu cu o acțiune /A, al cărei subtip /S alege comportamentul: /GoTo în interiorul acestui fișier, /GoToR pentru alt fișier, /URI pentru o adresă web, /Launch pentru a rula un program extern. Ultima merită suspiciune. Un /Launch care pornește un executabil este comportamentul care face din PDF-uri un vector de malware, deci vizualizatoarele conforme îl blochează sau întreabă zgomotos, iar legătura eșuează pentru majoritatea cititorilor. Apelați la /URI și /GoTo și lăsați /Launch în pace
Adnotările de marcare, precum evidențierile și notițele adezive, și adnotările de formă, precum /Square, adaugă o complicație: aspectul lor pe ecran nu este implicat de tipul lor. Un vizualizator randează propria lui versiune dacă nu fixați aspectul cu un flux de aspect, intrarea /AP, care referă un XObject de tip formular ce ține operatorii de desenare. Săriți peste el și aceeași evidențiere poate arăta diferit în două cititoare sau înainte și după un dus-întors printr-un editor. Pentru orice al cărui aspect exact face parte din document, furnizați /AP. Fișierele atașate, de altfel, refolosesc aceeași mașinărie: un flux de fișier încorporat și un dicționar de specificație de fișier, expuse fie ca adnotare /FileAttachment, fie prin arborele de nume /EmbeddedFiles de sub /Names al catalogului
Unde se rupe acest strat și cum îl prindeți
Eșecul recurent în toate acestea este referința suspendată. Marcajele încetează să apară când catalogul nu are intrarea /Outlines sau când un lanț de frați se rupe la mijlocul arborelui; metadatele sunt ignorate când fluxului XMP îi lipsește marcajul /Type /Metadata /Subtype /XML sau când învelișul xpacket este malformat. În toate cazurile conținutul paginii este în regulă, deci o deschidere superficială pare corectă, iar defectul iese la iveală doar în panoul pe care nu l-a verificat nimeni
Două obiceiuri ieftine prind aproape tot. Deschideți fișierul terminat într-un vizualizator real și parcurgeți cu clicuri panoul de marcaje și un eșantion de legături, ceea ce solicită graful de referințe așa cum o va face un cititor. Apoi citiți înapoi metadatele cu o unealtă separată și confirmați că dicționarul Info și XMP sunt de acord, singurul dezacord pe care niciun clic nu îl dezvăluie. Generați acest strat printr-o bibliotecă ce își asumă evidența legăturilor și majoritatea acestor capcane nu se deschid niciodată. HotPDF Delphi Component pentru Delphi și C++Builder expune structurile de cuprins, adnotări și metadate prin API-uri la nivel de document, deci descrieți ierarhia de marcaje și legăturile și îl lăsați pe el să înlănțuie referințele. Pentru modelul de obiecte de care se atașează aceste structuri, privirea de ansamblu tehnică asupra structurii fișierului PDF acoperă catalogul și tabelul de referințe încrucișate de care depind