Două minute pentru a copia trei pagini dintr-un PDF de 40 de pagini nu este o problemă de reglare a performanței. Este un semnal că se folosește calea greșită de API. Când am văzut prima dată acest timp pe un exemplu de copiere de pagini cu HotPDF Delphi Component, instinctul meu a fost să mă uit întâi la structura documentului și abia apoi la cod. Acea ordine s-a dovedit că are importanță
Ce era de fapt lent
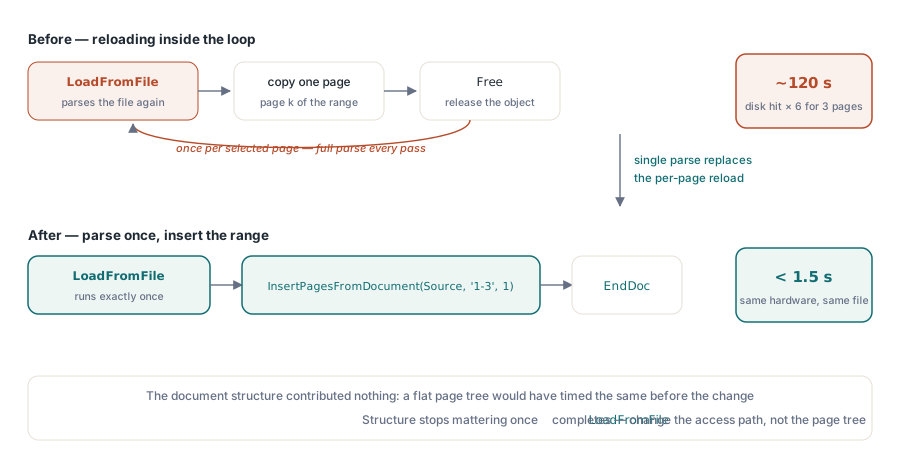
PDF-ul în cauză era un document de referință de 40 de pagini, cu un arbore de pagini netrivial: mai multe noduri /Pages intermediare, în loc de un singur tablou plat. Codul original al exemplului apela LoadFromFile, apoi construia un document nou cu BeginDoc, itera peste numerele de pagină selectate și, la fiecare iterație, încărca din nou de pe disc documentul-sursă ca să extragă o pagină. Acesta este costul complet de analiză înmulțit cu numărul de pagini dorite. Un fișier de 12 MB a lovit discul de șase ori pentru o extragere de trei pagini, pentru că nimeni nu s-a uitat dacă fișierul trebuia să rămână deschis de-a lungul iterațiilor
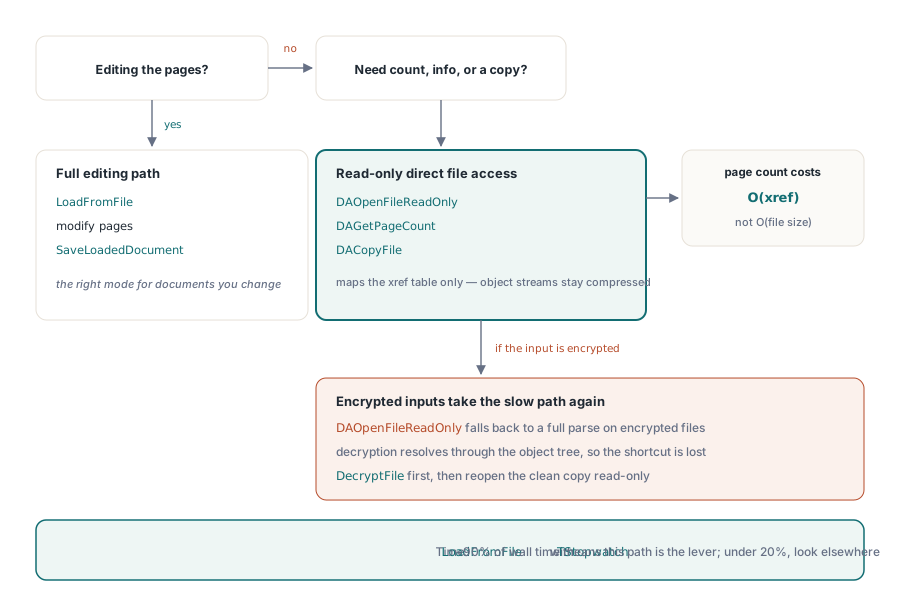
Al doilea contributor era invizibil în cod: LoadFromFile din HotPDF rezolvă întregul tabel de referințe încrucișate și decomprimă fiecare flux de obiecte la încărcare. Este comportamentul corect pentru un document pe care urmează să îl modificați, dar este mai multă muncă decât vă trebuie dacă vreți doar numărul de pagini și un subset de pagini. Pentru acces numai-citire la structură, DAOpenFileReadOnly evită deserializarea întregului arbore de obiecte, ceea ce contează la fișierele comprimate cu resurse mari de imagini
Niciunul dintre acestea nu este un defect al bibliotecii. Ambele sunt cazuri în care apelantul alege API-ul proiectat pentru o sarcină și îl folosește pentru alta
Folosirea lui InsertPagesFromDocument pentru extragerea de pagini
Calea corectă pentru a copia un interval de pagini dintr-un document HotPDF în altul este InsertPagesFromDocument, apelat după LoadFromFile pe sursă. Încărcați sursa o dată, încărcați sau creați destinația o dată, mutați paginile și salvați. Sursa rămâne în memorie de-a lungul tuturor inserărilor de pagini:
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    // Încărcați sursa o dată: analiza completă se face aici și doar aici
    Source.LoadFromFile(SourceFile);

    // Construiți un document destinație minimal
    Dest.FileName := DestFile;
    Dest.BeginDoc;

    // Copiați intervalul cerut; '1-3' inserează paginile de la 1 la 3
    // începând de la poziția 1 în destinație
    Dest.InsertPagesFromDocument(Source, PageRange, 1);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Parametrul PageRange acceptă același format ca exemplul din linia de comandă: o listă separată prin virgule de numere de pagină sau de intervale, precum '1-3' sau '1,5,7-9'. Paginile se numără de la 1. InsertPagesFromDocument copiază fluxurile de conținut, dicționarele de resurse și geometria paginii, fără să atingă metadatele, marcajele sau atașamentele de fișiere încorporate, dacă acestea nu sunt referite din paginile copiate. Pentru o extragere de trei pagini dintr-un document de 40, acesta este un set de lucru mic
Cronometrarea pe același fișier de 12 MB care rula anterior două minute: sub 1,5 secunde cu acest tipar. Cea mai mare parte a acelui timp este unicul apel LoadFromFile. Structura documentului este irelevantă odată ce tabelul de obiecte a fost rezolvat prima dată
Când LoadFromFile este prea mult: API-ul de acces direct la fișier
Dacă vreți doar să numărați pagini, să inspectați informațiile documentului sau să copiați un fișier fără să îi atingeți conținutul, API-ul de acces direct la fișier evită complet analiza completă. DAOpenFileReadOnly mapează tabelul de referințe încrucișate fără să decomprime fluxurile de obiecte, deci numărul de pagini este O(dimensiunea xref), nu O(dimensiunea fișierului):
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile este o copiere care păstrează octeții, fără reserializare
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Rezerva: DAOpenFileReadOnly acceptă un parametru de parolă, dar cade înapoi la o analiză completă pentru intrările criptate, pentru că decriptarea cere arborele de obiecte ca să rezolve dicționarul de criptare. Dacă fișierele dumneavoastră sursă sunt criptate, decriptați-le mai întâi cu DecryptFile, ca să obțineți o copie necriptată, apoi deschideți-o pe aceea cu API-ul de acces direct la fișier. Funcția la nivel de fișier DecryptFile ia o cale directă de rescriere AES-256 pentru criptarea standard și este mai rapidă decât LoadFromFile urmat de SaveLoadedDocument pentru fișiere mari, pentru că nu construiește modelul complet de obiecte în memorie
Memoria în timpul prelucrării loturilor mari
Sarcinile în lot care prelucrează zeci de fișiere într-o buclă au un tipar care pare corect, dar acumulează memorie: crearea lui THotPDF în interiorul buclei, apelarea lui LoadFromFile, munca propriu-zisă, apelarea lui Free. Structural, este în regulă. Problema apare când munca interioară alocă obiecte temporare, prinde excepții și lasă acele obiecte temporare vii pe traseele de eroare. Managerul de memorie din Delphi nu compactează, deci o sută de scurgeri pe trasee de eroare într-o rulare în lot pot împinge memoria destul de sus încât să încetinească alocarea pentru orice altceva
Remedierea nu este exotică. Fiecare THotPDF și fiecare TStream sau TBitmap intermediar care participă la munca PDF își are locul într-un bloc try/finally, în care Free este ultima instrucțiune. Puneți pointerii locali pe nil înainte de try, ca ramura finally să poată folosi în siguranță if Assigned(x) then x.Free atunci când inițializarea eșuează la jumătate. Aceasta este disciplina standard de proprietate din Delphi și este toată povestea pentru această clasă de probleme
Încă un lucru de verificat în contexte de lot: AddImage înregistrează imaginile într-o listă internă care persistă pe toată durata de viață a instanței THotPDF. Dacă refolosiți o singură instanță pentru multe documente, apelând LoadFromFile în mod repetat, înregistrările de imagini din documentele anterioare rămân în listă. Fie creați o instanță proaspătă per document, fie apelați calea de golire a listei de imagini între documente
Măsurați înainte să schimbați ceva
Înainte să apelați la vreunul dintre aceste tipare, măsurați. TStopwatch din System.Diagnostics, în Delphi, învelește QueryPerformanceCounter și este destul de precis pentru profilarea în timp real a operațiilor de intrare-ieșire pe fișiere. Înfășurați doar LoadFromFile și vedeți cât din timp îi revine. Dacă este 90% din timpul total, remedierea este API-ul de acces direct la fișier sau reducerea numărului de analize ale aceluiași fișier. Dacă este sub 20%, gâtuirea este în altă parte și urmăriți lucrul greșit
Extragerea de două minute cu care a început acest articol s-a dovedit a fi în întregime tiparul de reîncărcare repetată. Structura documentului nu a contribuit cu nimic; un arbore de pagini plat ar fi rulat la fel. Trecerea la un singur LoadFromFile urmat de un singur apel InsertPagesFromDocument a adus-o la 1,3 secunde pe același hardware, fără să atingem nimic altceva
API-ul de manipulare a paginilor arătat aici face parte din HotPDF Delphi Component pentru Delphi și C++Builder