HotXLS, biblioteca Excel nativă pentru Delphi și C++Builder, analizează foile XLSX pe mai multe fire de execuție printr-o încărcare în trei faze: XML-ul foilor este decomprimat serial, analizat în paralel, iar părțile mici sunt citite serial după aceea. Prima versiune a acestei funcționalități a câștigat doar 12–25%, pentru că blocajul managerului de memorie implicit din Delphi serializa firele lucrătoare. Reducerea alocărilor din heap de la aproximativ 20 la 9,1 pe celulă a ridicat sporul paralel la ×1,90 pe opt fire. Acest articol parcurge măsurătorile, drumurile greșite și cele două remedieri care au funcționat cu adevărat
Cum analizează HotXLS foile XLSX în paralel?
HotXLS împarte Open în trei faze, iar doar cea din mijloc rulează pe fire lucrătoare. Motivul este containerul zip: o arhivă zip este un singur flux de intrare partajat, cu o singură mașină de stare pentru inflate, iar acea mașină de stare nu poate fi citită de două fire deodată. Învelirea ei într-un blocaj ar fi inutilă, pentru că inflate este intrinsec serial per intrare, deci un blocaj ar reproduce pur și simplu execuția serială, cu o suprasarcină în plus. De aceea, faza A decomprimă XML-ul fiecărei foi în propriul TMemoryStream, încă pe un singur fir; în fișierul nostru de referință asta a durat circa 4 ms pentru opt părți de foaie, deci nu este nici pe departe gâtuirea. Faza B rulează ParseWorksheetXml pentru fiecare foaie pe un grup de lucrători, iar aici se află aproape tot timpul de încărcare. Faza C se întoarce serial la zip pentru părțile mici: comentarii, desene, diagrame și tabele
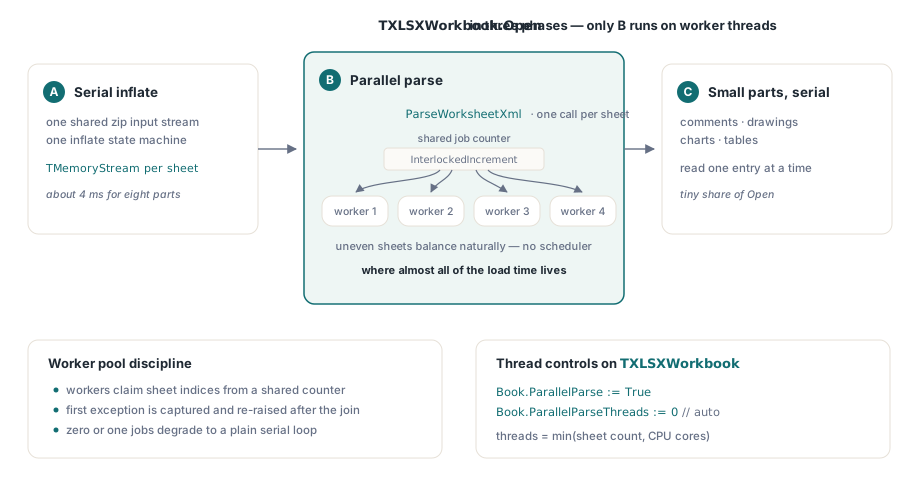
Grupul de lucrători în sine este deliberat simplu. Lucrătorii trag indici de sarcini dintr-un contor partajat cu InterlockedIncrement, deci foile de mărimi inegale se echilibrează natural, fără niciun planificator. Numărul de fire este min(sheet count, CPU cores), prima excepție a unui lucrător este capturată cu AcquireExceptionObject și ridicată din nou pe firul principal după joncțiune, iar dispecerul degradează la o buclă serială simplă când sunt zero sau o singură sarcină. Două proprietăți pe TXLSXWorkbook controlează funcționalitatea: ParallelParse deschide poarta grupului, iar ParallelParseThreads plafonează numărul de fire, 0 însemnând automat. Registrele cu mai multe foi sunt forma care beneficiază, inclusiv cele pe care le produceți duplicând de zeci de ori o foaie-șablon
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // activează grupul paralel de lucrători
    Book.ParallelParseThreads := 0;  // 0 = automat: min(foi, nuclee CPU)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... citiți celulele ca de obicei; registrul este complet materializat ...
  finally
    Book.Free;
  end;
end;
De ce adăugarea de fire încetinește parsarea XLSX în Delphi?
Pentru că managerul de memorie implicit din Delphi își protejează heapul cu un blocaj global, iar analiza foilor este densă în alocări: celule, Variant-uri și WideString-uri cu milioanele. Fiecare lucrător care atinge heapul se așază la coadă pe acel blocaj, deci fire care par independente în codul sursă se execută practic aproape unul câte unul. Primul nostru test de referință a făcut asta dureros de concret. Pe un registru cu 8 foi, cu 5.000 de rânduri pe 4 coloane per foaie, măsurat pe un i5-11600K (6 nuclee, 12 fire) sub Win64, Open paralel s-a îmbunătățit cu doar 12–25%, față de o estimare din plan de cel puțin 40%. O baleiere a numărului de fire peste 2, 3, 4, 6 și 8 a produs o curbă plată, iar în rulări instrumentate ulterioare configurația cu 2 fire a fost de fapt cu 26% mai lentă decât cea serială, semnătura clasică a două fire care își pasează un blocaj disputat
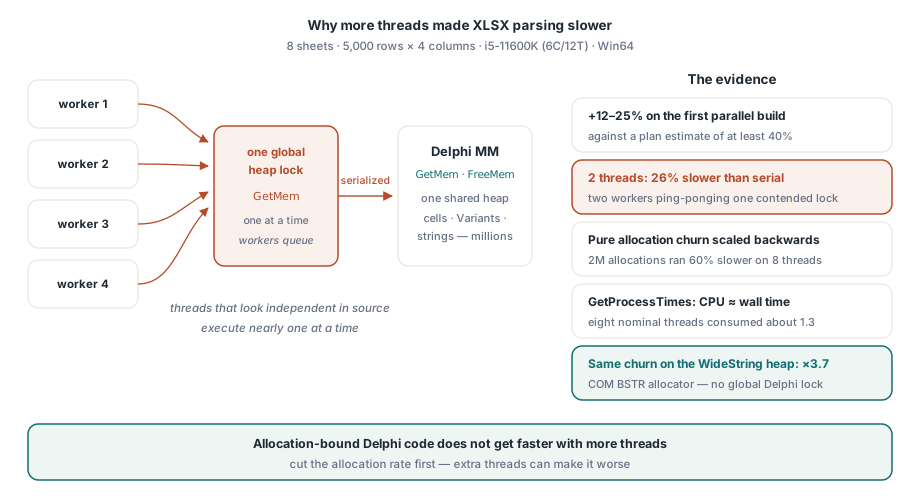
Trei măsurători au fixat diagnosticul, iar fiecare a răsturnat intuiția anterioară. Întâi, un fișier minuscul (8 foi de câte 1 rând) s-a deschis în 1,2 ms, dovedind că analiza este practic 100% din Open și că nu exista niciun cost fix ascuns de învinovățit. Apoi, un microtest de volum pur de alocări a arătat managerul de memorie Delphi scalându-se invers: același volum total de 2 milioane de alocări de obiecte și AnsiString a rulat cu 60% mai lent pe 8 fire decât pe unul, în timp ce același volum pe heapul WideString, care este alocatorul COM BSTR, nu MM-ul Delphi, s-a scalat la ×3,7. Faptul că HotXLS folosește WideString peste tot s-a dovedit un accident al istoriei care ne-a lucrat în favoare. În al treilea rând, GetProcessTimes a arătat că, în timpul unui Open paralel, timpul CPU era aproximativ egal cu timpul real: opt fire nominale consumau cât circa 1,3 fire de CPU. Lucrătorii nu se învârteau în gol; dormeau pe traseul de dispută al managerului de memorie, blocați, nu ocupați
Lecția practică se generalizează dincolo de foile de calcul. Dacă o sarcină Delphi alocă masiv, creșterea numărului de fire nu face nimic până când rata de alocare nu scade și poate ușor înrăutăți lucrurile. Înainte de această remediere, le spuneam utilizatorilor care reglau ParallelParseThreads adevărul cinstit: pe fișierele limitate de alocări, mai multe fire cumpărau aproape nimic
De unde vin 20 de alocări din heap pe celulă?
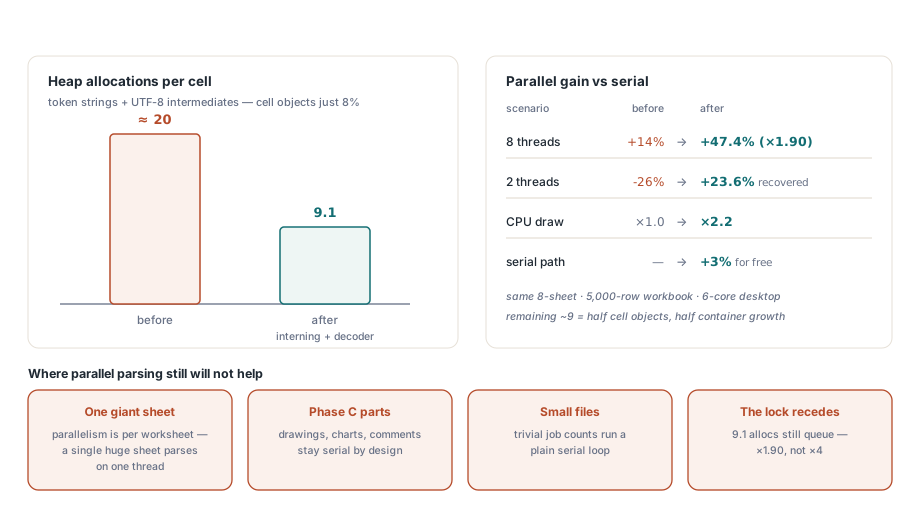
Un înveliș de numărare instalat cu SetMemoryManager a răspuns precis la această întrebare: aproximativ 20 de alocări din MM-ul Delphi pe celulă, dintre care 2,87 milioane de 32 de octeți sau mai puțin. Vinovatul nu erau deloc obiectele-celulă. TXMLScaner.GetTokenValue materializa un AnsiString nou la fiecare apel, iar el este apelat cam de 15–20 de ori pe celulă: câte o dată pentru nume de elemente, nume de atribute, valori de atribute și conținut text. Pe deasupra, traseul UTF8ToWideString din RTL fabrica un UnicodeString intermediar temporar pentru fiecare conversie. Obiectele-celulă au reprezentat doar 160 de mii de alocări, cam 8% din total, ceea ce ne-a ucis planul inițial pe loc: intenționaserăm să construim un rezervor de obiecte-celulă, iar cifrele spuneau că nu s-ar amortiza niciodată
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // volumul de obiecte mici care ne interesează
  Result := OldMM.GetMem(Size);
end;

// instalați înainte de Open, restaurați după
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Acel diagnostic de zece minute merită furat pentru orice investigație de performanță în Delphi. Numărarea alocărilor pe intervale de dimensiune costă aproape nimic de construit și vă spune de unde provine cu adevărat presiunea pe managerul de memorie, care în cazul nostru erau două obiceiuri de nivel RTL din interiorul scanerului XML, nu ceva din modelul de obiecte. Profilerele arătau întruna către analizor ca întreg; învelișul arăta către două linii precise
Remedierea: internarea tokenurilor și un decodor UTF-8 fără intermediari
Două schimbări țintite în cititorul XML au eliminat mai mult de jumătate din alocările pe celulă, fără să atingă structura analizorului. Prima este internarea numelor de elemente. XML-ul foilor repetă la nesfârșit un vocabular minuscul: row, c, v, r, t, s și o mână de nume de atribute. InternTokenName ține un cache cu 64 de sloturi de nume întâlnite anterior și compară buferul constructorului scanerului cu o intrare din cache prin TokenEqualsAnsi, o comparație directă de octeți care nu alocă nimic. La o potrivire, returnează AnsiString-ul din cache, iar aici contează alegerea tipului: AnsiString este numărat pe referințe, deci returnarea unei instanțe din cache costă o incrementare de contor și zero trafic pe heap. WideString nu are contor de referințe, iar fiecare atribuire trece prin SysAllocString, deci internarea WideString-urilor nu ar economisi nimic. Internarea merită făcută doar pe tipul de șir numărat pe referințe
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // doar refcount++, nicio alocare
  else
  begin
    Result := GetTokenValue;        // materializează o dată, apoi pune în cache
    FInternNames[Slot] := Result;
  end;
end;
A doua schimbare atacă textul celulelor. Traseul vechi construia un token AnsiString, îl dădea lui UTF8ToWideString, care construia un UnicodeString intermediar, care era în cele din urmă convertit în WideString-ul pe care îl stochează celula: două alocări din MM-ul Delphi pe token de text înainte de cea reală. Înlocuitorul, XmlUtf8ToWide(TokenPtr, TokenLen), este un decodor UTF-8 în Pascal pur, cu două treceri, care citește direct din buferul de scanare: prima trecere măsoară lungimea UTF-16, a doua decodează într-un WideString alocat o singură dată. Cost net per token de text: o alocare COM, zero alocări din MM-ul Delphi. O notă semantică pentru cei prudenți: pe secvențe UTF-8 malformate, noul decodor lasă octeții să treacă în loc să pună caractere de înlocuire cum face RTL-ul, ceea ce afectează doar felul în care se degradează fișierele corupte; pe intrare validă, ieșirea este identică la nivel de octet. Entitățile de caracter XML nu ajung niciodată la decodor, pentru că scanerul le-a rezolvat deja în UTF-8 în buferul de tokenuri
Ce a adus și unde tot nu ajută analiza paralelă
Cele două remedieri au redus alocările pe celulă de la circa 20 la 9,1, iar cifrele paralele s-au mișcat așa cum spunea teoria că ar trebui. Pe același test de referință cu 8 foi și 5.000 de rânduri și pe aceeași mașină 6C12T, îmbunătățirea pe 8 fire a urcat de la 14% la 47,4%, un spor de ×1,90 față de serial. Cazul cu 2 fire a basculat de la 26% mai lent la 23,6% mai rapid, iar utilizarea CPU măsurată a crescut de la ×1,0 la ×2,2. Traseul serial a devenit și el cu circa 3% mai rapid, ca bonus, fiindcă mai puține alocări ajută și un singur fir. Cele ~9 alocări rămase pe celulă sunt aproximativ pe jumătate obiecte-celulă și pe jumătate creștere amortizată de containere; le-am măsurat, am judecat că randamentele scad și ne-am oprit, cu învelișul de MM pregătit să reeșantioneze pe locuri de apel dacă o sarcină viitoare justifică o nouă rundă
Limitele merită spuse la fel de deschis ca reușitele. HotXLS paralelizează la granularitatea foii, deci un registru care este o singură foaie uriașă se analizează pe un singur fir, orice ar spune ParallelParseThreads; pentru acea formă, cititorul direct în flux este unealta mai bună, fiindcă evită cu totul materializarea registrului. Fișierele al căror timp se duce în părțile fazei C, desene, diagrame și comentarii, văd mai puțin beneficiu, pentru că acea fază rămâne serială prin proiectare. Fișierele mici nu merită deloc paralelizate, motiv pentru care dispecerul rulează discret serial pentru numere neînsemnate de sarcini. Iar plafonul managerului de memorie nu a dispărut, doar s-a retras: la 9,1 alocări pe celulă, blocajul global tot taxează lucrătorii, motiv pentru care opt fire dau ×1,90 în loc de ×4. Pentru trusa mai largă de reducere a timpilor de încărcare și salvare, inclusiv stiluri, rezervoare și callback-uri pe rânduri în masă, vedeți ghidul nostru despre performanța registrelor mari în Delphi
Analiza XLSX paralelă, proprietățile ParallelParse și ParallelParseThreads și cititorul XML econom la alocări descris aici sunt livrate ca părți standard ale HotXLS Delphi Excel Component, care citește și scrie XLS, XLSX și ODS nativ din Delphi și C++Builder, fără nicio automatizare Excel implicată