HotXLS Delphi Excel Component păstrează tabelele data pilot din OpenDocument printr-un ciclu de deschidere și salvare ODS, capturând identic subarborele <table:data-pilot-tables> din content.xml la deschidere și redându-l la salvare, începând cu v2.382.0. Din v2.382.1 fragmentul duce cu el și fiecare legătură de namespace XML declarată de strămoșii lui, așa că definiția de pivot salvată rămâne bine formată pentru orice consumator, nu doar pentru HotXLS
Bug-ul care a forțat ambele modificări a ieșit dintr-o rulare strictă pe corpus. Eșantionul official-pivot.ods, scris de un build de dezvoltare LibreOffice 6.1, conține un singur pivot numit DataPilot1, care citește Sheet1.A2:E30 și își pune rezultatul în Sheet1.G6:J18. Deschideți-l cu HotXLS, salvați-l neschimbat, numărați elementele <table:data-pilot-table> din rezultat: unul la intrare, zero la ieșire, la fel pe Win32 și Win64. Nimic din test nu atingea pivotul. Prima rundă de sondaje comparase doar constante de celulă și trecuse; aserțiunea structurală este cea care a expus pierderea, ceea ce amintește că „valorile se potrivesc” este o definiție slabă a fidelității de round-trip
De ce dispare un tabel pivot ODS după o salvare din librărie?
Un tabel pivot ODS dispare pentru că HotXLS nu are un model în memorie pentru tabelele data pilot din OpenDocument, iar scriitorul ODS construiește content.xml în întregime din model. Scriitorul asamblează stiluri automate, un <table:table> per foaie de calcul, <table:content-validations>, <table:named-expressions> și <table:database-ranges>, fiecare generat din obiecte pe care registrul le deține efectiv. O definiție de pivot — ODF 1.3 Part 3 §9.6, un container <table:data-pilot-tables> cu un <table:data-pilot-table> per pivot, purtând table:source-cell-range, copiii lui table:data-pilot-field, table:target-range-address și table:buttons — nu are niciun obiect în care să trăiască, așa că partea regenerată pur și simplu o omite
Contrastul cu XLSX este deliberat. HotXLS parsează cache-urile și tabelele pivot SpreadsheetML într-un model real pe care îl puteți construi, extinde cu câmpuri calculate și reîmprospăta din Delphi, așa că acelea supraviețuiesc unei salvări pentru că sunt rescrise, nu copiate. Pivoturile ODS sunt o cerere mult mai rară, iar modelarea vocabularului data pilot din ODF doar de dragul round-trip-ului ar însemna mult cod pe care nimeni nu îl editează. Răspunsul pragmatic este același pe care HotXLS îl aplică deja la blocurile extLst necunoscute din XLSX: păstrează ce nu modelezi, octet cu octet dacă se poate, eveniment cu eveniment dacă nu
Ce a greșit prima captură bazată pe Pos?
Captura din v2.382.0 decupa definiția de pivot din content.xml ca pe un simplu șir, iar decupajul pierdea declarațiile de namespace care o făceau inteligibilă. Implementarea era atât de scurtă pe cât sună — decodează partea într-un WideString, găsește tag-ul de deschidere cu Pos, găsește tag-ul de închidere după el, copiază intervalul în FRawOdsDataPilotTablesXml de pe registru:
// HotXLS v2.382.0 -- înlocuită o versiune mai târziu
function OdsCaptureDataPilotTablesXml(Stream: TStream): WideString;
const
  OpenTag: WideString = '<table:data-pilot-tables';
  CloseTag: WideString = '</table:data-pilot-tables>';
var
  Text: WideString;
  StartPos, ClosePos: Integer;
begin
  Result := '';
  Text := LoadPartAsWideString(Stream);   // tot content.xml în memorie
  StartPos := Pos(OpenTag, Text);
  if StartPos = 0 then Exit;
  ClosePos := Pos(CloseTag, Copy(Text, StartPos, MaxInt));
  if ClosePos = 0 then Exit;
  Result := Copy(Text, StartPos, ClosePos + Length(CloseTag) - 1);
end;
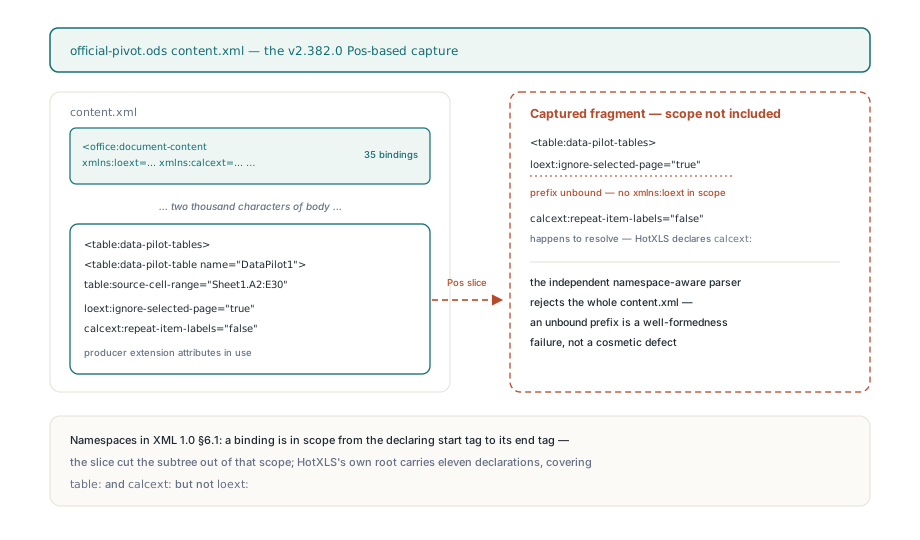
Aserțiunea de numărare a trecut pe verde, iar reparația a fost livrată. Ce a prins-o a fost o a doua verificare, mai strictă, adăugată în aceeași zi: fiecare parte XML a pachetului salvat este dată unui parser independent care cunoaște namespace-uri, din afara HotXLS, iar acel parser a respins noul content.xml cu o eroare de prefix nelegat. Pivotul din LibreOffice poartă atribute de extensie ale producătorului — loext:ignore-selected-page="true" pe un câmp de pagină, calcext:repeat-item-labels="false" pe fiecare nivel — iar șirul decupat conținea acele atribute, dar nu și declarațiile xmlns:loext și xmlns:calcext care le legau. Acele declarații stăteau pe rădăcina <office:document-content> a fișierului sursă, treizeci și cinci la număr, la două mii de caractere distanță de pivot
W3C Namespaces in XML 1.0 §6.1 definește regula care face din asta o eroare gravă, nu una cosmetică: o declarație de namespace este în domeniu de la tag-ul de început al elementului pe care apare până la tag-ul lui de sfârșit, iar fiecare nume cu prefix din acel domeniu se rezolvă prin ea. Decupați un subarbore din document și îl decupați și din domeniu. HotXLS își scrie propria rădăcină <office:document-content> cu unsprezece declarații — office, table, text, style, number, fo, draw, svg, xlink, calcext, tableooo — așa că calcext: se nimerea să se rezolve, table: se nimerea să se rezolve, iar loext: nu. Un parser care cunoaște namespace-uri tratează un prefix nelegat ca pe o încălcare a bunei formări, ceea ce înseamnă că toată partea este ilizibilă, nu doar un atribut
Cum duce HotXLS legăturile xmlns ale strămoșilor pe fragment?
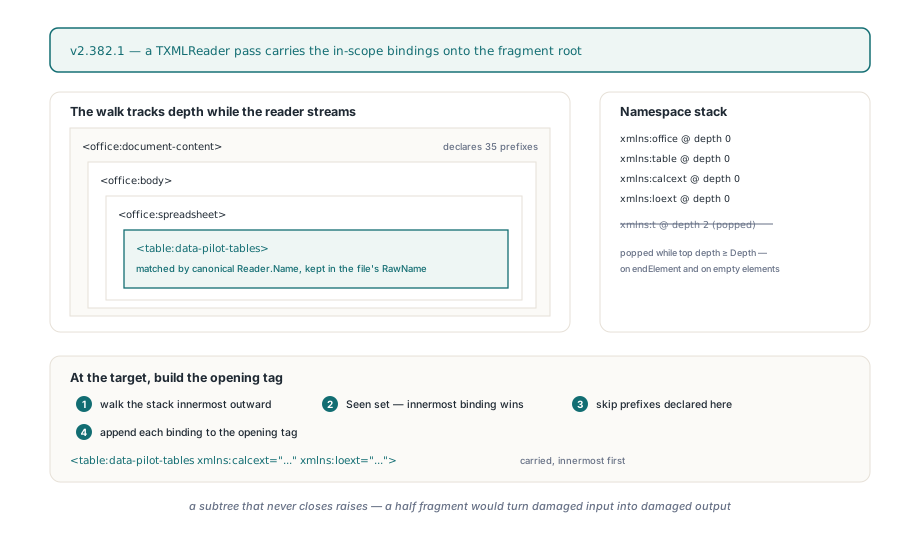
HotXLS v2.382.1 a înlocuit decupajul pe șir cu o trecere peste content.xml prin propriul TXMLReader în flux, întreținând o stivă de legături de namespace etichetate cu adâncimea la care a fost declarată fiecare și copiind legăturile încă în vigoare pe elementul rădăcină al fragmentului în momentul în care ținta este atinsă. Reader-ul rulează cu PreserveWhitespaceText activat, ca nodurile de text să vină exact cum au fost scrise, iar tag-urile reconstruite folosesc TXMLReader.RawName și TXMLReader.Attribute[I].RawName — grafia prefixului din fișier — în locul numelor canonice pe care reader-ul le predă de obicei parserelor de părți. Iată miezul buclei:
// Namespaces: TStringList cu 'xmlns:p=uri' și adâncimea declarării în Objects[]
while Reader.Read do
begin
  if CaptureDepth >= 0 then
    XlsxAppendRawXmlReaderNode(Result, Reader);   // element, text, CDATA, comentariu
  if Reader.NodeType = xmlntElement then
  begin
    for I := 0 to Reader.AttributeCount - 1 do
    begin
      AttrName := Reader.Attribute[I].RawName;
      if (AttrName = 'xmlns') or (Pos(WideString('xmlns:'), AttrName) = 1) then
        Namespaces.AddObject(String(AttrName) + '=' + String(Reader.Attribute[I].Value),
          TObject(NativeInt(Depth)));
    end;
    if (CaptureDepth < 0) and (Reader.Name = 'table:data-pilot-tables') then
    begin
      Opening := XlsxRawXmlReaderOpenTag(Reader);   // elimină mai întâi '>' sau '/>' de la final
      ...
      // Duce legăturile efective ale strămoșilor pe rădăcina fragmentului.
      for I := Namespaces.Count - 1 downto 0 do
      begin
        AttrName := WideString(Namespaces.Names[I]);
        if Seen.IndexOf(String(AttrName)) >= 0 then Continue;   // legătura cea mai interioară câștigă
        Seen.Add(String(AttrName));
        if not Reader.HasAttribute(AttrName) then               // deja declarat aici? sari peste
          Opening := Opening + ' ' + AttrName + '="' +
            XlsxEscapeAttr(WideString(Namespaces.ValueFromIndex[I])) + '"';
      end;
      ...
      CaptureDepth := Depth;
    end;
    if not Reader.IsEmptyElement then Inc(Depth);
  end
  else if Reader.NodeType = xmlntEndElement then
  begin
    Dec(Depth);
    if Depth = CaptureDepth then Exit;                           // subarbore închis
  end;
  if (Reader.NodeType = xmlntEndElement) or
     ((Reader.NodeType = xmlntElement) and Reader.IsEmptyElement) then
    while (Namespaces.Count > 0) and
          (NativeInt(Namespaces.Objects[Namespaces.Count - 1]) >= Depth) do
      Namespaces.Delete(Namespaces.Count - 1);                   // ieși din domeniu
end;
if CaptureDepth >= 0 then
  raise Exception.Create('OpenDocument pivot definition ended inside an element');
Trei detalii din acea buclă susțin corectitudinea. Parcurgerea stivei de la legătura cea mai interioară spre exterior și reținerea fiecărui prefix în Seen implementează umbrirea: dacă un strămoș mai apropiat reia xmlns:table, valoarea mai apropiată câștigă, exact cum spune §6.1 că trebuie. Sărirea peste prefixele pe care elementul le declară deja evită emiterea aceluiași atribut de două ori, ceea ce ar fi o altă eroare de bună formare. Iar regula de scoatere de pe stivă se declanșează la tag-urile de sfârșit și la elementele goale, pentru că <x/> nu produce niciodată un eveniment EndElement — aceeași capcană a auto-închiderii pe care a trebuit să o învețe și captura de extLst din XLSX. Potrivirea țintei după Reader.Name, nu după RawName, este un câștig mai discret: reader-ul canonicalizează URI-ul de namespace table din ODF la prefixul table, așa că un producător care îl scrie t:data-pilot-tables se potrivește în continuare, în timp ce fragmentul emis păstrează prefixul pe care l-a folosit producătorul
Bucla refuză de asemenea să ghicească. Dacă partea se termină în timp ce captura este încă deschisă — un content.xml trunchiat sau rău format — OdsCaptureDataPilotTablesXml ridică excepție în loc să întoarcă un fragment pe jumătate, pentru că un fragment pe jumătate ar fi scris înapoi la salvare și ar transforma o intrare deteriorată într-o ieșire deteriorată care poartă numele librăriei
Unde ajunge fragmentul în content.xml salvat?
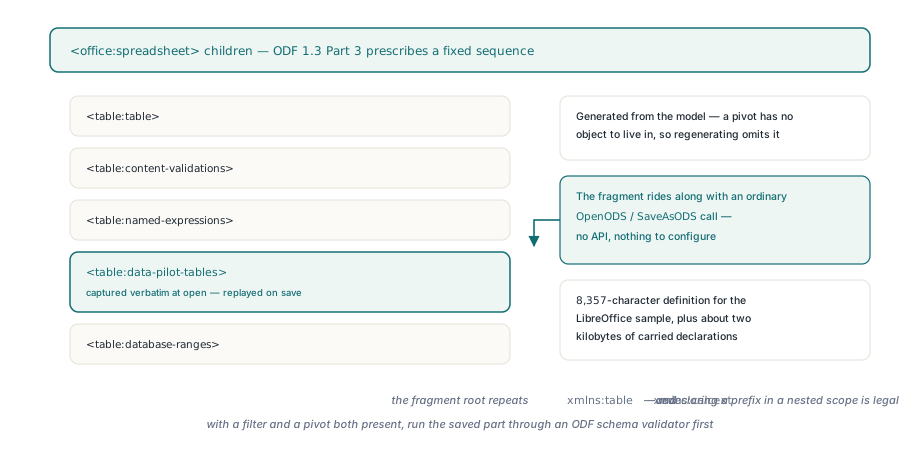
HotXLS scrie fragmentul capturat în <office:spreadsheet> imediat după <table:named-expressions> pe care îl generează și înaintea lui <table:database-ranges>. Modelul de conținut al lui <office:spreadsheet> din ODF 1.3 Part 3 prescrie o secvență fixă pentru acei copii de la final, așa că un bloc identic nu poate fi pur și simplu adăugat oriunde s-ar afla scriitorul în acel moment; trebuie plasat într-un loc anume. Din partea apelantului nu există niciun API și nimic de configurat; definiția călătorește împreună cu o deschidere și o salvare obișnuită:
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS('official-pivot.ods') <> 1 then
      raise Exception.Create('open failed');
    Book.Sheets[0].Cells[2, 5].Value := 1250.0;   // editare în interiorul intervalului sursă al pivotului
    Book.SaveAsODS('official-pivot-out.ods');
    // content.xml din ieșire duce în continuare DataPilot1 cu
    // intervalul sursă, câmpurile, intervalul țintă, butoanele și atributele loext:/calcext:
  finally
    Book.Free;
  end;
end;
Redundanța este intenționată și merită știută. Rădăcina fragmentului repetă acum xmlns:table și xmlns:calcext, chiar dacă rădăcina documentului salvat le declară și ea; Namespaces in XML permite redeclararea unui prefix într-un domeniu imbricat, așa că duplicatele sunt inofensive. Pentru eșantionul LibreOffice, setul dus cu el cuprinde toate cele treizeci și cinci de declarații de rădăcină, cam două kiloocteți peste definiția de 8,357 caractere, pentru că captura nu analizează ce prefixe folosește efectiv subarborele. O scanare a prefixelor folosite ar reduce asta și poate va veni mai târziu; întâi corectitudinea, apoi compactitatea
O regulă pentru decuparea subarborilor din XML în vederea redării identice
Lecția generală este că un subarbore este autonom doar după ce l-ați făcut autonom, iar domeniul de namespace este primul lucru care se rupe când uitați asta. Lista de verificare pe care HotXLS o aplică acum oricărei capturi de tip „păstrează ce nu modelăm”:
- Parcurgeți documentul cu un reader real și urmăriți legăturile aflate în domeniu. Căutarea în șir cu
Posnu poate vedea deloc domeniul și se potrivește greșit și pe elemente imbricate cu același nume, și pe un șir potrivit din interiorul unui comentariu sau al unei secțiuniCDATA, și pe valori de atribut care se întâmplă să conțină textul tag-ului - Copiați legăturile efective pe rădăcina fragmentului, de la cea mai interioară spre exterior, o dată per prefix, sărind peste ce declară deja rădăcina
- Păstrați grafia brută a prefixului în tag-urile emise; potriviți ținta după namespace-ul rezolvat, nu după prefixul literal
- Păstrați nodurile de text cu spații albe și țineți minte că un element gol își închide singur domeniul, fără un eveniment de tag de sfârșit
- Validați partea salvată cu un parser care nu este librăria testată. Librăria își va reciti bucuroasă propria ieșire prin același drum de cod îngăduitor care a scris-o
Ultimul punct este cel care a găsit efectiv HXLS-003 a doua oară. Verificarea de acceptanță din v2.382.0 era o expresie regulată care număra tag-urile de început data-pilot-table din content.xml salvat, iar o expresie regulată vede un tag, nu un document — este oarbă la întrebarea dacă prefixele de pe acel tag sunt legate. Runner-ul strict de corpus adăugat în v2.382.1 parsează fiecare parte XML și .rels a pachetului salvat cu un parser care cunoaște namespace-uri și apoi compară arborele de pivot — tag, atribute sortate, text, copii, recursiv — cu originalul. Comparația este extinsă pe namespace-uri, așa că o rescriere a prefixului ar trece în continuare, iar un prefix nelegat nu poate
Unde se termină garanția de identitate
Redarea identică păstrează o definiție; nu o înțelege, iar limitele decurg de aici. HotXLS nu expune niciun API pentru a citi, edita sau reîmprospăta un pivot ODS, așa că FRawOdsDataPilotTablesXml este un câmp intern și singurul comportament observabil este că definiția supraviețuiește. Fragmentul este reserializat din evenimentele reader-ului, nu copiat ca octeți: ghilimelele atributelor și formele auto-închise sunt normalizate, în timp ce textul și spațiile albe sunt păstrate. XML-ul capturat este emis doar de scriitorul de conținut ODS, așa că un registru deschis din .ods și salvat ca .xlsx pierde pivotul, iar un registru deschis din .xlsx nu are ce reda într-o salvare .ods — asimetriile căilor de import și export ODS se aplică aici ca peste tot. Și, pentru că definiția este opacă, nu poate urma editările voastre: redenumiți Sheet1 sau mutați datele sursă în HotXLS, iar pivotul salvat indică în continuare Sheet1.A2:E30, lăsând consumatorul să raporteze un interval rupt la următoarea reîmprospătare. O atenționare de ordonare își are locul aici: HotXLS emite intervalele AutoFilter ca <table:database-ranges> după fragmentul de pivot, iar eșantionul din corpus nu conține niciun interval de bază de date, așa că un registru care are și filtru, și pivot ar trebui trecut printr-un validator de schemă ODF înainte să vă bazați pe ordinea relativă a acelor două elemente
Testați cu fișierele propriului producător, nu doar cu eșantionul din corpus. Transportul de namespace-uri acoperă orice prefix pe care un producător îl declară pe un strămoș, dar un document care declară un prefix chiar pe elementul de pivot, sau care folosește un namespace implicit pentru vocabularul de tabele, exercită ramurile de sărire și de umbrire pe care eșantionul LibreOffice nu le atinge. Ambele sunt implementate; niciuna nu are încă un eșantion în corpus, iar această distincție este exact genul de lucru pe care o intrare de changelog tinde să îl estompeze
Captura identică de data pilot din v2.382.0 și reparația domeniului de namespace din v2.382.1 sunt livrate în HotXLS Delphi Excel Component actual, a cărui pagină de produs listează întreaga acoperire de citire și scriere ODS, XLSX și XLS pentru Delphi și C++Builder