HotXLS Delphi Component citește același șir de tipar în patru feluri diferite, pentru că Excel 16 o face. În COUNTIF și SUMIF textul a~b e literal dacă criteriul nu conține și * sau ?; în modul wildcard al lui MATCH și XLOOKUP tilda e întotdeauna un escape, deci a~b găsește ab; în DSUM și celelalte funcții de bază de date textul simplu înseamnă „începe cu”; iar Find pe celulă întreagă trebuie să facă backtrack spre ultimul *. HotXLS urmează aceste reguli măsurate din v2.384.52, v2.384.60 și v2.384.64
Rapoartele de bug din zona asta nu pomenesc niciodată wildcard-uri. Spun că un raport generat pe server numără câteva rânduri mai puțin decât același fișier recalculat în Excel, sau că un număr de piesă care conține o tildă e găsit de o formulă și ignorat de următoarea. Cauza e un matcher care presupune că un tipar înseamnă același lucru peste tot. Excel nu funcționează așa, deci niciun motor ale cărui rezultate puse în cache trebuie să fie de acord cu Excel nu poate. Înainte de v2.384.52 HotXLS trecea fiecare criteriu printr-o mască de fișiere în stil DOS, care nimerea tiparele de zi cu zi și greșea tăcut cazurile limită
De ce înseamnă un șir de tipar patru lucruri diferite în Excel?
Un șir de tipar înseamnă patru lucruri diferite pentru că Excel a moștenit patru reguli de potrivire de la patru funcționalități și nu le-a unificat niciodată. Funcțiile de criterii (COUNTIF, SUMIF, AVERAGEIF și familia *IFS) decid per criteriu dacă se aplică deloc wildcard-uri. Funcțiile de căutare (MATCH cu tip de potrivire 0, XLOOKUP cu match_mode 2) le aplică întotdeauna. Funcțiile de bază de date (DSUM, DCOUNTA și compania) urmează Advanced Filter, unde un cuvânt nud e un prefix. Dialogul Find are propriile moduri pe celulă întreagă și parțiale. Tabelul de mai jos listează ce celule potrivește fiecare tipar pe o coloană care conține a~b, ab, AB, abc, abcb, a*b și axb, cu fiecare funcție în modul ei implicit fără sens la majuscule
| Tipar | COUNTIF / SUMIF | MATCH(…,0) / XLOOKUP modul 2 | Criteriu DSUM | Find, celulă întreagă, wildcard-uri pornite |
|---|---|---|---|---|
ab | ab, AB | ab, AB | ab, AB, abc, abcb | ab, AB |
a*b | a~b, ab, AB, abcb, a*b, axb | ca la COUNTIF | fiecare intrare, abc inclus | ca la COUNTIF |
a~b | doar a~b | ab, AB | ab, AB, abc, abcb | ab, AB |
a~*b | doar a*b | doar a*b | doar a*b | doar a*b |
=ab | ab, AB | nu se aplică | ab, AB | nu se aplică |
Rândul a~b e cel în care COUNTIF și MATCH se contrazic, iar numerele de piesă și codurile tastate de mână conțin tildes mai des decât ar ghici oricine. Rândul a*b arată cealaltă capcană: abc potrivește pentru DSUM dar nu pentru COUNTIF, fiindcă funcția de bază de date adaugă tăcut un *. Intrările DSUM pentru ab, a*b și =ab vin direct din rulări Excel 16; intrarea DSUM pentru a~b decurge din aceeași regulă de prefix, fiindcă *-ul adăugat transformă criteriul într-un tipar wildcard în care ~b e un b scăpat
Când comută COUNTIF în modul wildcard?
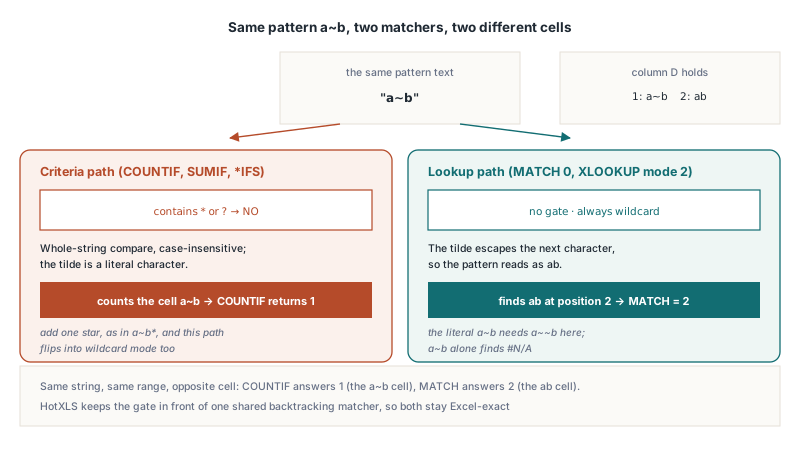
COUNTIF comută în modul wildcard doar când textul criteriului conține * sau ?, scăpate sau nu. Fără niciunul dintre caractere, Excel compară criteriul cu fiecare celulă ca șir întreg, fără sens la majuscule, iar o tildă e doar o tildă, deci COUNTIF(A1:A7,"a~b") numără celula care conține literal a~b. Adăugați o singură steluță și sensul se întoarce: în "a~b*" tilda scapă acum b-ul, tiparul se citește „ab urmat de orice”, iar celula a~b nu mai e numărată. HotXLS aplică regula asta în ambele motoare din v2.384.52, printr-un singur matcher de criterii în lxCalc partajat de COUNTIF, SUMIF, AVERAGEIF, COUNTIFS, SUMIFS, AVERAGEIFS și funcțiile de bază de date
În interiorul modului wildcard regulile de escape sunt aceleași ca oriunde altundeva în Excel: ~ face următorul caracter literal indiferent care e, deci ~b înseamnă b și ~~ înseamnă o tildă, iar o tildă chiar la capătul tiparului e aruncată, deci "a*~" se poartă ca "a*". Parantezele pătrate nu sunt niciodată speciale. Un criteriu "[x]" numără celulele care conțin cele trei caractere [x], iar "[a-z]" nu numără nimic pe date obișnuite. TXLSXWorkbook.Calculate evaluează un șir de formulă peste sheet-ul activ și întoarce un Variant, calea cea mai rapidă de a verifica regulile astea pe propriile date
uses
  System.Variants, lxHandleX;

const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;

  procedure Show(const Formula: string);
  begin
    Writeln(Formula, ' = ', VarToStr(Book.Calculate(Formula)));
  end;

begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Data');
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i, 1].Value := Names[i];
      Sheet.Cells[i, 2].Value := 1 shl (i - 1);  // 1, 2, 4 ... ca un total SUMIF să-și numească rândurile
    end;
    Sheet.Cells[8, 1].Value := 5;                // un număr; A9 rămâne gol

    Show('=COUNTIF(A1:A7,"a~b")');      // 1    fără * sau ?: text simplu, celula a~b
    Show('=COUNTIF(A1:A7,"a~b*")');     // 4    mod wildcard: ab, AB, abc, abcb
    Show('=COUNTIF(A1:A7,"a*b")');      // 6    wildcard pe tot șirul, abc exclus
    Show('=SUMIF(A1:A7,"a*b",B1:B7)');  // 119  fiecare rând în afară de abc (8)
    Show('=COUNTIF(A1:A7,"a~*b")');     // 1    literalul a*b
    Show('=COUNTIF(A1:A9,"<>ab")');     // 7    numărul 5 și A9 gol numără
    Show('=COUNTIF(A1:A9,"<>")');       // 8    celulele non-gole
  finally
    Book.Free;
  end;
end.
Ce numără „<>text”?
Un criteriu "<>text" numără fiecare celulă care nu e acel text, iar în Excel 16 asta include numere, boolean-i, valori de eroare și celule goale. Un "<>" nud e cu totul altă întrebare: înseamnă „nu e celulă goală”, deci sărite celulele goale dar numără orice valoare, inclusiv textul gol pe care îl întoarce o formulă precum ="". Codul HotXLS vechi nimerea celulele de text dar nu și pe cele numerice: o inegalitate de Variant făcea Delphi să convertească 'ab' în număr, conversia ridica o excepție, un handler o înghițea drept „nicio potrivire”, iar celulele numerice ieșeau tăcut din numărare. Partea cu celulele goale a poveștii, inclusiv la ce egalează un operand gol într-o comparație obișnuită, e acoperită în cum tratează HotXLS lanțurile de comparație, celulele goale și SUMIF
De ce găsește MATCH ab când cauți a~b?
MATCH găsește ab când cauți a~b pentru că MATCH cu tip de potrivire 0 și XLOOKUP cu match_mode 2 sunt întotdeauna în modul wildcard, deci tilda e un escape chiar când tiparul nu conține nici * nici ?. Excel 16 confirmă pe un interval de două celule cu a~b și ab: MATCH("a~b",D1:D2,0) întoarce 2, iar pe un interval care conține doar a~b același apel întoarce #N/A. Ca să cauți textul literal a~b trebuie să scrii "a~~b". Între timp COUNTIF(D1:D2,"a~b") peste aceleași două celule întoarce 1, numărând cealaltă celulă. Același șir, același interval, celulă opusă
De aceea HotXLS ține cele două decizii separate în loc să le ascundă după un singur punct de intrare „potrivește un tipar”. Matcher-ul în sine e partajat: din v2.384.52, MATCH, XLOOKUP și funcțiile de criterii rulează același matcher cu backtrack, cu aceeași gestionare a escape-urilor și aceeași regulă a tildei finale. Ce diferă e poarta din fața lui. Calea criteriilor întreabă întâi „textul ăsta conține * sau ??”; calea de căutare nu întreabă niciodată. Îmbinarea lor ar repara o familie și ar rupe cealaltă, iar ambele direcții sunt verificate față de valorile Excel 16 în ambele motoare. Căutările cu wildcard au și o precondiție a lor: XLOOKUP respinge potrivirea wildcard combinată cu un mod de căutare binară, regulă descrisă în ghidul HotXLS al modurilor de căutare XLOOKUP și XMATCH
Cum citesc DSUM și funcțiile de bază de date un criteriu de text simplu?
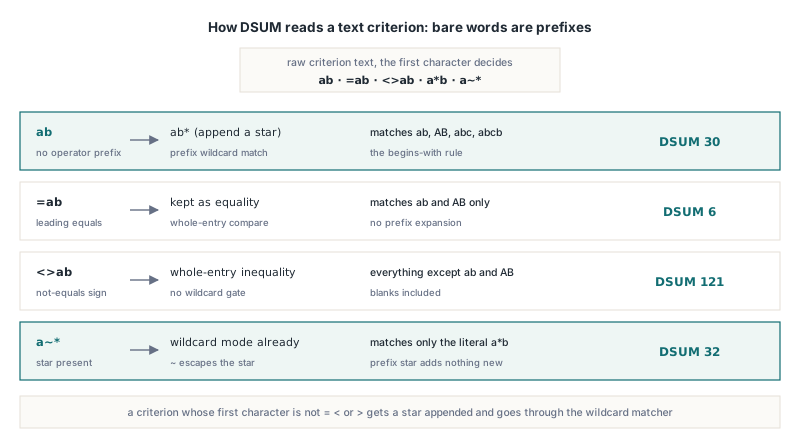
DSUM și celelalte funcții de bază de date citesc un criteriu de text fără =, < sau > în față drept „începe cu”, cu wildcard-urile încă active. Asta e regula Advanced Filter și diferă intenționat de COUNTIF. Excel 16 măsurat peste o coloană Name cu abc, ab, xab, AB, a~b și a*b: criteriul ab potrivește abc, ab și AB; =ab potrivește doar ab și AB; <>ab e o inegalitate pe întreaga intrare; a*b și a? sunt și ele tipare de prefix; >ab e o comparație obișnuită. Înainte de v2.384.64 HotXLS potriveau ab exact, deci un DSUM peste datele de test alea întorcea 10 acolo unde Excel întoarce 11
Repararea a trebuit să ocolească parser-ul de condiții, care pliază și ab și =ab în aceeași condiție de egalitate. HotXLS inspectează deci textul brut al criteriului înainte să aibă încredere în condiția parsată: un criteriu de text al cărui prim caracter nu e =, < sau > primește un * adăugat și trece prin matcher-ul wildcard, iar tot restul își păstrează comparația pe întreaga intrare. O notă practică când construiți intervale de criterii în cod: în motorul XLSX, atribuirea șirului '=ab' către TXLSXCell.Value stochează text, în timp ce motorul clasic TXLSWorkbook compilează o valoare care începe cu = drept formulă, dacă nu o prefixați cu un apostrof
const
  Names: array [1..7] of string = ('a~b', 'ab', 'AB', 'abc', 'abcb', 'a*b', 'axb');
  Criteria: array [0..4] of string = ('ab', '=ab', '<>ab', 'a*b', 'a~*');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Db');
    Sheet.Cells[1, 1].Value := 'Name';
    Sheet.Cells[1, 2].Value := 'Val';
    for i := 1 to High(Names) do
    begin
      Sheet.Cells[i + 1, 1].Value := Names[i];
      Sheet.Cells[i + 1, 2].Value := 1 shl (i - 1);
    end;
    Sheet.Cells[1, 4].Value := 'Name';            // antet criterii în D1
    for i := 0 to High(Criteria) do
    begin
      Sheet.Cells[2, 4].Value := Criteria[i];     // rămâne text în motorul XLSX
      Writeln(Criteria[i], ' -> ',
        VarToStr(Book.Calculate('=DSUM(A1:B8,"Val",D1:D2)')));
    end;
    // ab   -> 30   ab, AB, abc, abcb (începe cu)
    // =ab  -> 6    ab, AB (întreaga intrare)
    // <>ab -> 121  tot în afară de ab și AB
    // a*b  -> 127  a*b* potrivește toate cele șapte, abc inclus
    // a~*  -> 32   doar literalul a*b
  finally
    Book.Free;
  end;
end;
O diferență înrudită a supraviețuit reparării prefixului și contează pe build-uri mai vechi. Comparațiile de text precum >ab foloseau ordinea pe code points, în timp ce Excel pune punctuația înaintea literelor, deci "a~b">"ab" e FALSE în Excel și era TRUE în HotXLS. Din v2.384.67 criteriile > și <, împreună cu comparația obișnuită de text și sortarea, folosesc collation-ul word sort al Excel-ului sub locale-ul curent de utilizator, iar cele două iarăși sunt de acord
De ce a ratat Find pe celulă întreagă abcb?
Find pe celulă întreagă rata abcb pentru că matcher-ul se oprea la primul punct în care tiparul se epuiza în loc să facă backtrack spre ultima *. Matcher-ul de potrivire parțială din spatele Replace se întoarce imediat ce tiparul e epuizat; Find pe celulă întreagă îl refolosea și apoi cerea ca potrivirea să acopere celula întreagă: a*b contra abcb se oprea după ab, consuma 2 caractere din 4 și era respins. Din v2.384.60 matcher-ul pe celulă întreagă e o implementare separată care tratează „tiparul s-a terminat, textul nu” ca încă o nepotrivire și reia de la ultima steluță, deci a*b potrivește abcb și a?b*b potrivește axbyb, așa cum face Excel 16 Find cu „Match entire cell contents” bifat
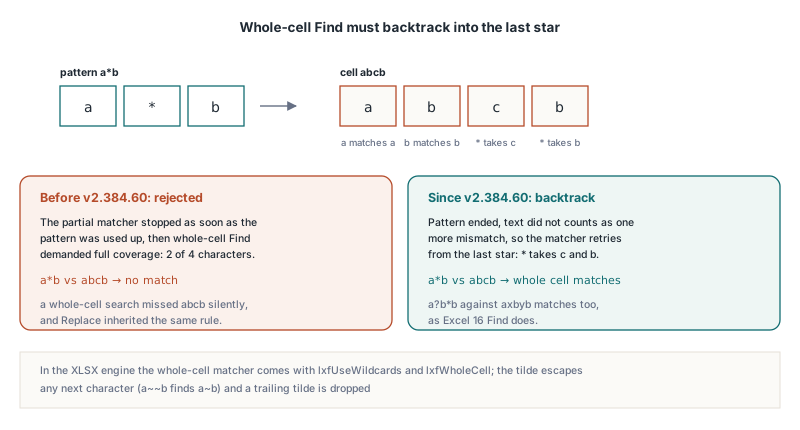
Aceeași versiune a schimbat tilda. Excel 16 Find, atât pe celulă întreagă cât și în mod parțial, tratează ~ ca escape pentru orice caracter următor: a~b găsește ab, a~~b găsește a~b, iar o tildă finală e ignorată, deci q~ se poartă ca q. Matcher-ul HotXLS mai vechi recunoștea doar ~*, ~? și ~~ ca escape-uri, deci a~b găsea textul a~b. Un tipar Find dintr-o singură ~ e instabil chiar în Excel, potrivind orice celulă ca un tipar gol, iar HotXLS nu imită asta
În motorul XLSX căutarea e TXLSXWorksheet.FindText cu un set TXLSXFindOptions: lxfUseWildcards pornește *, ? și ~, lxfWholeCell cere ca celula întreagă să potrivească, iar lxfMatchCase face comparația cu sens la majuscule. Fără lxfUseWildcards fiecare caracter, steluță inclusă, e literal. Find se uită doar la valorile de text; celulele numerice sunt sărite, iar celulele de formulă sunt sărite dacă lxfSearchFormulas nu e setat, caz în care se caută în textul formulei. Ancora dată de StartRow și StartCol e inclusivă, deci o buclă Find All pas cu pas avansează o coloană după fiecare potrivire
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row, Col, NextRow, NextCol, Changed: Integer;
  Opts: TXLSXFindOptions;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Parts');
    Sheet.Cells[1, 1].Value := WideString('abc');
    Sheet.Cells[2, 1].Value := WideString('abcb');
    Sheet.Cells[3, 1].Value := WideString('a~b');
    Sheet.Cells[4, 1].Value := WideString('ab');

    Opts := [lxfUseWildcards, lxfWholeCell];
    if Sheet.FindText('a*b', Row, Col, Opts, 1, 1) then
      Writeln('a*b  whole cell -> row ', Row);   // 2: abc respins, abcb face backtrack
    if Sheet.FindText('a~b', Row, Col, Opts, 1, 1) then
      Writeln('a~b  whole cell -> row ', Row);   // 4: ~b e un b scăpat (escaped)
    if Sheet.FindText('a~~b', Row, Col, Opts, 1, 1) then
      Writeln('a~~b whole cell -> row ', Row);   // 3: ~~ e o tildă literală

    // Potrivire parțială, Find All: celula ancoră e inclusă, deci săriți peste fiecare potrivire
    NextRow := 1;
    NextCol := 1;
    while Sheet.FindText('a*b', Row, Col, [lxfUseWildcards], NextRow, NextCol) do
    begin
      Writeln('a*b  contained in row ', Row);     // rândurile 1, 2, 3 și 4
      NextRow := Row;
      NextCol := Col + 1;
    end;

    // Înlocuirea wildcard pe celulă întreagă rescrie doar literalul a~b
    Changed := Sheet.ReplaceText('a~~b', 'a-b', Opts);
    Writeln(Changed, ' cell(s) replaced');         // 1
  finally
    Book.Free;
  end;
end;
Bucla parțială găsește toate cele patru rânduri, abc inclus, fiindcă în modul parțial a*b trebuie doar să apară undeva în celulă. FindTextIn și ReplaceTextIn primesc aceleași opțiuni plus o fereastră FirstRow, FirstCol, LastRow, LastCol, echivalentul programatic al căutării într-o selecție. Motorul clasic expune aceleași reguli printr-un overload cu trei boolean-i, TXLSWorksheet.FindText(SearchText, Row, Col, MatchCase, UseWildcards, WholeCell), plus un overload ReplaceText pereche, cu rezultate de rând și coloană cu baza unu:
var
  Classic: IXLSWorkbook;
  Sheet: TXLSWorksheet;
  Row, Col: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Sheet := Classic.Sheets.Add;
  Sheet.Range['A1', 'A1'].Value := 'abcb';
  // MatchCase = False, UseWildcards = True, WholeCell = True
  if Sheet.FindText('a*b', Row, Col, False, True, True) then
    Writeln('found at ', Row, ',', Col);           // 1,1
  if not Sheet.FindText('a*c', Row, Col, False, True, True) then
    Writeln('a*c does not cover abcb');
end;
Ce nimerea greșit vechiul matcher cu mască DOS?
Vechiul matcher nimerea greșit caracterele speciale, fiindcă o mască de fișiere DOS e o altă limbă decât un wildcard Excel. Înainte de v2.384.52 funcțiile de criterii și cele de bază de date paseau fiecare tipar către MatchesMask, un matcher de măști de fișiere din unit-ul lxMasks. Sintaxa lui se suprapune cu a Excel-ului la cazurile comune, de aceea problema a stat ascunsă, dar divergă acolo unde datele reale devin interesante:
[x]era citit ca set de caractere, deciCOUNTIF(A1:A10,"[x]")număra celulele care conținxîn locul textului cu paranteze, iar"[a-z]"potrivea orice celulă de o literă- Nu exista escape cu tildă, deci
"a~*b"nu putea potrivi o steluță literală - O mască malformată, precum o paranteză neînchisă, ridica o excepție pe care apelantul o înghițea drept „nicio potrivire”, transformând o greșeală de tastare într-un total tăcut greșit
- Pe partea de căutare,
MATCHșiXLOOKUPtratau doar~*,~?și~~ca escape-uri, deciMATCH("a~b",…,0)găsea literalula~bîn loc deab
Dacă workbook-urile voastre au folosit doar * și ? pe date alfanumerice simple, rezultatele erau deja corecte și nu se vor schimba. Dacă conțin paranteze, tildes, coloane de tipuri mixte sub "<>text", sau criterii DSUM scrise drept cuvinte nud, recalcularea lor cu v2.384.64 sau mai nou poate schimba totalurile, iar totalurile noi sunt cele pe care le arată Excel. Aceeași distincție între cum stochează Excel un criteriu și cum îl compară apare și la filtrele salvate, discutate în articolul HotXLS despre criteriile DOPER AutoFilter BIFF8
Referință rapidă: regulile wildcard Excel în HotXLS
COUNTIF,SUMIF,AVERAGEIFși familia*IFSfolosesc wildcard-uri doar când criteriul conține*sau?; altfel compară șiruri întregi fără sens la majuscule și~e literal (din v2.384.52)MATCHcu tip de potrivire 0 șiXLOOKUPcu match_mode 2 folosesc întotdeauna wildcard-uri, decia~bgăseșteabiar literalul are nevoie dea~~b(din v2.384.52)- În modul wildcard
~scapă orice caracter următor, iar o~finală e aruncată;[și]sunt caractere obișnuite "<>text"numără numere, boolean-i, erori și celule goale; un"<>"nud numără celulele non-gole, rezultatele=""incluseDSUMși celelalte funcții de bază de date tratează textul simplu drept „începe cu”;=textși<>textcompară întreaga intrare (din v2.384.64)- Find pe celulă întreagă cu
lxfUseWildcardsșilxfWholeCellface backtrack, decia*bpotriveșteabcb; Find și Replace tratează~ca escape pentru orice caracter (din v2.384.60) - Ordinea textului în criteriile
>și<urmează collation-ul word sort al Excel-ului, punctuația înaintea literelor (din v2.384.67)
Compatibilitatea Excel într-un motor de formule e în mare parte cazuri limită ca astea, măsurate contra Excel-ului, nu ghicite din documentație. HotXLS evaluează COUNTIF, MATCH, XLOOKUP, DSUM și restul bibliotecii de funcții nativ în Delphi și C++Builder, în ambele motoare, clasic și XLSX, fără Excel instalat. Detalii, ediții și descărcarea de probă sunt pe pagina componentei HotXLS Delphi spreadsheet