Un nume definit care se referă la o coloană întreagă este citit de Excel ca o singură celulă atunci când apare într-o poziție scalară: =Vertical+1 în rândul 7 înseamnă „celula de pe rândul 7 din Vertical”, nu întreaga zonă. HotXLS Delphi Component aplică acea intersecție implicită în v2.382.4 la două niveluri, în timpul evaluării și în timpul extragerii dependențelor, pentru că un șablon de credit cu 4805 formule a arătat că a obține valoarea corectă nu este suficient. Când walker-ul de dependențe extinde numele la întreaga lui zonă, o formulă din aval care alimentează orice celulă din acea zonă închide un ciclu care nu există, iar TXLSXWorkbook.Recalculate refuză tot registrul
Șablonul în cauză este un registru standard de amortizare a unui credit. Cu fiecare valoare din cache otrăvită la 777 și cu o rulare completă de Recalculate, ambele arhitecturi de motor au întors 23, adică lxErrorRef, codul de referință circulară. 3842 din cele 4805 formule nu se potriveau cu așteptarea independentă, B18 conținea #VALUE!, E18 era încă 777, iar numărul de plăți din J7 citise valorile substituent din coloana de sold neterminată. Trei defecte separate se ascundeau în spatele unui singur cod de retur, iar acest articol le parcurge pe fiecare, împreună cu sursa care l-a reparat
De ce o referință scalară la un nume de coloană creează un ciclu fals?
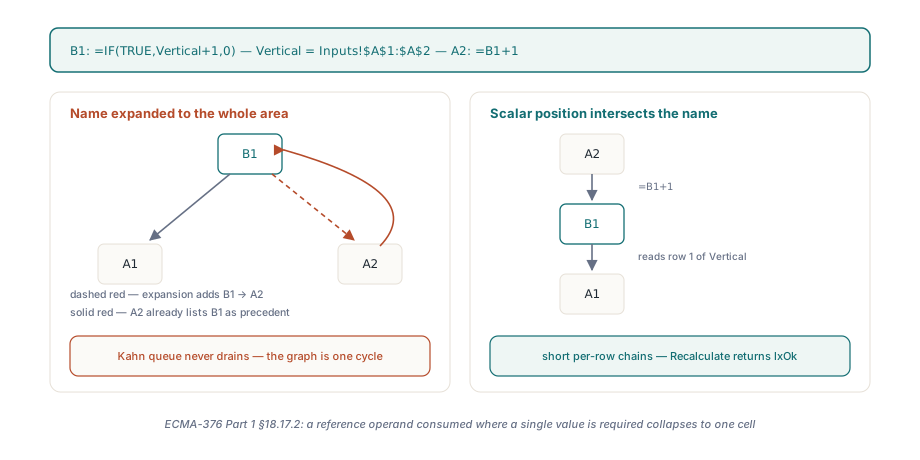
Pentru că un graf de dependențe cunoaște doar muchii, iar o muchie de la o formulă la o zonă de 480 de rânduri înseamnă 480 de muchii, dintre care una duce înapoi printr-o celulă care depinde de formulă. Luați =IF(TRUE,Vertical+1,0) în B1, cu Vertical definit ca Inputs!$A$1:$A$2, și =B1+1 în A2. Excel evaluează B1 ca A1+1 și A2 ca B1+1, un lanț drept. Un walker care înregistrează B1 ca depinzând de A1:A2 face din A2 un precedent al lui B1, iar A2 listează deja B1 ca precedent, așa că coada Kahn care conduce recalcularea incrementală în HotXLS nu vede niciunul dintre noduri ajungând la grad de intrare zero. Acesta este tiparul din care sunt făcute șabloanele de credit: fiecare rând de perioadă referențiază coloane cu nume pentru sold, rată și numărul de plăți, fiecare nume acoperă tot scadențarul, iar fiecare rând scrie și în acele coloane. Extindeți numele și graful devine o singură componentă tare conexă uriașă. Evaluați-le cu intersecție implicită și graful devine un set de lanțuri scurte, unul pe rând, exact ce descrie ECMA-376 Part 1 §18.17.2 pentru un operand de referință consumat acolo unde se cere o singură valoare
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Poziție scalară: Vertical se restrânge la A1 pentru că formula este pe rândul 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Un nume a cărui definiție este alt nume tot se intersectează, deci acesta este A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argument de clasă referință: se însumează toată zona, fără intersecție
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Rândul 6 este în afara lui A1:A2, intersecția este goală și IFERROR o prinde
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Înainte de v2.382.4 această ramură era inaccesibilă: B1 -> A2 -> B1 era un ciclu
    end;
  finally
    Book.Free;
  end;
end;
Cum decide HotXLS că un argument este scalar?
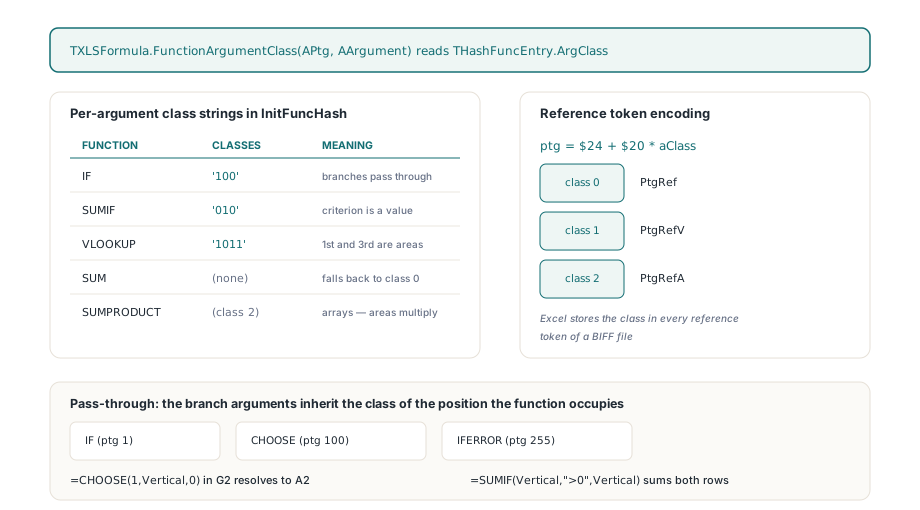
HotXLS citește răspunsul din tabelul de funcții, nu din forma argumentului. Fiecare intrare din TXLSFormula.InitFuncHash este înregistrată prin THashFunc.SetValue cu un șir opțional de clasă pe argument: 'IF' poartă '100', 'SUMIF' poartă '010', 'VLOOKUP' poartă '1011', iar 'SUM' nu poartă niciunul, așa că toate argumentele ei cad pe clasa 0 de la nivel de funcție. Noul TXLSFormula.FunctionArgumentClass(APtg, AArgument) expune acel octet prin THashFuncEntry.ArgClass, iar un rezultat de 1 înseamnă clasă de valoare. Sunt aceleași trei clase pe care [MS-XLS] §2.2.2 le atribuie token-urilor de operand, iar encoder-ul depindea deja de ele: când scrie o referință, calculează ptg-ul ca $24 + $20 * aClass, ceea ce dă PtgRef pentru clasa 0, PtgRefV pentru clasa 1 și PtgRefA pentru clasa 2. Un fișier BIFF scris de Excel stochează acea clasă în fiecare token de referință, așa că un motor al cărui tabel respectă specificația poate răspunde la „este acest argument scalar” fără să se uite la date. Argumentul din mijloc al lui SUMIF este criteriul, o valoare; primul și al treilea sunt zone, referințe. SUMPRODUCT este înregistrat cu clasa 2 la nivel de funcție, array, motiv pentru care =SUMPRODUCT(Vertical,Vertical) înmulțește în continuare toată zona
Trei funcții nu consultă propria intrare din tabel pentru nimic dincolo de primul argument. IF (ptg 1), CHOOSE (ptg 100) și IFERROR (ptg 255) trec mai departe ce selectează, așa că argumentele lor de ramură moștenesc clasa poziției pe care o ocupă funcția însăși. Acea singură regulă este ce permite ca =CHOOSE(1,Vertical,0) din G2 să se rezolve la A2, în timp ce =SUMIF(Vertical,">0",Vertical) de lângă el însumează în continuare ambele rânduri, și este regula pe care o exercită cel mai des un scadențar de amortizare, pentru că celulele lui de perioadă se bizuie pe IF ca să testeze dacă creditul mai este deschis
Cum se transportă clasa prin parcurgerea dependențelor
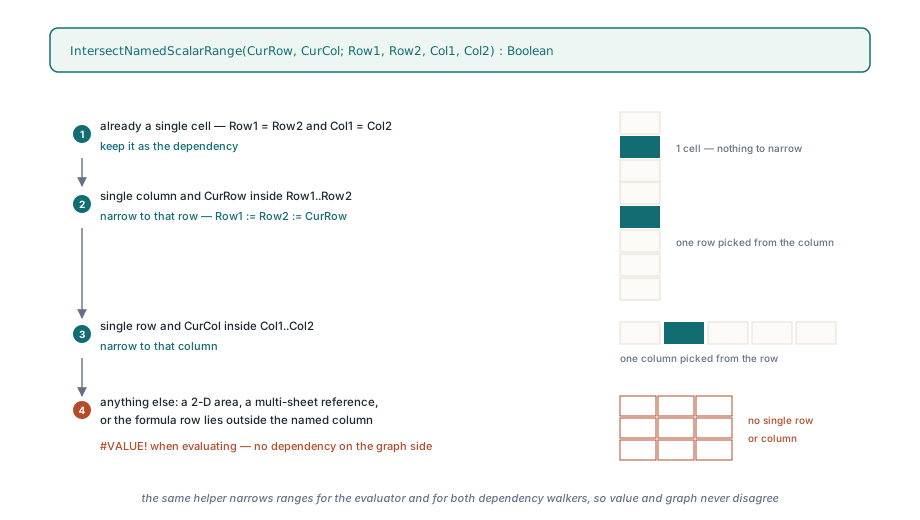
Extractorul de dependențe din lxCalc.pas este un Walk recursiv peste arborele de sintaxă compilat și există de două ori, o dată în TXLSCalculator.ExtractDependencies pentru graful pe registru și o dată în ExtractWorkspaceDependencies pentru graful între registre. v2.382.4 le dă ambilor walkeri doi parametri în plus. AScalar pornește ca True la rădăcina unei formule, este recalculat pentru fiecare copil de funcție din FunctionArgumentClass și este transmis neschimbat pentru argumentele de ramură ale ptg 1, 100 și 255. ANameRoot devine True doar când walker-ul coboară în definiția compilată a unui nume și supraviețuiește doar prin nodurile SA_GROUP, parantezele, așa că un nume definit ca =A1:A2+1 nu este confundat cu o zonă simplă. Când ambele flag-uri sunt True la un nod SA_RANGE, AddResolvedRange îngustează zona cu același helper pe care îl folosește evaluatorul înainte de a înregistra dependența. Helper-ul este destul de scurt ca să fie citat integral
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // deja o celulă
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // o singură coloană: ia acest rând
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // un singur rând: ia această coloană
    Result := True;
  end;
end;
Orice respinge helper-ul — o zonă bidimensională, o referință pe mai multe foi sau o formulă al cărei rând se află în afara coloanei numite — produce #VALUE! pe partea de evaluare și nicio dependență pe partea de graf, exact ce face Excel pentru o intersecție goală. Partea de evaluare trăiește în TXLSCalculator.GetValueItemName: elimină învelișurile SA_GROUP din definiția compilată, iar dacă rădăcina este un SA_RANGE apelează GetRangeInfo, intersectează și aduce singura celulă prin FGetValue în loc să evalueze toată definiția. Referințele externe rămân pe calea veche, pentru că nu există un rând local față de care să se intersecteze. De unde vin de fapt stocarea și domeniul de vizibilitate ale unui nume este acoperit în articolul despre nume definite și formule între foi; aici contează doar ce face motorul odată ce numele se rezolvă
De ce a citit MATCH peste o coloană pe jumătate calculată valoarea 777?
Pentru că argumentul de matrice de căutare al lui MATCH este o referință de scanare, iar referințele de scanare au fost excluse deliberat din ordinea de evaluare. Articolul despre scanarea la căutare a introdus TXLSDepRange.LookupScan și s-a încheiat cu o secțiune numită „La ce renunțați excluzând muchiile de scanare din ordonare”: o formulă de căutare poate rula înainte ca fiecare celulă din intervalul ei să fi fost recalculată și poate citi valori învechite. Într-o sesiune interactivă asta converge la trecerea următoare. Într-o recalculare în lot a unui șablon otrăvit nu, iar PaymentCount, definit ca =MATCH(0.01,Balances,-1)+1, a citit substituenții 777 care mai stăteau în coloana de sold și a întors un număr de perioade care nu putea fi corect
TXLSDepGraph.TopoOrder tratează acum muchiile de scanare ca muchii de ordonare slabe. Alături de gradul de intrare strict ține un tablou ScanInDeg, care numără precedentele de scanare murdare pe nod și îl decrementează pe măsură ce acele precedente sunt emise, folosind listele ScanPrecedents, ScanDependents și ScanPrecedentCount pe care modificarea anterioară le stoca deja. La fiecare iterație, coada Kahn își caută fereastra de noduri gata pentru primul nod al cărui ScanInDeg este zero și îl comută în capul listei; dacă toate nodurile gata așteaptă încă un precedent de scanare, capul este scos în ordinea lui stabilă. Muchiile de scanare nu intră niciodată în gradul de intrare strict, așa că un VLOOKUP auto-referențial peste propria coloană este în continuare legal, dar o căutare care ar putea aștepta un precedent finisabil o face acum. Regresia care fixează acest comportament, LookupScan_WaitsForDirtyFormulaValues, otrăvește trei celule de sold la 777 și așteaptă ca PaymentCount să vină înapoi ca 3, apoi comută intrarea la zero și așteaptă ca =IFERROR(PaymentCount,99) să vadă #N/A și să întoarcă 99
De unde venea trunchierea la patru zecimale?
Din aritmetica Variant din Delphi, și doar în poziții imbricate. Operatorii binari din TXLSCalculator.GetValueItem copiau deja un + sau un - de la nivel superior în două variabile locale Double, așa că =B1-A1 era în regulă. În interiorul lui =IF(TRUE,B1-A1,0) aceeași scădere rula ca Value := Value - SubValue pe doi Variant, iar când un operand era o valoare de celulă Int64 și celălalt un Double, rezultatul pe care l-am observat era un Currency, un tip în virgulă fixă cu patru zecimale, așa că 1066.1854641400994 minus 120 revenea trunchiat la patru zecimale. De-a lungul unui scadențar în care fiecare plată se compune din rândul anterior, acea eroare parcurge sute de perioade înainte de a ajunge la totaluri
// TXLSCalculator.GetValueItem, ramura de aritmetică binară (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Aritmetica Variant mixtă Int64/Double poate promova la Currency.
// Aritmetica de foaie de calcul trebuie să păstreze precizia în virgulă mobilă.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Protecția rulează înainte de SA_ADD, SA_SUB, SA_MUL și SA_DIV deopotrivă, iar regresia Arithmetic_MixedInt64AndDoubleKeepsPrecision stochează Int64(120) în A1 și 1066.1854641400994 în B1, apoi verifică diferența și suma imbricate la 1E-10, iar produsul și câtul la 1E-8 și 1E-12. HotXLS nu pretinde că știe fiecare regulă de promovare pe care RTL-ul o aplică tipurilor Variant mixte de-a lungul versiunilor de compilator; pretinde că aritmetica de foaie de calcul este IEEE double și face acum ambii operanzi double înainte ca operatorul să-i vadă, ceea ce elimină întrebarea
Ce garantează reparația și ce nu garantează
După v2.382.4, ambele arhitecturi de motor întorc lxOk pentru șablonul otrăvit, toate cele 4805 valori din cache se potrivesc cu așteptarea independentă rând cu rând în limita 1E-7, iar aserțiunile că valorile din cache chiar au fost otrăvite, că hash-ul sursei este neschimbat și că fiecare formulă este încă prezentă se susțin toate. Nu s-a activat nicio iterație și nu s-a suprimat niciun cod de eroare pentru a ajunge acolo. Un ciclu autentic prin intermediul unui nume, =B1 în A1 cu B1 care citește în continuare Vertical, întoarce în continuare o eroare, iar testul NamedScalarRanges_IntersectWithoutFalseCycles se încheie asertând exact asta
Limitele merită spuse răspicat. Intersecția implicită se aplică doar unui nume a cărui definiție compilată, după eliminarea parantezelor, este o zonă de o singură coloană sau de un singur rând de pe o foaie; un nume bidimensional într-o poziție scalară este #VALUE!, ca în Excel, iar o funcție pe care tabelul nu o cunoaște primește clasa 0 de la FunctionArgumentClass, așa că argumentele ei de nume sunt în continuare extinse integral. Ordonarea slabă este o preferință, nu o garanție: un ciclu doar de scanare se evaluează în continuare în ordine stabilă și citește ce este în cache, comportamentul pe care articolul despre scanarea la căutare l-a acceptat în mod deliberat. Iar rezultatul pe tot șablonul este verificat față de un script de așteptare independent, nu față de un alt motor de foaie de calcul, pentru că suita de birou de referință nu a terminat de recalculat șablonul original într-un buget de 60 de secunde. HotXLS este o componentă nativă de foaie de calcul pentru Delphi și C++Builder care citește, recalculează și scrie XLS, XLSX, ODS și CSV fără Excel instalat; intersecția de nume, tabelul de clase de argument și ordonarea slabă de scanare se aplică fiecărui format pentru că motorul de calcul este partajat, iar acoperirea actuală de funcții este listată pe pagina produsului HotXLS Delphi spreadsheet component