HotPDF rulează Tesseract în interiorul procesului Delphi al tău prin HPDFCreateTesseractDLLOCREngine, o fabrică adăugată în v2.772.0 care încarcă dinamic un DLL compatibil Tesseract 5, îi conduce C API-ul (TessBaseAPIInit2, TessBaseAPIRecognize, iteratorul de rezultate) și întoarce un IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer folosește motorul acela ca să adauge un strat de text Unicode invizibil și căutabil paginilor PDF scanate
Același recunoscător era deja accesibil prin adapter-ul extern tesseract.exe care scrie un BMP și parsează TSV. Calea aceea funcționează, dar fiecare pagină plătește un lansare de proces, un fișier bitmap temporar și un format de text fără baseline-uri și fără control asupra segmentării de pagină. Apelarea DLL-ului elimină toate trei. Elimină și peretele de proces, ceea ce înseamnă că o legătură Pascal stă direct deasupra structurilor C, a boolean-urilor C și a șirurilor alocate de C. Cea mai mare parte din ce merită știut despre acest adapter e locul unde legătura aceea poate merge prost pe furiș
Cum rulezi Tesseract în proces din Delphi cu HotPDF?
Rularea Tesseract în proces cu HotPDF cere un apel de fabrică în unitatea HPDFTesseractRecognition și același apel ApplyLoadedOCRTextLayer pe care îl folosește fiecare motor OCR HotPDF. Fabrica validează nerăbdătoare. Fișierul DLL și directorul tessdata trebuie să existe, identificatorul de limbă poate conține doar litere ASCII, cifre, _ și +, fiecare model dintr-o combinație precum chi_sim+eng trebuie să aibă un fișier .traineddata potrivit, iar toate cele 21 de exporturi cerute trebuie să se rezolve înainte ca motorul să fie întors. Greșelile de configurare ridică EArgumentException; un DLL care eșuează la încărcare ridică EOSError cu codul de eroare Windows și o sugestie de a verifica arhitectura și dependențele
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // O aplicație Win64 are nevoie de un DLL pe 64 de biți; DLL-urile de dependență stau lângă el
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // O listă de pagini goală înseamnă toate paginile; paginile care au deja text sunt sărite
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default setează PageSegMode la tpsAuto, EngineMode la temDefault, TimeoutMilliseconds la 60.000 și MaxPixels la 16.777.216. Bugetul de pixeli contează mai mult decât pare. O pagină US Letter la 300 DPI implicit randează în 2.550 × 3.300 de pixeli, cam 8,4 milioane, ceea ce încap. Aceeași pagină la 600 DPI e 5.100 × 6.600, cam 33,7 milioane, iar adapter-ul o respinge înainte ca Tesseract să vadă un pixel. Ridicați MaxPixels (plafonul e 67.108.864) sau lăsați DPI-ul unde e; fiecare latură e plafonată și la 32.767 de pixeli
DLL-ul e încărcat cu LoadLibraryEx cu flag-urile de căutare pentru folderul propriu al DLL-ului plus directoarele sigure implicite, astfel încât bibliotecile de imagini de care depinde Tesseract pot sta lângă el fără a atinge PATH sau directorul curent. HotPDF nu include și nu descarcă niciun runtime sau model OCR; le provizionați pe ambele
Ce se schimbă față de adapter-ul tesseract.exe?
Adapter-ul DLL schimbă izolarea de proces pe output mai bogat și cost per pagină mai mic. Ambele adaptere se prind în același pipeline de strat de text, deci maparea de coordonate, filtrarea după confidence și comiterea tot-sau-nimic sunt identice; ceea ce diferă e felul în care pixelii intră și cuvintele ies
| Aspect | adapter tesseract.exe | adapter Tesseract DLL |
|---|---|---|
| Fabrică | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| Pixeli la intrare | Fișier BMP într-un director temporar privat | Buffer în scale de gri pe 8 biți în memorie |
| Cuvinte la ieșire | TSV la nivel de cuvânt, plafonat la 64 MiB | Iterator de rezultate, UTF-8 per cuvânt |
| Baseline-uri | Indisponibile | Transmise mai departe din TessPageIteratorBaseline |
| Segmentare de pagină și mod de motor | Doar segmentare automată | THPDFTesseractPageSegMode, THPDFTesseractEngineMode |
| Timeout | Dur: procesul copil e terminat | Cooperativ: Tesseract trebuie să observe |
| Izolare de blocare și de memorie | Proces separat | Nicio, partajează address space-ul tău |
Un cost nu dispare. Fiecare apel Recognize își creează propria instanță API și apelează TessBaseAPIInit2, deci modelele de limbă sunt inițializate per pagină, nu o dată per motor. Cache-ul de fișiere al sistemului de operare înmoaie reîncărcarea, dar pe seturi mari de modele multilingve rămâne costul fix dominant per pagină și se numără contra termenului limită de recunoaștere. Motorul DLL RapidOCR în proces ia design-ul opus și își ține modelele ONNX rezidente toată durata de viață a motorului; problemele de frontieră (C ABI, buffere împrumutate, muncă nativă neîntreruptibilă) sunt din aceeași familie
De ce nu poate Delphi copia structura monitor Tesseract?
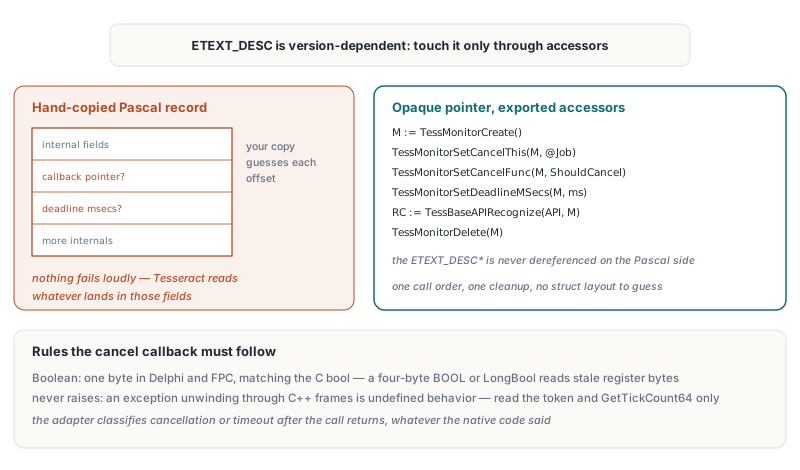
Delphi nu poate oglindi în siguranță monitorul de progres Tesseract pentru că ETEXT_DESC conține câmpuri interne dependente de versiune, deci un record copiat de mână pune callback-ul de anulare și termenul limită la offset-uri greșite pe unele build-uri. Nimic nu eșuează zgomotos când se întâmplă asta. Tesseract pur și simplu citește pointer-ul de callback dintr-un câmp care acum ține altceva, sau nu vede deloc termenul limită
HotPDF tratează deci monitorul ca pointer opac și îl atinge doar prin funcții exportate: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs și TessMonitorDelete. Dacă legați C API-ul singuri pentru alt scop, același tipar se aplică. Schița de mai jos e codul propriu de legătură, nu un API HotPDF și oglindește declarațiile pe care HotPDF le folosește intern
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, niciodată dereferențiat
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Rulează pe stack-ul Tesseract: citește flag-uri și ceasul, nu ridica niciodată
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// Utilizare, cu pointerii de funcție rezolvați prin GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
Două detalii din schița aceea sunt deliberate. Callback-ul întoarce Boolean, care e un octet atât în Delphi, cât și în Free Pascal, potrivit cu bool-ul C din TessCancelFunc. BOOL-ul Windows de patru octeți sau LongBool-ul Delphi pare interschimbabil și nu e: când o parte scrie un singur octet, iar cealaltă citește patru, octeții înalți ai registrului de retur sunt ce a mai rămas acolo, iar un false poate ajunge true. Același header complică lucrurile și mai departe, pentru că funcții precum TessPageIteratorBoundingBox întorc un int, pe care HotPDF îl declară ca Integer. Citiți tipul C al fiecărei valori de retur în loc să presupuneți o singură convenție pentru tot API-ul
Al doilea detaliu e că callback-ul nu ridică niciodată. O excepție Delphi care face unwinding prin frame-urile C++ ale Tesseract e comportament nedefinit, deci callback-ul HotPDF citește doar token-ul de anulare și o valoare monotonă GetTickCount64. Adapter-ul transformă rezultatul într-un diagnostic de anulare sau de timeout după ce TessBaseAPIRecognize revine și face verificarea aceea indiferent de codul de retur nativ
Ce pointeri nativi deține partea Delphi?
Adapter-ul DLL Tesseract din HotPDF deține trei obiecte native per cerere, instanța API, monitorul și iteratorul de rezultate, iar tot restul e împrumutat. Fiecare apel Recognize își creează propriul set și îl eliberează într-un bloc finally: TessResultIteratorDelete, apoi TessMonitorDelete, apoi TessBaseAPIDelete. Eliberarea interfeței motorului descarcă biblioteca
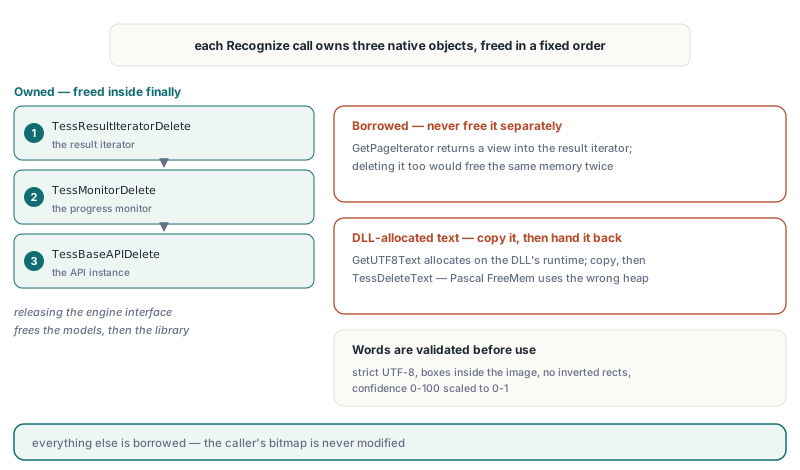
TessResultIteratorGetPageIteratorîntoarce o vedere împrumutată în iteratorul de rezultate, nu un obiect nou. HotPDF îl folosește pentruTessPageIteratorBoundingBoxșiTessPageIteratorBaselineși nu-l eliberează niciodată; ștergerea lui separată ar elibera aceeași memorie de două oriTessResultIteratorGetUTF8Textîntoarce un șir alocat de runtime-ul propriu al DLL-ului. HotPDF îl copiază și îl predă înapoi prinTessDeleteTextîntr-un blocfinally;FreeMemPascal l-ar elibera pe heap-ul greșit- Textul cuvintelor e decodat cu validare strictă UTF-8 și verificat de lungime înainte de conversie. Cuvintele cu caractere de control, UTF-8 malformat, casete în afara imaginii, dreptunghiuri inversate sau confidence în afara lui 0-100 eșuează cererea în loc să fie împatchuite în tăcere
- Textul total per cerere e plafonat la 1.048.576 de unități de cod UTF-16, iar numărul de cuvinte trebuie să încapă în bugetul cererii transmis de
ApplyLoadedOCRTextLayer
Confidence-ul sosește ca 0-100 și e scalat la 0-1, astfel încât THPDFOCRTextLayerOptions.MinimumConfidence înseamnă același lucru pentru fiecare motor. Când Tesseract raportează un baseline, ambele capete sunt transmise mai departe; altfel pipeline-ul de strat de text cade înapoi pe estimarea lui geometrică, exact cum face pentru input TSV
De ce validezi un enum înainte să ajungă în DLL?
HotPDF copiază ordinalul raw al lui PageSegMode și EngineMode într-un Integer înainte de verificarea de interval, pentru că un compilator poate presupune că o variabilă enum deține mereu o valoare declarată și poate plia Ord(X) > Ord(High(T)) la constanta false. Ordinalele nu sunt decorare: THPDFTesseractPageSegMode urmează numerotarea de segmentare de pagină a lui Tesseract de la 0 la 13, THPDFTesseractEngineMode urmează numerotarea de mod de motor de la 0 la 3, iar ambele merg către DLL ca întregi simpli. Un record de opțiuni construit cu FillChar, umplut dintr-un stream sau pasat din C++Builder cu un întreg făcut cast poate cară un octet precum 200. Validarea ordinalului copiat transformă asta într-un EArgumentException la momentul fabricii în loc de un mod nedefinit în interiorul codului nativ. Fabrica respinge și tpsOSDOnly și tpsAutoOnly, care nu produc niciun cuvânt, și cere osd.traineddata pentru tpsAutoOSD și tpsSparseTextOSD
Ce garantează de fapt termenul limită de recunoaștere?
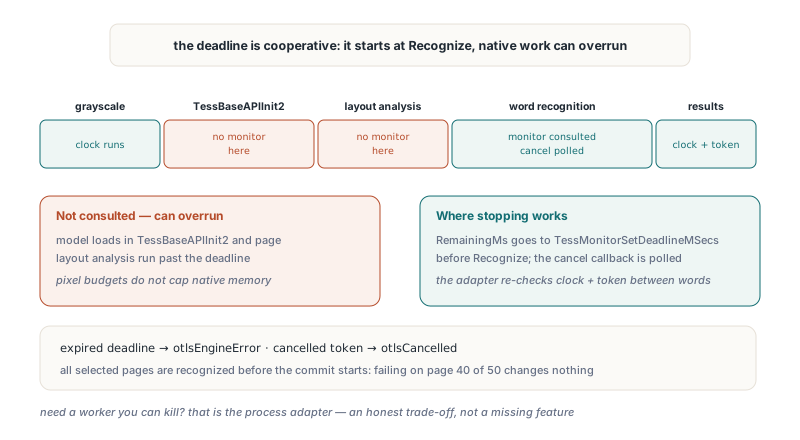
Termenul limită al DLL-ului Tesseract e cooperativ: HotPDF își poate opri propria muncă și poate cere lui Tesseract să se oprească, dar nu poate forța codul nativ să revină. Ceasul pornește când Recognize începe, deci conversia bitmap și inițializarea modelelor consumă același buget ca recunoașterea. HotPDF verifică timpul scurs și token-ul de anulare în timpul conversiei în scale de gri și între cuvinte cât timp iterează rezultatele, iar milisecundele rămase le pasa către TessMonitorSetDeadlineMSecs înainte să apeleze TessBaseAPIRecognize
Golul e în interiorul apelului nativ. Monitorul lui Tesseract e consultat în timpul recunoașterii cuvintelor, nu în timpul lui TessBaseAPIInit2 sau al analizei de layout, deci o încărcare lentă de model sau un layout patologic poate alerga peste termenul limită înainte ca timeout-ul să fie raportat. Bugetele de pixeli și de output nu plafonează nici ele consumul propriu de memorie al bibliotecii native. Dacă aveți nevoie de un worker pe care îl puteți ucide, folosiți adapter-ul de proces; asta e compromisul cinstit, nu o funcție lipsă
Segmentarea de pagină e locul unde adapter-ul DLL își câștigă salariul pe input-ul dificil. Formularele, etichetele și tabelele scanate cu câmpuri împrăștiate se recunosc adesea mai bine cu tpsSparseText decât cu segmentarea automată, care încearcă să asambleze coloane și paragrafe care nu există
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // câmpuri împrăștiate, fără asamblare de coloane
  TessOptions.EngineMode := temLSTMOnly;     // cere modele LSTM în tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // include inițializarea modelelor
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Un timeout iese la suprafață ca otlsEngineError cu diagnosticul Tesseract DLL OCR timed out, în timp ce un token anulat iese ca otlsCancelled. În ambele cazuri ApplyLoadedOCRTextLayer a recunoscut fiecare pagină selectată înainte să pornească tranzacția de comitere, deci un eșec la pagina 40 din 50 lasă documentul încărcat exact cum era. Rețineți că tpsSingleLine, tpsSingleBlock și tpsSparseText schimbă doar segmentarea; niciunul nu îndreaptă un scan înclinat
Free Pascal și Lazarus: pixeli învechiți și chineză pierdută
Ambele fabrici Tesseract funcționează în build-urile Free Pascal și Lazarus Win32 și Win64 Windows din v2.772.1, după două reparări specifice FPC. Reconstruiți mai întâi pachetul Lazarus pentru arhitectura țintă; portarea generală e acoperită în HotPDF pe Free Pascal și Lazarus Win64
Prima reparare privește pixelii. Un TBitmap LCL scris prin scanline-uri își poate actualiza imaginea raw fără să reîmprospăteze handle-ul Windows de bitmap, astfel încât GetDIBits pe handle-ul acela întoarce pixelii vechi. Simptomul era de neînțeles: textul desenat direct pe un bitmap era recunoscut, în timp ce o pagină randată de renderer-ul PDF HotPDF producea o listă de cuvinte goală. Pe FPC adapter-ul citește acum un snapshot conștient de format prin CreateIntfImage, care respectă formatul de pixel și ordinea de rânduri a imaginii raw. Build-ul Delphi păstrează calea GetDIBits pe o copie privată pe 24 de biți. Niciun build nu modifică bitmap-ul apelantului
A doua reparare aparține adapter-ului tesseract.exe. TStringList-ul FPC stochează șiruri ANSI, deci asignarea textului TSV decodat UTF-8 către Lines.Text arunca în tăcere fiecare caracter chinezesc sau din planul suplimentar pe care code page-ul ANSI de sistem nu-l putea reprezenta. Calea FPC păstrează acum TSV-ul ca octeți UTF-8, taie BOM-ul la nivel de octet și decodează fiecare cuvânt în UnicodeString individual. Adapter-ul DLL n-a avut niciodată problema aceasta pentru că decodează fiecare cuvânt direct din iterator
Referință rapidă
- Fabrica:
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])înHPDFTesseractRecognition, adăugată în v2.772.0, suport FPC în v2.772.1 - Implicite:
tpsAuto,temDefault, 60.000 ms, 16.777.216 de pixeli; interval de timeout 1-3.600.000 ms, plafon de pixeli 67.108.864 - Potriviți bitness-ul DLL-ului cu aplicația și plasați DLL-urile de dependență lângă DLL-ul Tesseract
- Tratați monitorul ca opac; nu copiați niciodată
ETEXT_DESCîntr-un record Pascal - Declarați callback-ul de anulare
cdeclcu un rezultatBooleande un octet și nu lăsați niciodată o excepție să scape din el - Eliberați textul iteratorului cu
TessDeleteText; nu eliberați niciodată iteratorul de pagină obținut din iteratorul de rezultate - Așteptați-vă ca termenul limită să fie cooperativ: inițializarea modelelor și analiza de layout îl pot depăși
- Folosiți adapter-ul tesseract.exe când aveți nevoie de terminare dură sau de izolare de blocare
Adapter-ul Tesseract DLL, adapter-ele de proces și motorul OCR integrat se livrează toate cu componenta HotPDF Delphi PDF pentru Delphi, C++Builder și Free Pascal; veziți pagina de produs HotPDF pentru ediții și descărcări